

机器人想学个新动作,通常要先采数据。
再训一遍模型。
费时。
也费人。
现在有一家说,看一遍示范就够。
关键不在看。
在经验能不能留下来。
这家叫流形空间。
它的智能体在 RoboDojo 榜单上排第一。
这是比机器人动手能力的榜。
跟平时的 AI软件排行榜不是一回事。
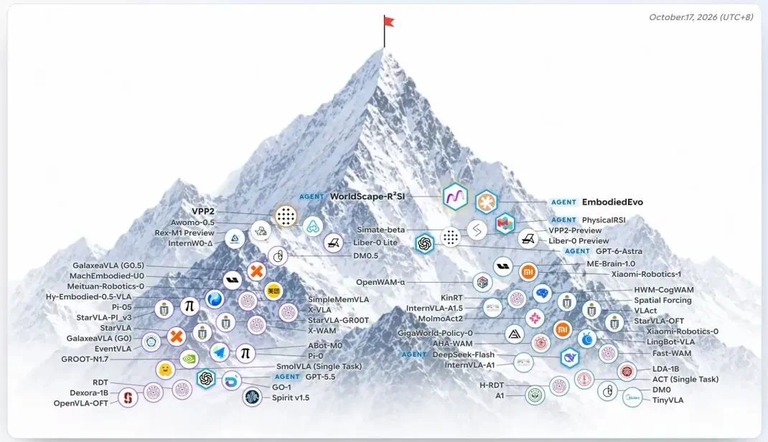
榜单截图,RoboDojo 总榜上排着各家模型。
被它压住的两个对手不弱。
一个是我们眼下最强的闭源模型。
一个是英伟达的机器人模型。
三个月前,它发过一版世界动作模型。
主打的是上下文学习。
模型不动参数,靠一次示范适应新任务。
之后两家海外公司也跟上了。
一家发了自己的新一代具身模型。
一家发了第一版。
路子基本一样。
Manifold AI 的发布卡,写着 Announced 和七月。
从一次示范里学新活,是机器人进真实世界的一条路。
光靠这个不够。
模型自己也得会改。
围绕这点,这家提了一套框架。
名字叫 R²SI。
翻成中文是机器人递归自进化。
里面套着两层智能体。
内层负责干。
外层负责复盘。
复盘出来的东西,回头改模型和系统。
先看榜单怎么评。
RoboDojo 看的是机器人动手能力。
双臂操作,长程任务,记忆,泛化,精细动作。
还有一条硬要求。
必须在规定的动作步数里做出进展。
这次评测,这套系统总分第一。
撑住成绩的是两块东西。
一块是上下文学习。
管的是不做后训练时,怎么靠一次人类示范学会新任务。
另一块就是那套自进化框架。
管的是多次执行里怎么越做越好。
两块合起来是一件事,把现有能力用足。
做 AI工具 的人,看这套内外两层会眼熟。
上下文学习这块,要从今年七月说起。
当时发 2.0,先抛了个问题。
面对新任务,能不能不重训模型。
只看一遍人类示范就完成。
问题背后是真实场景的麻烦。
指令说得含糊。
要动的东西五花八门。
几个任务随机拼在一起。
干到一半环境还变了。
人习惯了,机器不行。
机器碰上这些,就得再采数据。
再训练,或者微调。
上下文学习换了个做法。
把示范当成上下文塞进去。
执行时照着学,参数一点不动。
碰上这类活,与其硬试,不如先看一遍示范。
听上去简单。
做起来有两个坎。
示范里哪些动作能拿走。
拿走的部分怎么套到新东西上。
这家给的答案是 2.5 版本。
能力摊成三层。
动作迁移是一层。
技能组合是一层。
零样本干长任务又是一层。
这三层,做 AI编程 的人听着也不陌生。
官方登顶海报,画面写着 WorldScape Policy ICL。
先看第一层,讲的是搬家。
物体换了规格,动作还能接着用。
盖章那段的动图,同一个动作换到不同印章上。
盖章这个例子最直白。
看过一遍示范,机器人换个颜色的印章也能盖。
印章形状变了也行。
落款页换了位置、换了材质,照样能落下去。
它抓的不是某个固定动作。
是能搬走的那套操作方式。
穿鞋带那段的动图,几个阶段连着做下来。
穿鞋带这类活更麻烦。
从抓起鞋子到松开鞋带,中间好几个阶段。
每个阶段的动作都不一样。
前一个没做好,后一个就接不上。
它得看着眼前的情况调。
这类题考的不是重复一个动作。
是能不能把会的技能重新排一遍。
排完还能顺下来。
长任务那段的动图,前一步做完接着下一步。
长活最容易崩在细节上。
前一步偏一点,后面跟着偏。
流程就断了。
这套模型加了两种记忆。
一种记画面,一种记发生过的事。
环境变了、进度到哪了,都留着。
实验结果这边,只挑三个数说。
见过的任务,它已经超过常见的视觉语言动作模型。
没见过的任务,差得更远,成功率能差好几倍。
这个差距才是关键。
EVALUATION 里 Seen Tasks 的对比,横轴是训练步数。
Unseen Tasks 这组,训练任务越多,两条线拉得越开。
机器人落地,现场很少和训练时一样。
货架高度会变。
包装会换。
同一个箱子,今天摆左边,明天摆右边。
只靠背题,换一间仓库就废。
能现场看一眼就调整,才是能用的本事。
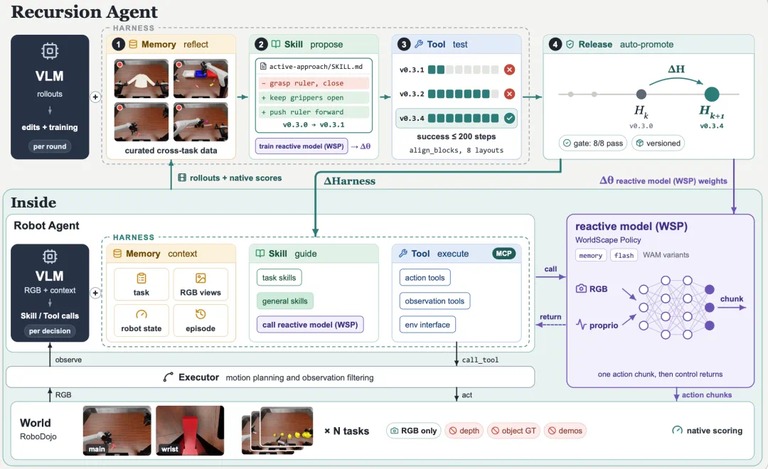
架构图里能看到 Recursion Agent 和 Robot Agent 两层。
R²SI 这块,起点很朴素。
机器人每干一次活,都会留下信息。
抓取失败了,接近方向可能错了。
推移没到位,接触高度得改。
活干成了,步数花太多也是浪费。
这些经验不复用,下次还得错一遍。
在这家看来,能从反复执行里攒经验,才是真本事。
R²SI 就是冲这个来的。
它用两层智能体把执行和复盘接起来。
内层拿彩色图像和本体状态当上下文,还带着任务描述。
每一步靠一个按任务加载的技能去干。
调用那个世界动作模型,本身也是一项技能。
模型跑完一段动作就交还控制权。
内层再看一眼新情况,决定下一步。
外层跨轮次翻记录,改技能。
改完的版本要过一遍测试。
不过就不发。
过了才自动更新到内层,还要记进版本。
这一步跟 AI编程 里的自动重构很像。
改完先跑一遍测试,挂了就不合。
推 T 形块这个任务,最能说明外层怎么改。
机械臂要把 T 块沿桌面推进目标区域。
位置和朝向要对,接触状态也得对。
还要在 600 步内完成。
这一轮不用世界动作模型。
第一遍干砸了。
夹持方向选错了。
平移的同时还在转。
物体跟着明显偏。
对齐之后,夹爪一次松开。
物体又跑偏了。
一轮下来用了 723 步,超预算。
账面上看,步数超了两成。
实际上更麻烦的是它不知道自己错在哪。
外层就是补这一块的。
外层看完记录,改了三处。
夹持方向换一个。
平移和转向拆开,先平移,再分段转。
夹爪不一次松,分段放,每段看一眼有没有偏。
改完的版本过了测试,自动发到内层。
第二遍,596 步,拿到原生满分。
再迭代几轮,同一个布局降到 389 步。
比 596 步少了约三成五。
之后这个技能就冻住了,外层停更。
内层自己上。
只拿彩色图像和公开的机器人状态当观测。
三种随机布局,分别跑出 222 步,312 步和 256 步。
都是满分,都没超 600 步。
这三组数字说明一件事。
改出来的技能不是只会伺候一种摆法。
换了摆法,它自己看得懂。
第二个案例换成装箱。
这活外层给内层加载了一个技能。
技能的内容就是调用世界动作模型。
执行时,内层按观测去调。
模型跑完一段动作交还控制权。
内层看完新情况再决定下一步。
这么来回。
跑完这一轮,外层把记录整理成训练数据。
记录里有什么,就照着训什么。
哪一步偏了,哪一步反复了,都成样本。
拿去训那个模型。
训完的模型继续给内层用。
所以它一边干活,一边被外层教。
干得越久,攒的样本越多。
两个案例说的是同一套逻辑。
内层靠技能干活。
调用世界动作模型只是其中一种干法。
外层一直改技能,也改那个模型。
所有改动都得先过测试。
过了才自动发布,还要进版本管理。
试错的经验就这样沉下来,变成能复用的东西。
这里有个取舍值得说。
图省事,一次把技能改到底,风险大。
宁可小步改,改完就测,测过再发。
机器人在真实场景里,最怕一次改动把会的东西弄坏。
所以这套系统宁可慢半天,也不让一次冒进把底子掀翻。
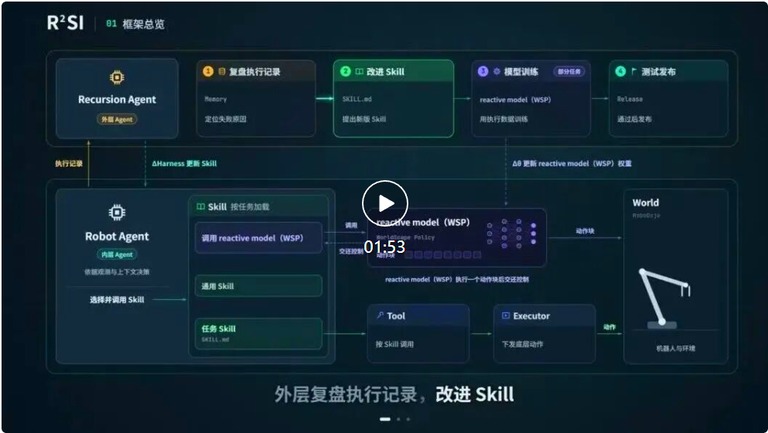
R²SI 框架总览,外层复盘执行记录,改完的技能再发下去。
回看这三个月。
2.0 试的是看一遍就会。
2.5 试的是动作能搬,技能能拼,长活能干完。
R²SI 再把执行和经验接起来。
这条路走通了,机器人才谈得上通用。
说句实在话,榜单第一只是一站。
仓库里,车间里,家里,情况比评测复杂得多。
货架会挪,包装会换,人还会临时改主意。
这套东西能搬到多少场景,还得看落地。
对做 AI工具 的人来说,这里有个更通用的启发。
智能体要真能自己变强,得有地方存经验。
还得有机制把经验变成下一次的动作。
光靠换个更大的模型,解决不了这件事。
这条思路,现在也用在不少 AI编程 助手上。
它们也在攒经验,只是攒的是你的习惯。
机器人攒的是怎么把东西推到位。
底子是一个东西。
