

三个项目一起开着。
文件在这边,记忆在那边。
干到一半,助手把两件事串成了一件。
这是很多人用 AI工具 的日常。
还有更烦的。
离开电脑十分钟。
任务就卡在原地,等你回来点下一步。
烧掉的词元倒是很实在。
清华一个自然语言处理实验室,联合面壁智能和一个开源社区,做了套系统。
名字叫 PilotDeck 2.0。
它盯的正是这几件事。
记忆怎么管,任务怎么跑,调用怎么省钱。
它把能力摊成四块。
同时开多个项目,各自有文件、记忆和任务。
长期记忆记住项目背景和你的偏好,能看也能改。
后台执行让长任务在你不看屏幕时继续跑。
智能路由按难度挑模型,难的给强的,简单的给便宜的。
这一套在 AI编程 里最用得上。
系统主视觉,画面印着 Pilot Every Agent。
先看数字。
在团队自建的智能体基准里,它配一个 35B 级别的开源小模型,拿到 79.1 分。
同一套题,另一家海外公司的编程助手是 77.3 分。
分差不算悬殊。
真正拉开的是账单。
让强模型管决策、小模型干杂活,长任务的成本能砍掉近六分之五。
任务卡示例,要求读 workspace 里八月考勤与请假表。
数字之外,是每天都会遇到的那种烦。
用久了的助手有个通病,叫上下文污染。
前脚在 AI对话 里聊完技术架构。
后脚让它写小红书文案。
张口还是架构解耦那套词。
这不是它笨。
是记忆做成了黑盒。
它记住了什么,什么时候记的,记在哪,屏幕这头的人一概不知道。
中途记错一个关键的业务逻辑,也很难查。
找不出问题,最后只能把整段会话废掉,从头再来。
各家都在这个问题上栽过。
有的靠更长的上下文硬扛。
有的靠人工定期清理。
都不彻底。
原文的架构示意图,画面没有文字,紧接在上下文污染那一段之后。
这套系统的底层单位叫工作舱。
可以理解成给助手划了一个独立工位。
每个项目有自己的文件系统、记忆库和技能集。
官方举的例子很直白。
A 舱里剪音视频,B 舱里做手机小游戏。
两边的记忆和检索空间物理隔开。
同时干几摊活,也不担心串台。
工作舱界面的动图,对话框里问 What’s on the plant today。
更实的改动在记忆本身。
它把记忆做成了白盒。
从生成到存储再到调用,整条链路对用户可见。
面板上能一条条看。
哪条偏好是哪次对话记下的,写得清楚。
记错了不用写一长串提示词求它忘掉。
可以直接改,也可以直接删。
重要那几条还能一键固定。
一段操作演示动图,画面只留下系统角标。
还有个叫做梦模式的机制。
助手空闲的时候,系统在后台把零散的交互记忆做归纳和提炼,顺手去重。
整理过程中丢了细节,能一键回滚。
秒级回到整理之前。
另一个是常驻执行。
关掉窗口,人离开电脑,任务照样在后台推进。
跑完把成果落成本地文件。
再附一份进展和总结。
又一段界面演示,对话框里还是那句 What’s on the plant today。
它对模型上下文协议是原生支持。
网页端和命令行里操作,后端行为一致。
在企业即时通讯里也一样。
开发者可以顺着现有工作流加工具和技能。
长期用的人,省下的主要是反复交代背景的时间。
到这里,省的都是麻烦。
真正劝退的是钱。
跑长任务,钱包先扛不住。
很多环节并不难。
排个版,套个模板,翻几段文字。
架构粗糙的系统会全程调用最贵的旗舰模型。
词元就这么烧掉了。
图省事的人,索性全程开着最贵的模型。
宁可前期多分一次任务,也别整条流程都跑顶配。
换个任务再演一次,画面上有 Paper。
它的做法叫智能路由。
底层先判任务难度,再把不同环节拆开分发。
复杂的规划决策交给顶配大模型。
执行和格式处理降级给轻量模型。
一次自媒体运营的实测很能说明问题。
全程跑顶配,单次费用 12.58 美元。
开了路由,主流程走顶配,润色降到中档。
费用落到 2.83 美元。
省下七成。
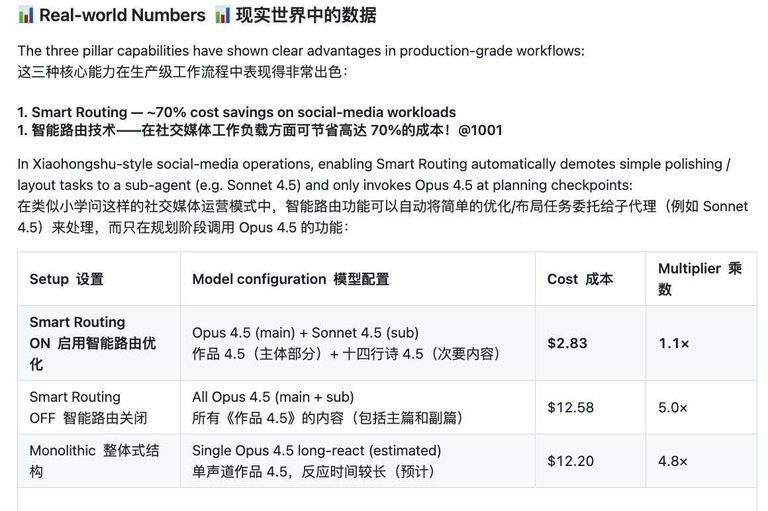
图面写着 Real-world Numbers,第一条就是智能路由省七成。
七个高难度任务的横评更能看出差距。
选题是播客多语言推送和多源数据报告,还有论文综述与代码库架构文档。
单跑一个便宜的小模型,成本 1.9 美元,得分只有 37.1。
没法用。
单跑一个中档模型,得分 69.1,一趟要烧 18.36 美元。
主强子弱的编排下,综合得分 70.6,成本 3.15 美元。
比纯顶配还好一点,钱只花了六分之一。
这就是它想讲的那件事。
贵不在任务本身,在谁去干。
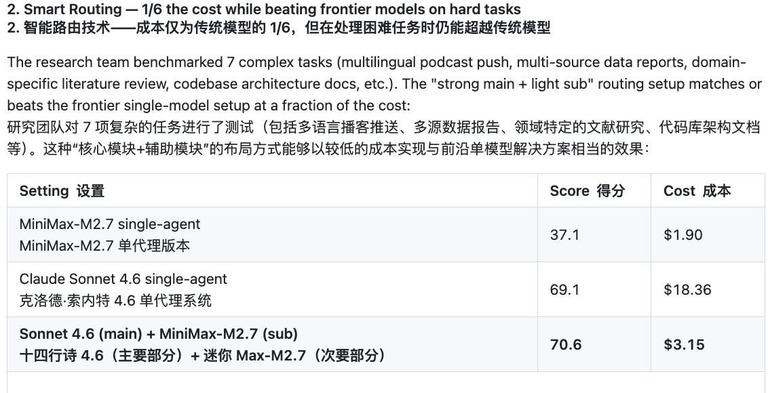
第二张同样标着 Smart Routing,成本只要六分之一。
许可用的是要求衍生作品同样开源的那一版。
三套主流桌面系统都能装,也给了容器化部署方式。
代码托管在一个开源社区,文档放在同一个仓库里。
