大模型开始抢搜索广告的饭碗:人大高瓴和斯坦福把拍卖写进逐词元生成

搜索结果里一旦出现 AI 摘要,用户点开普通网页的几率就几乎腰斩。

入口正在换。

美国皮尤研究中心分析过 Google 上大规模的用户浏览行为。有摘要时,点击传统结果的比例从 15% 掉到 8%。

对做AI工具的人来说,这不是一件小事。搜索流量一直是免费获客最大的那扇门。

用户的习惯也已经迁移。现在[……]

继续阅读

灵初 Psi-R2.5 发布:人类示范一遍,机器人不用重训就能学会新任务

两年前那段机器人炒虾的视频,很多人还有印象。

机械臂一手端锅,一手拿铲。虾翻两下,倒进碗里。动作谈不上利落,但像模像样。

为了让机器人学会这一套,研究人员得先上手操控。一遍遍采集真机示范,再用模仿学习喂给它。一个固定任务,大约要采 50 次。

这两年AI工具的迭代速度,大家早就习惯了。模型版本一周一[……]

继续阅读

高通第六代骁龙8双旗舰发布:2nm 制程,手机本地跑 300 亿参数大模型

骁龙峰会 2026 的现场在美国夏威夷毛伊岛。高通一口气端出两款 2nm 旗舰芯片。一款是第六代骁龙8超级至尊版。另一款是第六代骁龙8至尊版。

变化很大。

这是高通第一次在旗舰产品线上同时发两款骁龙8平台。也是骁龙平台第一次用上 2nm 制程。

过去两年,AI工具的主战场一直在云端。这一次,战场被搬[……]

继续阅读

Qwen4 已在训练,阿里把参数目标写到了 10 万亿

9 月 22 日的云栖大会,阿里把千问大模型的家底摊了一次。

摊出来的东西不少。参数和架构,开源和图像,音乐和语音,还有硬件。一条线一条线地过。

最扎眼的还是参数。

Qwen4 已经用全新架构进入训练。往后的 Qwen4.5 和 Qwen5,计划把总参数推到 5 万亿到 10 万亿。

这条老路,阿里[……]

继续阅读

Meta 的 AI 助手火了 13 天,亚马逊用一行弹窗把它拦在门外

9 月 21 日,一些美国用户用 Meta 推出的 Muse 逛亚马逊。屏幕上多了一行提示。大意是,未经授权的智能体继续访问,将违反这家电商巨头的使用条款。

距离 Muse 正式上线,只过了 13 天。
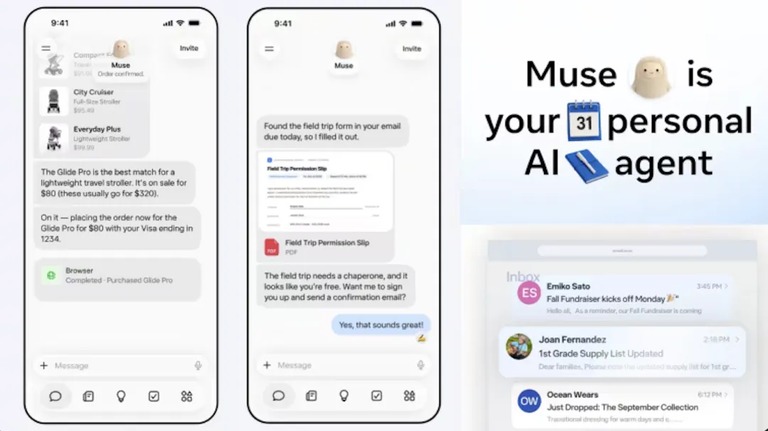
Meta 推出的个人 AI 助手 Muse

Muse 是 Meta 在 9 月 8 日推出的个人 AI 助手。它被定义为「全球第一款为所有[……]

继续阅读

十万张卡跑不出十万张卡的算力,超节点把 4096 张卡拼成一台计算机

先说一个让人心里发凉的数字。十万张卡的集群里,卡与卡之间的通信能吃掉四成以上的训练时间。真正拿去算东西的算力,往往不到三成。

这就是眼下大模型竞赛的尴尬。海外在冲十万亿参数,国内在追数万亿参数。为了训出更强的 AI工具,万卡集群早就不够看。十万卡正在变成新的门槛。

可卡堆得越多,有效算力并没有跟着涨[……]

继续阅读

把 Mac mini 当智能体服务器:一台小盒子同时跑四个 AI

从今年四月开始,Mac mini 慢慢成了「AI 电脑」这个词的默认答案。

苹果官网的 Mac mini 配置页,标着不同内存与存储规格的价格和分期金额

抢它的不只是个人用户,企业也在抢。OpenAI 买了几万台 Mac mini 和 Mac Studio 拿去训练模型。Anthropic 则在亚马逊云上租了一大批 Mac 服务器。
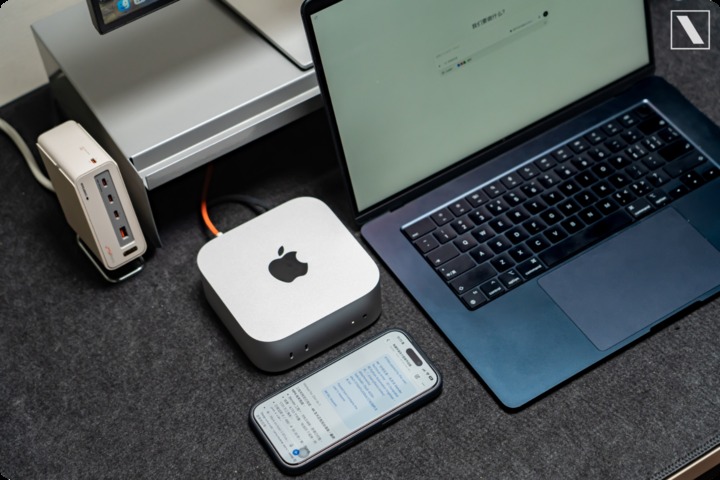
原文配图

于是竞争的焦点换了。以前比的是能不能跑[……]

继续阅读

DQN为什么离不开经验回放:一次小实验把两个经典组件拆开了

深度Q网络(DQN)能让机器在雅达利游戏里学会拿分。它的底子是 Q 学习,再加一张神经网络。

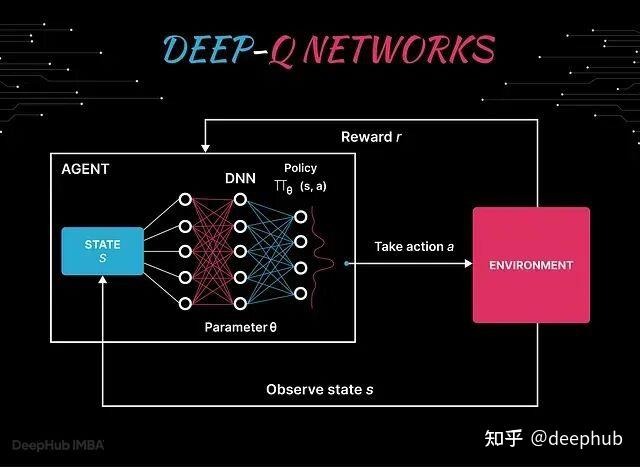
深度Q网络的基本结构图

深度Q网络的基本结构:智能体看环境状态,网络给出每个动作的价值,挑一个执行,环境返回奖励。

常见的技术介绍里,经验回放缓冲区和目标网络总是被摆在一起。两根支柱,缺一不可,这是标准说法。

对做AI工具和自建[……]

继续阅读