

两年前那段机器人炒虾的视频,很多人还有印象。
机械臂一手端锅,一手拿铲。虾翻两下,倒进碗里。动作谈不上利落,但像模像样。
为了让机器人学会这一套,研究人员得先上手操控。一遍遍采集真机示范,再用模仿学习喂给它。一个固定任务,大约要采 50 次。
这两年AI工具的迭代速度,大家早就习惯了。模型版本一周一换,参数翻着涨。机器人这边不一样。卡住它的很少是算法,更多是数据。
现在同样一道菜,灵初智能给了另一种答案。人站在旁边示范一遍。不重新训练,也不微调模型。机器人把这段操作当成上下文读进去,自己就能把新任务试出来。
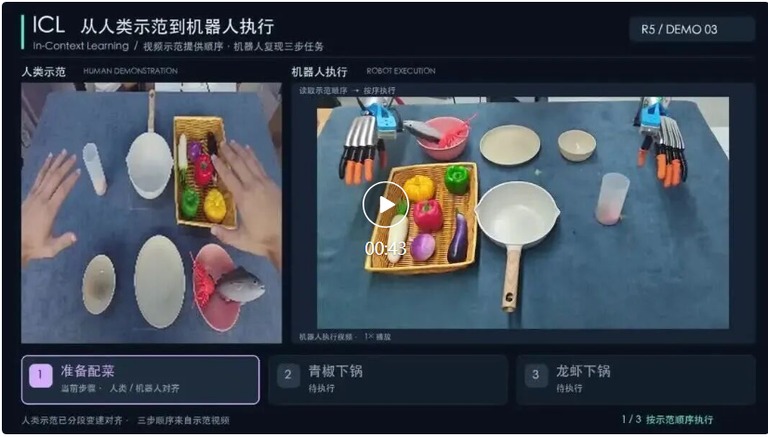
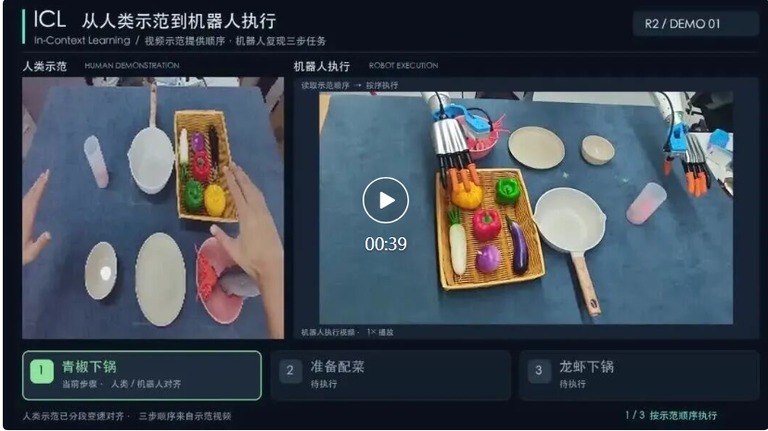
人先示范「准备配菜,接着青椒下锅,最后龙虾下锅」这三步。模型按顺序把整段复现出来。全程不动参数。
同样是炒菜,两年前大家关心机器人会不会。现在关心它怎么学。
视频这东西并不稀奇。AI视频生成早就卷过一轮。可机器人要的不是好看的画面,是画面里每一个动作。
对人来说,拿起锅铲再翻动食材,几乎都是下意识的事。灵初想做的是另一件事。跳过一遍遍采数据,直接把人的操作经验拿去当训练素材。
机器人读上下文这件事,做法是从AI对话那边借过来的。语言模型把前文当提示。机器人把示范当提示。思路一样。
灵初之前就沿着这条路走。四月发布的 Psi-R2 和 Psi-W0,把十万小时规模的人类数据拿去做预训练。再靠强化学习把人手轨迹优化成机器人能执行的轨迹。代价是链路很长。策略模型和世界模型要反复滚动推演,轨迹还得继续微调。
这一次发布的是新一代具身基础模型 Psi-R2.5。团队没有继续盯着十万小时这个数字。他们转去解决数据多起来之后的两件事。哪些数据真的有用。怎么让人类数据更顺地进到训练里。
让人类数据真正进到训练里,靠的是一份强配对数据
直接把人类视频丢给机器人学,这条路走不通。核心还是本体差异。
人手和机械手长得不一样。相机参数一变,画面就对不上。这是视觉上的差距。
人的动作和机器人数据之间,还隔着姿态估计的误差,以及关节结构的差异。摩擦这类物理参数也会有偏差。这是动作层面的差距。
上一代 Psi-W0 已经能把人手轨迹优化成可执行轨迹。可每条数据仍要走一遍世界模型推演。走完还得补一轮强化学习微调。
Psi-R2.5 换了配对数据的造法。
只按相同任务语义收集的数据,灵初叫弱配对数据。图像上除了本体基本一致,时序上还要逐帧对应。动作能直接放到机器人上回放,才叫强配对数据(Strong Pair Data)。
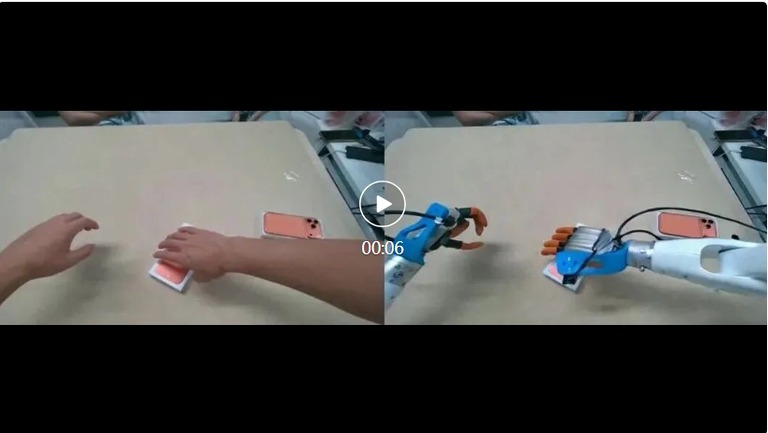
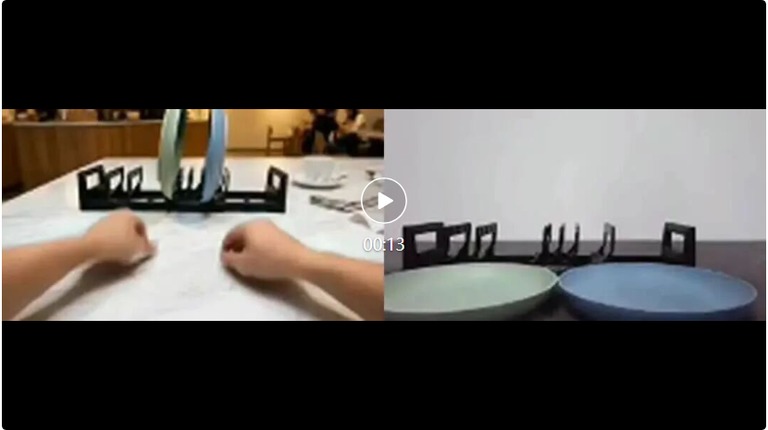
团队的思路是反着来。既然从人类数据转成机器人数据很麻烦,那就换个起点。从本来就能执行的真实机器人数据出发,反向生成一一对应的人手数据。
这一步看着别扭,道理却简单。真实机器人数据里,图像和动作都是现成可用的。拿它当锚点生成人手数据,就得到一批成对的人机数据。
有了这批数据,团队训练出一个带动作的端到端转换模型。新拍的人类操作,可以直接和机器人数据接上。
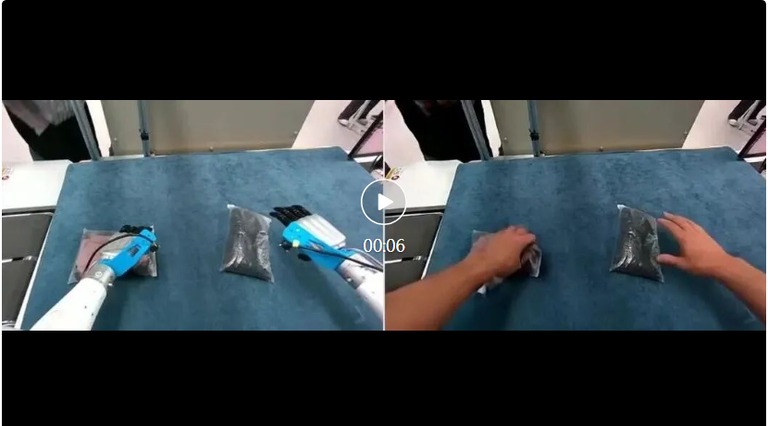
判断转换有没有用,就看两条路。转换后的数据能在真机上回放。拿它接着训练模型,模型还能学会相关任务。
到最后,人用手机拍一段操作视频,就能变成不同机器人的数据。

从拿到一段人类数据,到得到机器人真正能用的数据,中间的距离确实短了。
从人类示范到真实任务,只要一到两个工作日
会学还不够。机器人还得应付现场。
具体场景里,任务步骤和环境都在变。所以模型结构也动了。上一代是两个模型分头干活。R2.5 改成双层。上层管长程任务拆解,把一段长指令拆成子任务。下层结合当前观测,输出具体轨迹。
上层的骨干是一个视觉语言模型(QwenVL3.5-4B)。下层用的是视频生成方向的模型(Wan2.2-IT2V-5B)。两者在同一批预训练数据上练出来。
不过基础模型到了客户现场,很难一次通吃。不同场景的物料和步骤差别很大,作业节拍也不一样。后训练短期内绕不开。
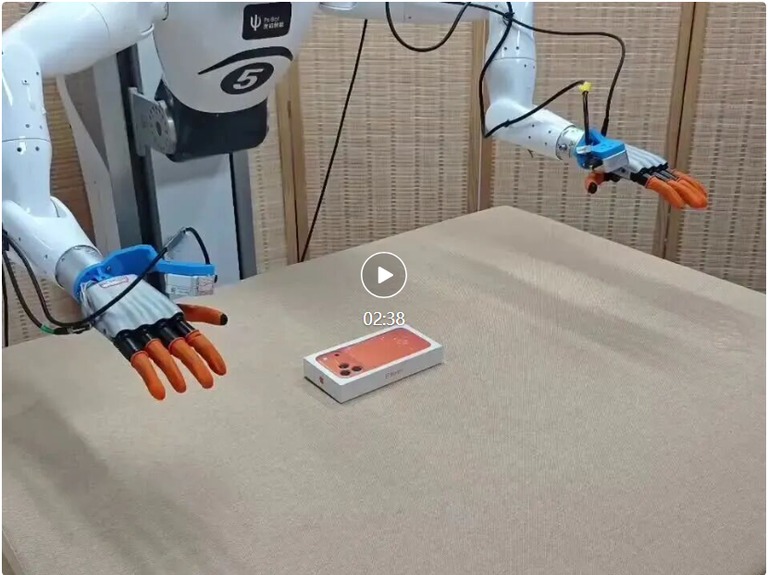
为此灵初做了一套基于灵巧手的后训练框架。人的反馈进到回路里,再配合强化学习。少量数据就能在基础模型上继续微调。部署时失败的案例会实时回流,喂给下一轮迭代。
看一个例子。手机盒装配步骤多,对精细操作的要求也高。从零开始用模仿学习,成功率很低。有了这套框架,几轮迭代之后成功率能到 99%。整个过程一到两个工作日。
配对数据解决的是数据怎么变得能训练。人的反馈加强化学习,解决的是模型进场之后能不能稳住。
新任务临时冒出来,还有更轻的办法。就是前面说的上下文学习。人示范一遍。轨迹当作提示输入。机器人照着做。这里的上下文不是一段文字,而是一段人类示教视频。
借前面那套转换能力,示范视频先变成机器人数据,再作为提示喂进去。模型不更新参数,也能对没见过的任务做零样本泛化。
两种方式对应两种需求。要长期稳定执行的任务,继续靠后训练和现场数据迭代。新任务来了,就用示范加上下文学习,轻一点地适配。
十万小时之后,拼的是数据里的信息量
假设有一万小时数据,覆盖 100 个任务,每个任务重复 100 小时。另一批只有 100 小时,同样覆盖 100 个任务。时长差了 100 倍。真正有用的信息量未必差那么多。
人类数据到了十万小时量级,重复内容的比重就上来了。所以 R2.5 开始主动压缩。单个任务的数据量往下减。同样规模下尽可能多覆盖任务。再用自动标注管线把拆分后的原子任务标细,然后人工过一遍。
规模扩张的重点,从加时长转到了提高同等规模里的信息量。
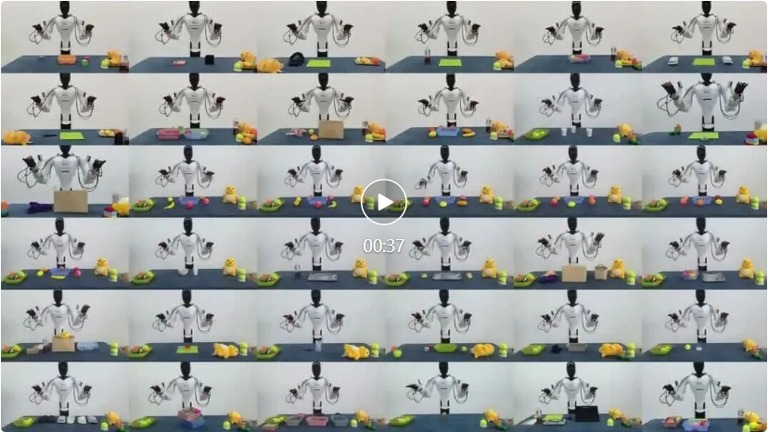
这个变化也进了评测。训练时引入仿真评测。另外搭了一个多任务真机评测集,包含 50 个复杂任务。测试时不断随机化任务的初始状态,看模型的组合泛化到底行不行。
判断一段人类数据够不够好,标准其实很朴素。能直接训练出完成对应任务的模型,就是好数据。
前面那两条验证手段,到这里正好成了质量标准。数据要能在机器人上回放。也要能真的用于后训练,还得让模型泛化到相关任务。
这也解释了配对数据为什么成了这一轮升级的关键。一段人类数据只告诉模型「人在做什么」。它对操作的帮助有限。只有转换之后能回放、能训练,它才提供了机器人最需要的那部分信息。
写在最后
具身智能要走向规模化,数据成本始终绕不开。
机器人每进一个新场景,每学一个新任务,都要重新采数据再训一轮。能力扩张的速度会很快被数据生产卡住。
人类数据是另一种可能。它足够丰富,也更容易持续拿到。但规模优势只有变成机器人能执行,能训练,还能泛化的数据,才算数。
从 Psi-R2 到 Psi-R2.5,强配对数据提高了人机数据的对齐质量。人的反馈加强化学习,压低了具体任务的适配成本。上下文学习则试着让机器人少一次重新训练。
人类数据还能把机器人的训练与部署成本压到什么程度。接下来一年大概能看出些眉目。
