

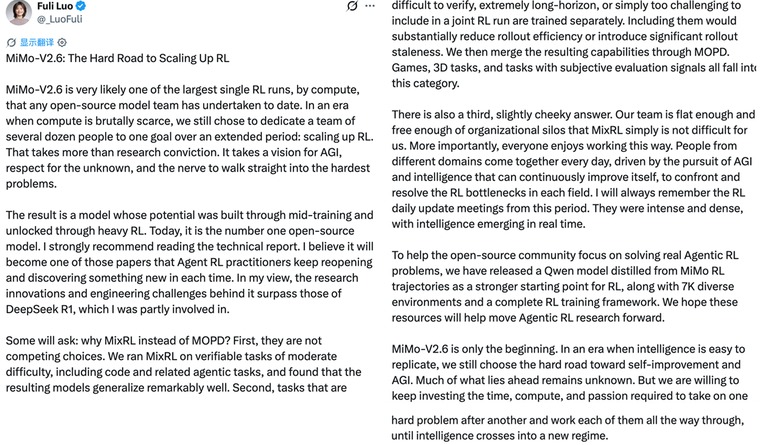
小米大模型团队在 9 月 22 日放出了新一代模型。名字是 MiMo-V2.6 系列,这一次直接开源。节奏很快。系列里有两款原生全模态模型。高配的叫 MiMo-V2.6-Pro,轻量的叫 MiMo-V2.6-Flash。小米还表示,之后会逐步开放一款极速版。官方称在同等智力水平下,它的输出速度能提高 20 倍。
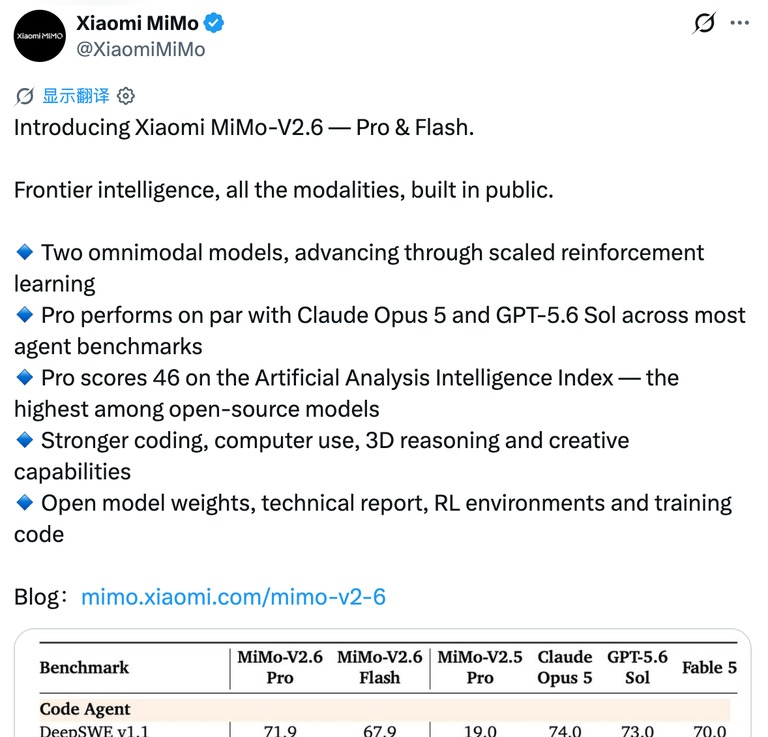
跟模型一起开源的,还有训练用的强化学习环境和框架。另外还有一份完整的技术报告。这点很少见。
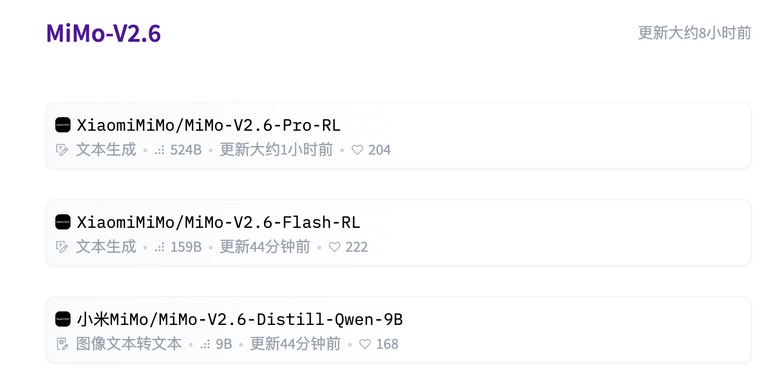
团队负责人罗福莉当天早上发了文。她说这一代押注的是大规模强化学习扩展。这也是开源模型里迄今最大规模的一次单次训练。她把这条路看作探索递归自我改进的新一步,也是通往通用人工智能的新一步。她还直言,这次的创新和工程难度已经超过了 DeepSeek R1。口气很硬。
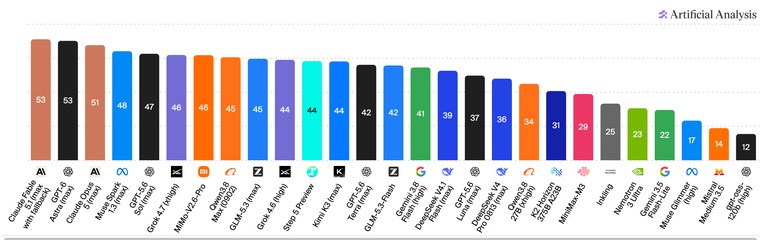
跑分先看第三方机构。在 Artificial Analysis 的智能指数上,高配版拿到 46.32 分。分数很能打。它超过了 Kimi K3 与通义千问的最新版本,成为这个榜单上得分最高的开源模型。分数跟刚发布的 Grok 4.7 基本持平。
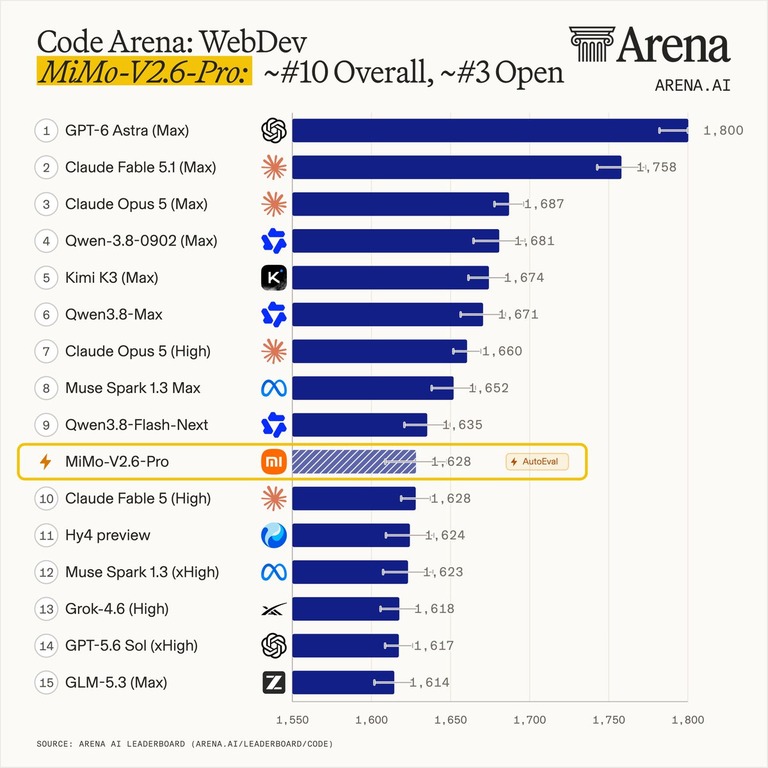
在偏重AI编程的网页开发榜单里,高配版首测 1628 分。上一代是 1475 分,这次涨了 153 分。目前排在全球前十,开源权重模型里排第三。
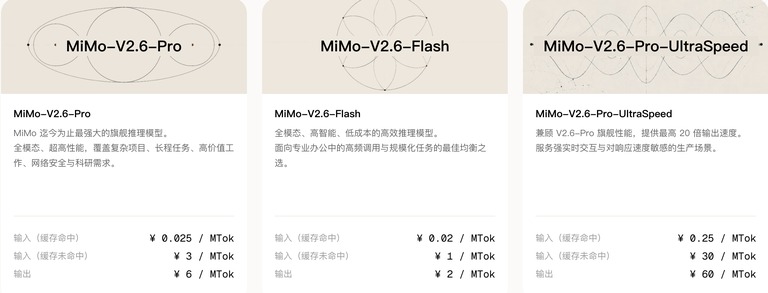
价格是这一代的另一张牌。价格很狠。定价延续了上一代的标准,高配版输入缓存命中每百万词元 0.025 元。缓存没命中是每百万词元 3 元,输出是每百万词元 6 元。轻量版更便宜,缓存命中每百万词元 0.02 元,没命中 1 元,输出 2 元。极速版的价格是高配版的十倍。
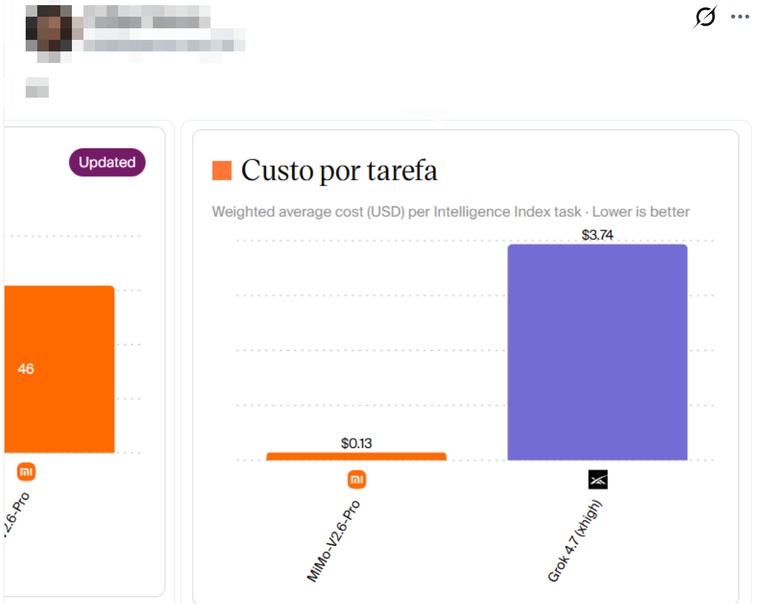
有网友晒出了和 Grok 4.7 的价格对照。在同等智力水平下,Grok 4.7 的价格大约是高配版的 29 倍。这个价格放在当下的AI工具市场里,冲击力不小。
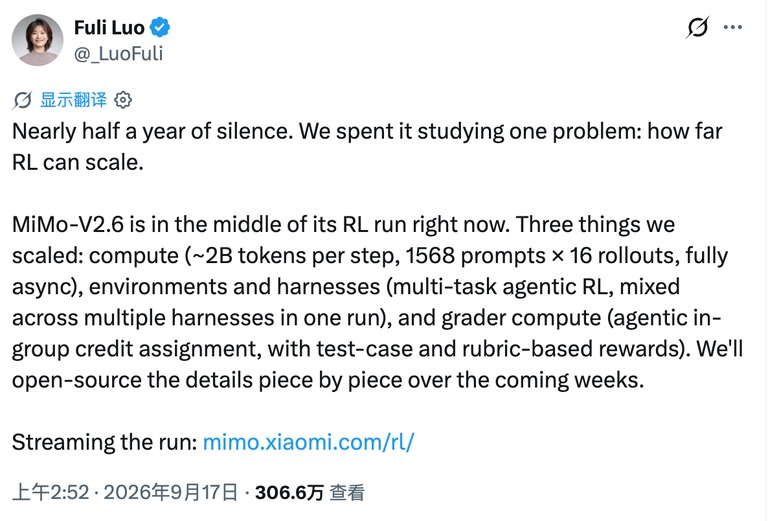
这一代的预热方式也很少见。9 月 17 日凌晨,罗福莉在社交平台上放出了两款模型的训练数据实时看板。训练细节被全网直播了一遍。两轮训练平均每小时烧掉 3.08 万美元。烧钱烧得很直白。
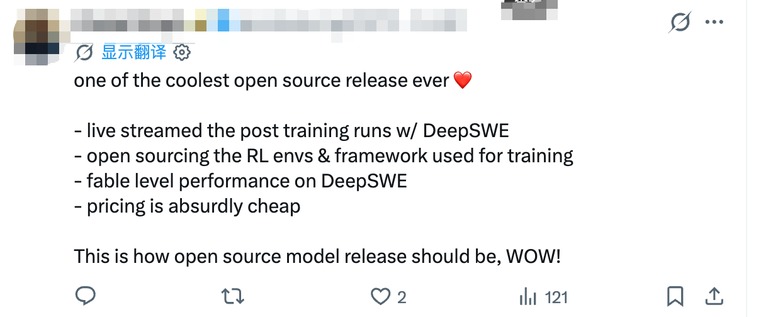
有网友说,这是有史以来最酷的开源发布之一。既直播了训练过程,又开源了技术细节。性能很强,定价低得离谱。
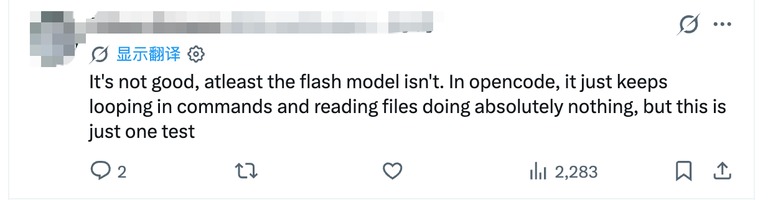
不过也有开发者不买账。争议不小。有人觉得轻量版没有达到预期。在 OpenCode 里,它会反复执行命令,反复读取文件,执行能力偏差。
一、6 天 30 步与 75 万条轨迹:从编程扩到 3D 和科研
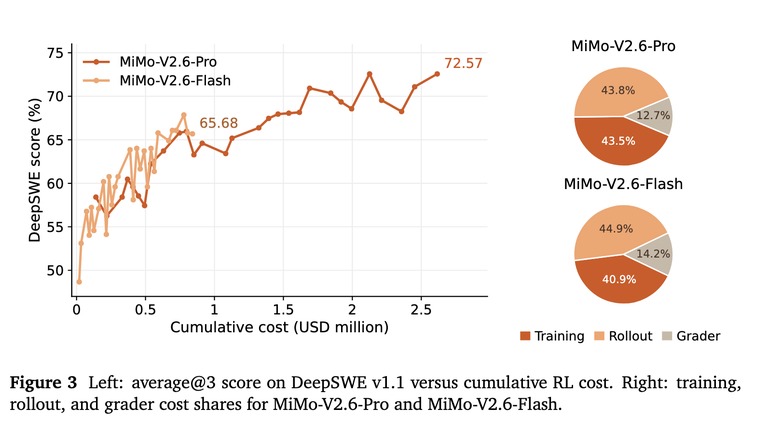
所谓大规模强化学习扩展,在技术报告里是一串数字。6 天直播训练期间,两款模型各自完成了 30 步。累计覆盖大约 75 万条轨迹,训练成本分别约为 85 万美元和 262 万美元。一轮训练下来,两款模型的训练任务平均通过率分别提升了 25% 和 12%。
在 DeepSWE v1.1 测试中,轻量版从 48.8 分升到 65.68 分。高配版从 58.4 分升到 72.57 分。涨幅不小。
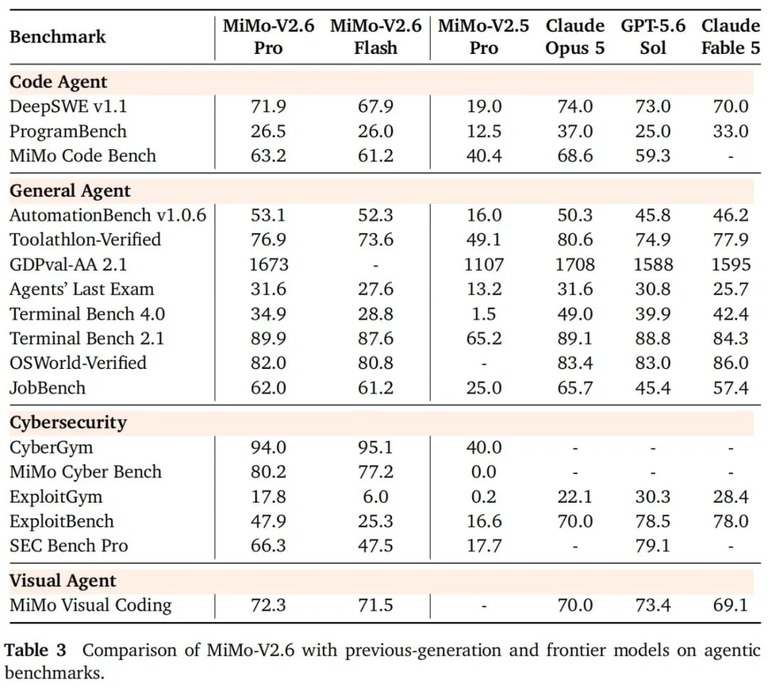
强化学习阶段投入的算力很大。经过大规模多任务训练,两款模型的分数上来了。在多数评测榜单上,它们接近 Claude 与 GPT 最新旗舰。差距已经不大。
训练系统上,算力扩展主要体现在三个地方。训练规模、任务环境,还有基础设施。小米用的是全异步架构,单次更新 1568 个样本。训练最高支持 100 万词元上下文。每个强化学习步骤消耗约 35 亿到 37 亿词元。量级很大。
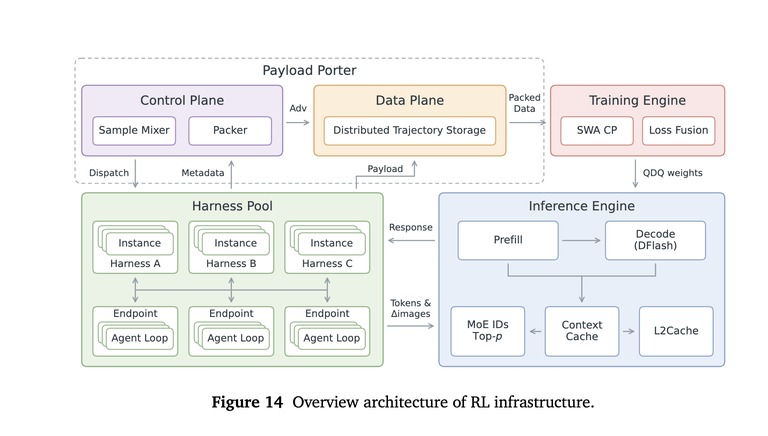
训练任务也不再只围着编程转。它覆盖通用智能体、视觉和网络攻防等场景,还混合了多种任务框架。这样不同任务产生的训练信号就能共同作用于模型。范围铺得开。
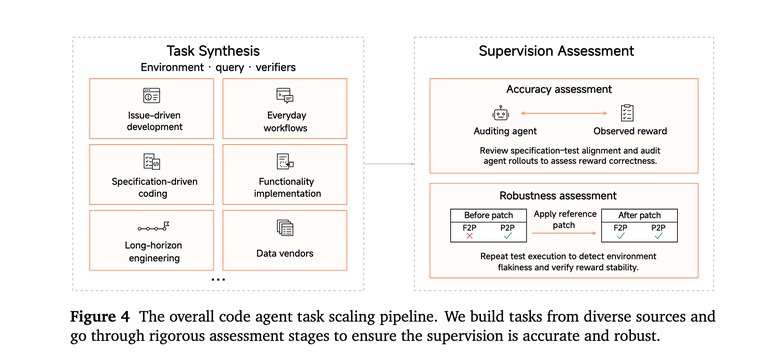
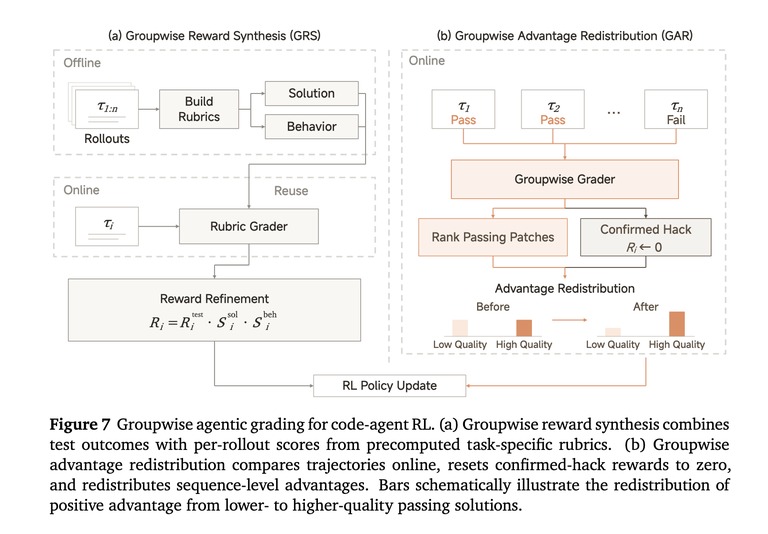
奖励机制也做了改动。对长程任务,小米用组内评分。把同一任务下不同轨迹的完成情况和质量放在一起比,再重新分配奖励信号。这样既能区分完成任务和高质量完成任务,也能引导模型少走弯路、少耗词元。
训练规模变大之后,稳定性问题也跟着来了。小米冻结了专家路由,减少训练过程中的模型漂移。针对奖励作弊,团队从奖励设计、对抗评估到验证器交叉校验设了多层防护。工程层面,他们统一了轨迹表示和惩罚机制,并针对不同智能体框架做高并发交互。工程活不少。
能力范围也在扩大。新模型处理的任务已经从编程延伸到 3D 内容。电脑操作和设计也能做,视频和音乐同样在范围里。
3D 游戏开发是一个例子。模型可以接收一段视频、一张图片或一句提示词,自行拆解任务。它会协调多个智能体搭建 3D 场景,实现交互逻辑。它还会根据渲染结果做视觉检查和迭代。
在 Blender 里,它还能按文字描述或参考图生成 3D 资产。这些资产可以继续用在动画、3D 打印和游戏开发上。
通过电脑操作能力,模型可以进入具身仿真环境。它能接收多视角相机画面,持续推理和决策。再通过视觉反馈控制机械臂,完成抓取、颜色匹配和精确放置。这一步不容易。
设计任务也在能力范围内。模型可以生成完整的前端界面或演示文稿。里面有版式结构和组件,也有交互元素和动效。它还能和 Figma 以及图像、视频生成工具配合。
AI视频制作同样可以。小米展示的一支宣传片里,从视觉设计到镜头编排,从音乐创作到卡点剪辑,都由模型完成。流程很长。
音乐是新增的能力。小米方面说,这一代强化了音乐理解、审美判断和乐理运用,还首次尝试了作曲。这是新加的。
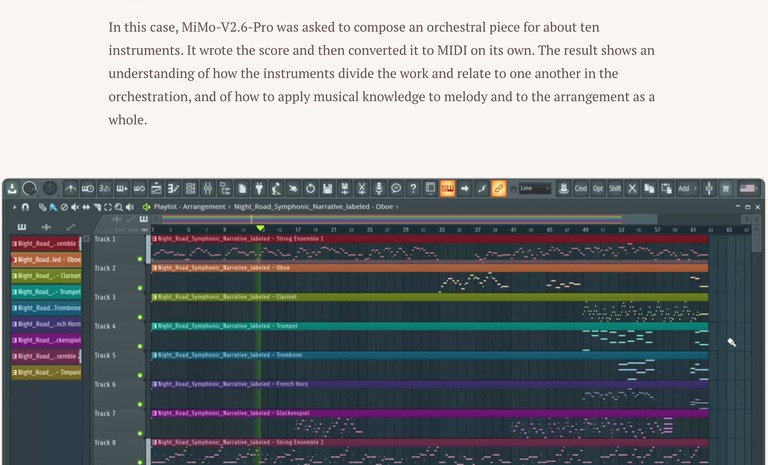
科研案例更能看出通用能力的迁移。小米明确说,这些任务并没有经过专门的科研训练。靠的是模型已有的通用能力。
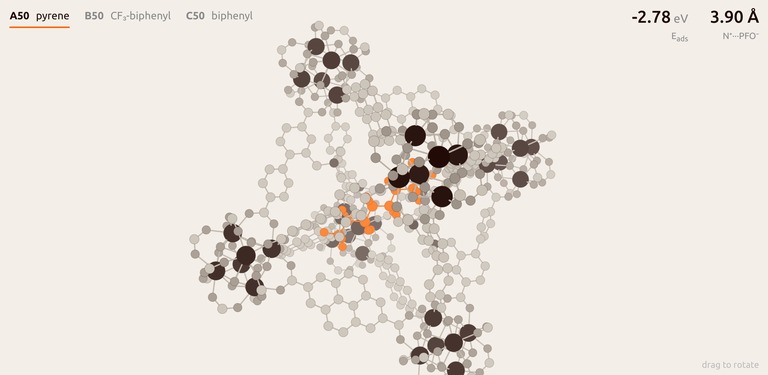
材料科学方向,团队让高配版设计一种全新的金属有机框架材料,用来吸附全氟化合物。在材料专家引导下,模型做了网络检索,梳理了文献与专利,再提出假设并评估新颖性。随后它调用开源计算工具搭建仿真环境,算出材料与污染物之间的结合强度。最后筛出三种候选框架,交给湿实验进一步验证。
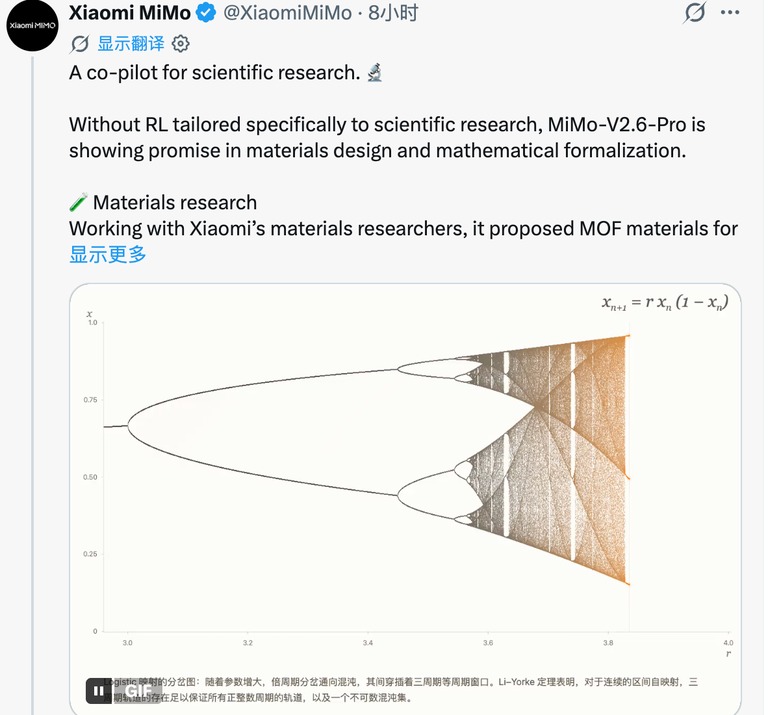
数学方向的例子更硬。研究者对一篇经典论文的主定理做形式化。高配版通过多个子智能体协作,推进定理陈述与证明。最终项目包含 6000 多行 Lean 代码。它通过 Lean 内核完整验证,没有留下未完成的证明占位。难度不小。
二、实测:会做网页,但容易长考,爱翻目录
实测部分来自智东西在 OpenCode 里的体验。先看基础的多模态能力。输入一张应用截图,让高配版不依赖工具去识别。它很快完成了读图,精准度不错。速度稍慢。
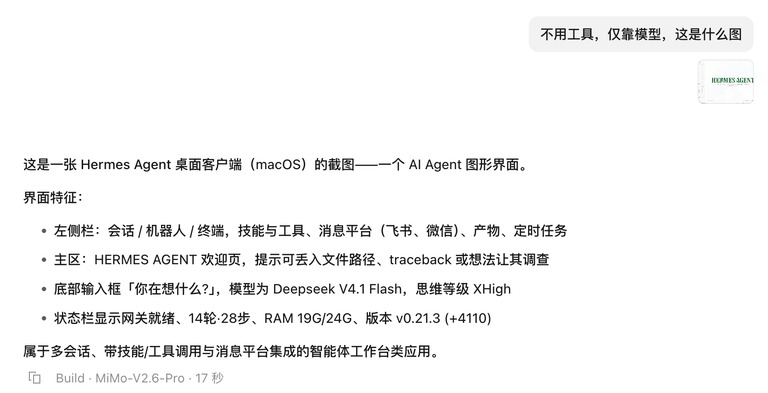
换成轻量版做同一件事,只用了 6 秒。但返还的结果在内容丰富度上差了不少。快是快,内容少。
接着是网页开发任务。提示词要求模型自己搜信息,再开发一个小米汽车官网的演示版。
开发质量不错。网页交互流畅,图片嵌入也没什么问题,比如预约试驾功能就能正常演示。但作为轻量版,整体开发时间还是偏长。
美中不足的地方在配图。这个官网的文字部分都是小米汽车的性能参数。搜索并嵌入的图片却是奔驰、宝马和奥迪。配图翻车了。
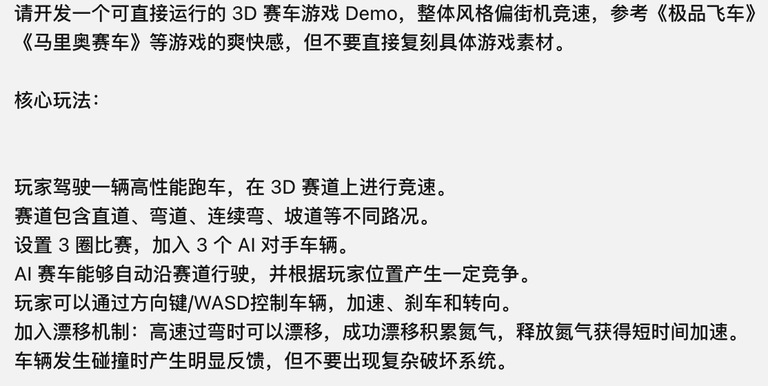
最后一个测试是赛车游戏。提示词给得很经典,高配版花了 64 分钟才交付。交付偏慢。
游戏效果问题不少。赛道的边界不清晰,路径也没有严格限制。初始状态下,赛车的建模还埋在了赛道下方。做得比较好的地方是操控感和整体光影。
同样在游戏场景里,团队还给了一个 3D 世界开发的提示词。在没有专业工具依赖的情况下,高配版交付的 3D 世界构建得不错。功能、雨丝和人物动作都比较合理,只有雨伞没拿在手上这种小问题。小瑕疵还在。
整体实测下来的感受和上一代差不多,主打性价比。基础能力是够用的,问题出在思考时间和执行路线上。任务交付效率偏弱一些。
当然,这些实测都跑在第三方平台上。它不能代表官方智能体和接口里的实际表现,也不能完全代表模型能力。
结语:一条新路,还需要更多实测
这次发布把重点放在大规模强化学习的继续扩展上。6 天完成 30 个训练步骤,覆盖约 75 万条轨迹。任务也从编程扩到智能体,还有视觉和 3D。
同时,小米把强化学习环境和代码一并开源,技术报告也公开了。训练中的基础设施和奖励机制,同样写得很细。
从榜单到实测,这一代展现了较强的基础能力。但不同任务之间的差异仍然明显。尤其长程任务里,思考时间和调用路径都会直接影响交付效率。效率是短板。
模型能走到什么位置,除了榜单分数,后续实际使用中的任务完成质量和效率同样重要。
小米想靠持续扩大训练规模来探索递归自我改进。这条路能不能提升模型的自主任务能力,还得看后面的版本和更多真实任务。
