

深度Q网络(DQN)能让机器在雅达利游戏里学会拿分。它的底子是 Q 学习,再加一张神经网络。
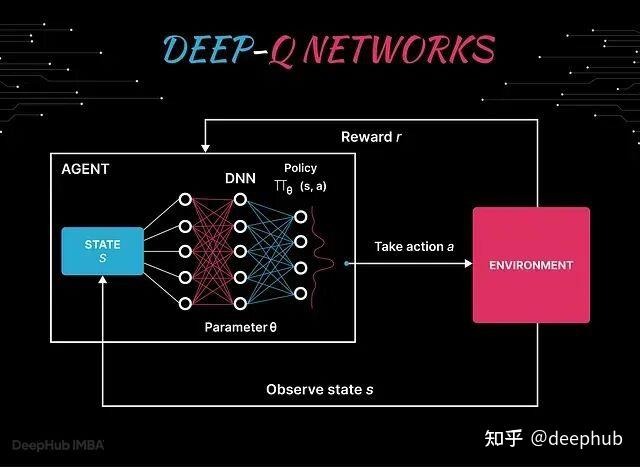
深度Q网络的基本结构:智能体看环境状态,网络给出每个动作的价值,挑一个执行,环境返回奖励。
常见的技术介绍里,经验回放缓冲区和目标网络总是被摆在一起。两根支柱,缺一不可,这是标准说法。
对做AI工具和自建训练的团队来说,下面这份实测更值得看。有人把这两个组件拆开单独测了一遍。结论挺意外:在那个最小环境里,只有经验回放起了作用,目标网络几乎没贡献。
写过AI编程的人都清楚一件事。表格法在玩具问题上很灵,一上真实任务就散架。深度Q网络就是为了解决这件事才出现的。
为什么非要把表格换成网络
Q 学习的老办法很直接。给每个「状态—动作」对一个格子,存一个数值。
状态少的时候没问题。可一旦状态变成图像,或者连续的向量,格子就摆不下了。内存占用会随着状态数乘动作数一起涨上去。
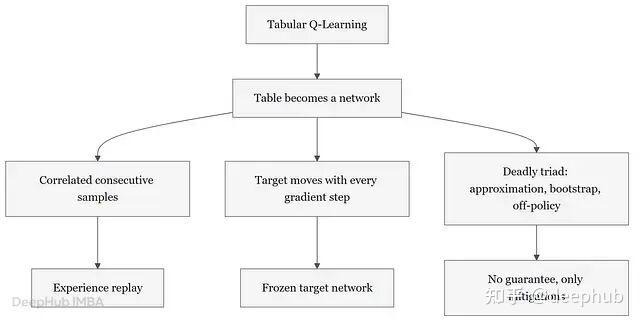
表格型 Q 学习换成网络之后,会同时带出三个麻烦:样本相关、目标跟着动,还有致命三元组。
更麻烦的是泛化。两个几乎一样的状态,在表格里互不认识,各记各的。换成神经网络就不一样了。参数被所有状态共享,改一处会连带影响没见过的状态。
好处背后藏着三个新问题。
一是样本相关。同一条轨迹上相邻的两步特别像,不满足随机梯度下降依赖的独立性假设。
二是移动目标。要拟合的目标里本身就含有当前网络。一次更新既改了预测,也改了目标。这跟标签固定的监督学习完全不是一回事。
第三个叫致命三元组。把函数近似、自举和离策略学习凑在一起,算法可能发散。
神经网络版的 Q 学习三条全中,也没有收敛定理兜底。所以深度Q网络并没有消灭致命三元组。它只是把方差和非平稳性压低到还能训练的程度。
两个组件各自在干什么
先看 Q 网络本身。它输入一个状态,一次前向传播就输出所有动作的价值。不用为每个「状态—动作」对单独算一遍。
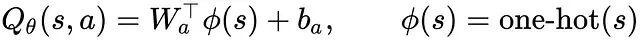
Q 网络用一组权重把状态特征映射成动作价值,特征用的是独热编码。
原文里的网络做得很小,就是独热特征上的一个线性模型。别小看它。独热特征可以精确表示最优价值。后面出现的误差,就能归到算法头上,而不是模型不够大。
再看经验回放缓冲区。它是一个固定容量的环形队列,里面存着一条条转移记录。
训练时均匀采样。同一条记录会被反复利用多次。相邻的更新也不再总是撞上连续数据。
目标网络存着一份参数副本,每隔若干步同步一次。它的任务只有一个,就是算那个自举目标。
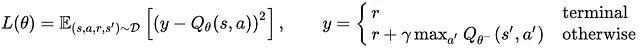
损失函数把目标值当常量,梯度不往回传,所以深度Q网络用的是半梯度更新。目标网络每隔若干步刷新,只负责算自举项。
这样回归目标在两个同步时刻之间保持不变。它不会跟着在线网络每一步一起晃。
代价也要说清楚。损失里的目标被当成常量,梯度不经过它传播。深度Q网络做的并不是针对某个完整目标函数的梯度下降。这一点后面还会再提。
行为策略走的是 ε-贪心。ε 从接近 1 开始,慢慢退火到一个较小的下限。
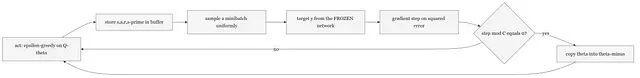
行为策略在 Q 网络上用 ε-贪心挑动作,ε 随时间逐步退火。
还有一个特别容易写错的细节。碰到终止状态时,目标直接取当时拿到的奖励。不要再加自举项。
这个错很常见。一旦写错,价值会一路往上发散,而且没有上界。
一次消融实验,把两块组件拆开看
数学部分花不了太多篇幅。重点是后面那张实验表。
对上面这个小线性网络,单条样本的损失关于所选动作参数的梯度很干净。
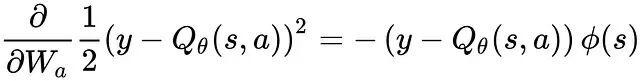
单条样本损失关于所选动作参数的梯度表达式。
把它在批次上取平均,就得到小批量更新。
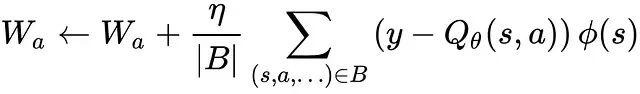
一批样本上的小批量更新公式。
有意思的地方在独热特征上。每条更新只会动到权重矩阵里的一个坐标。效果跟学习率取 η、在批次上做平均的表格更新完全等价。
作者是故意保留这种等价性的。这样经验回放和目标网络带来的变化,就能跟表示方式本身的影响分开看。
也得说清楚,真实梯度里还应该包含目标对参数的依赖项。深度Q网络把这一项扔掉了。没有收敛证明,很大一部分原因就在这。
环境很小,答案能精确算出来。
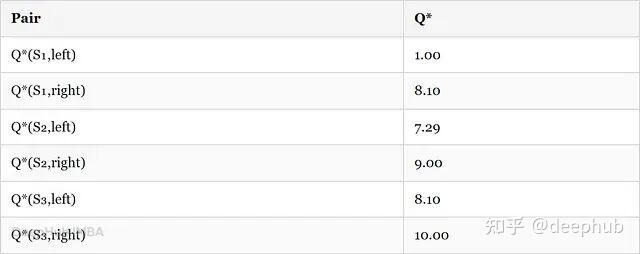
这个链式环境状态不多,走到不同终点能拿到不同奖励,最优动作价值可以直接解出来。
状态从起点出发,走进其中一个终止状态拿 1 分,走进另一个拿 10 分。转移是确定的。折扣因子 0.9,从第二个状态开始跑。
正因为答案精确,实验才能测得很干净。
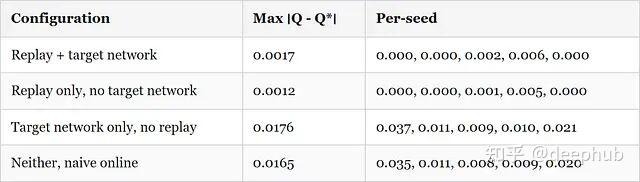
消融实验结果:带经验回放的两种配置,误差比不带的低一个数量级。
设置固定成:8000 个环境步,学习率 0.05,批大小 16,缓冲区容量 2000,目标网络每 50 步同步一次,ε 取 0.3。指标是价值估计和最优价值之间的最大绝对误差。结果对 5 个随机种子取平均。
带经验回放的两种配置,比不带的两种准确一个数量级。
而在每一对配置内部,目标网络都没造成看得见的差别。去掉目标网络之后,平均误差甚至从 0.0017 掉到 0.0012。这个变化落在不同种子的波动范围里,不能当成真实效果。
结论很直白。在这个问题上,经验回放承担了全部可测的作用。目标网络没有贡献可测量的改进。
原因在目标网络针对的那个故障模式。它要拦住的是自举目标追着当前预测一起跑。
要形成这种反馈回路,网络必须能跨状态泛化。可独热特征没有泛化能力,每个状态各拿各的参数。目标网络想防的那个机制,在这个环境里压根不会出现。冻结参数反而拖慢了学习。
这对做测试的人是个提醒。小型、跟表格方法等价的测试平台,验证不了深度Q网络在真实问题上的关键行为。目标网络就算接错了,它照样能跑通。
经验回放真正买到的是什么
既然起作用的只有经验回放,那就得看清楚它换来了什么。
对一批已经去掉相关性的转移求平均,单次更新的梯度方差会大约按批大小下降。
方差降下来,步子就可以迈大一点。其他设置不动,只扫学习率。
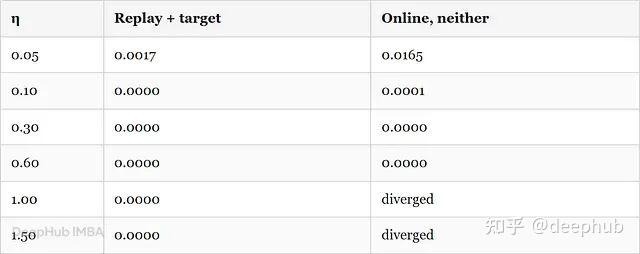
学习率扫描结果:在中间区间两种配置都能收敛,差别出现在两端。
学习率在 0.1 到 0.6 之间时,两种配置都能得到精确答案。这个区间里用不用经验回放,其实没差别。
差距出现在两头。学习率偏小时,带回放的训练能在同样的步数预算里更快收敛。学习率偏大时,在线学习已经跑出可表示范围,带回放的训练还稳得住。
学习率等于 1.0 时,在线学习不是轻微抖动,而是真的发散。因为一次只用一个样本,更新会直接拿目标把当前价值替换掉。这个目标又由刚被覆盖过的自举值构成。误差开始乘法式累积,再也收不回来。
能测到的结论就这么具体。经验回放扩大了可用学习率的范围。它并没有把一个原本解不了的问题变成能解。
高估的老毛病,换个网络接着来
用神经网络近似,并没有甩掉表格时代的老毛病。
目标里还挂着取最大值的操作。最大化偏差照样存在,估计出来的价值系统性地偏高。
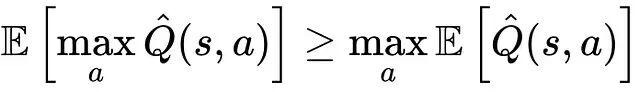
目标里的取最大值操作,让最大化偏差一直留在那里。
双重深度Q网络正是冲着这一点去的。它把选动作和评价值分开。在线网络负责挑,目标网络负责打分。
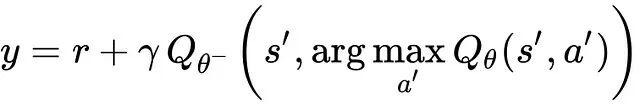
双重深度Q网络把取最大值的动作选择和动作评估拆到两个网络里。
这两个网络本来就都在,额外开销几乎可以忽略。所以对普通深度Q网络来说,这是最可靠的一项改进。
也要说明一点。这篇的确定性链不会出现这类高估。因为没有估计噪声,取最大值时没有随机误差可供挑选。
回头再看致命三元组,现在可以给它一个精确的说法。
半梯度 Q 学习在这三件事同时成立时,可能失去收敛性。参数被共享的函数近似,目标依赖当前估计的自举,还有采样分布与所评估策略不一致的离策略更新。
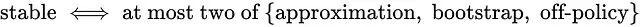
致命三元组说的是:函数近似、自举和离策略三项同时成立时,稳定性可能失去。
去掉任意一项,稳定性都会回来。蒙特卡洛方法去掉的是自举。另一类时序差分方法削弱了离策略的成分。表格表示则去掉了函数近似。前面实验之所以跑得这么平,就是这个原因。
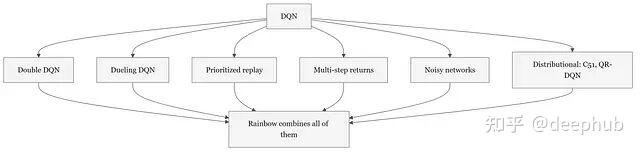
深度学习时代的 Q 网络家族:双重结构、双流结构,还有优先回放和多步回报等变体。
这条规律属于经验判断,不是定理。两个方向都有反例。不过拿它来判断深度Q网络的多数失败模式,通常够用。
这些变体分别在修什么
沿着这条主线,往下长出了好几支。
双重深度Q网络把选择和评估分开,几乎不添成本,却能削掉大部分高估。
双流结构把网络拆成两条。一条算状态本身值多少,另一条算每个动作相对好多少。为了保证可辨识,优势那一支要减掉均值。
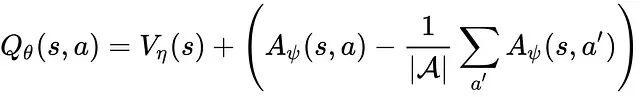
双流结构把动作价值拆成状态价值和优势函数两部分。
动作价值彼此接近的场景里,这种拆法最有用。
优先回放改了采样概率。它不再均匀采样,而是按误差大小加权。由此带来的偏差,再用重要性权重校正回来。少了这步校正,优化目标就变了。
多步回报拿更高的方差,去换更低的自举偏差。分布式学习更进一步。它学的是一整个回报分布,而不只是一项均值。需要的时候,均值仍然可以从分布里恢复出来。
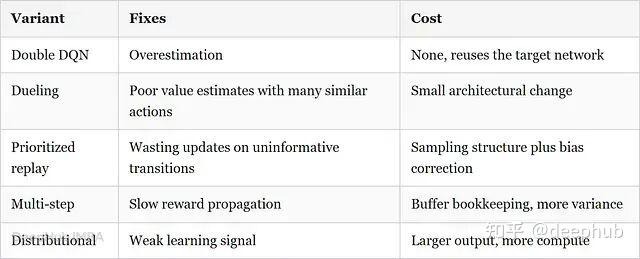
常见变体各自修什么问题,代价有多大,一张表能看清。
评估指标怎么选
最后落到实际问题上。怎么知道自己的实现是对的。
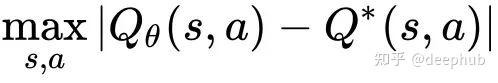
相对于最优价值的最大绝对误差,是最直接的指标。
最直接的指标是最大绝对价值误差。只有能求出精确答案的问题才算得出来。这也正是测试套件里该留几个可解问题的理由。
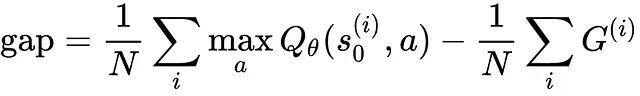
预测价值和真实回报之间的差距,用来诊断高估。
更接近上线效果的是贪心策略回报。把探索关掉,跑多个回合,报告均值和标准误。
想知道实际任务里有没有高估,就看预测价值和真实回报的长期差距。如果长期偏正,基本就是该换双重深度Q网络的信号。
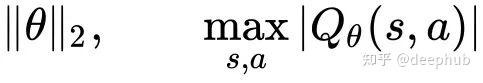
价值估计和实际回报的最大差距,用来判断高估有多严重。
还有几个指标是用来兜底的。参数范数和价值幅度可以捕捉发散。学习率大于等于 1.0 的在线训练,早就跑出可表示范围,价值幅度会先出异常。而损失本身未必变大,因为目标可能跟着预测一起涨。
时序差分误差的分布也值得看一眼。别只看均值,要看整体分布。如果尾巴很重,往往说明有少量样本网络怎么也拟合不上。这时问题更可能出在状态表示,而不是训练流程。
样本效率统计的是达到目标回报需要多少环境步。真实系统里,跟环境交互才是主要开销。一次梯度更新通常便宜得多。
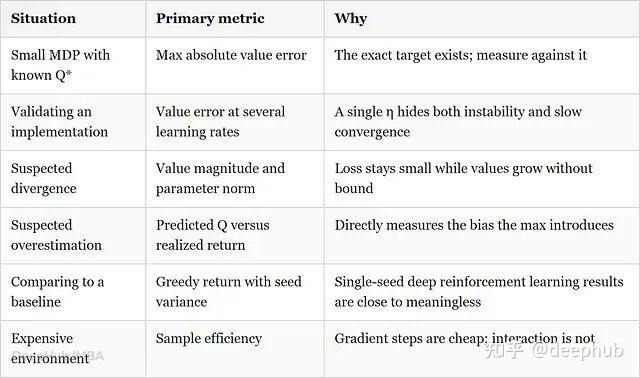
不同场景下该看哪个指标,可以照这张表挑。
写在最后
把这篇实验读完,最该记住的不是深度Q网络难不难。
而是两个被并列写了很多年的组件,在特定环境里一个管用、一个不响。原因也很清楚。目标网络防的是跨状态泛化带来的反馈回路。环境里没有泛化,它自然就使不上劲。
这也解释了为什么小型测试平台容易给人错觉。表格等价的玩具问题跑得再漂亮,也验证不了真实问题上最要紧的那部分行为。
对做AI编程的人来说,这份结论的用法很直接。挑测试环境时先问一句:这个环境会不会逼出泛化。不会,那它测的就只是另一半。
至于经验回放,它的价值也不在玄学。它把梯度方差压下去,换来一段更宽的学习率容忍区间。步子能迈大,训练就更省事。
这类原理向的内容,读起来更像一份AI软件教程里的章节,而不是一条新闻。但它对工程判断的帮助,往往比新闻大得多。
