

9 月 21 日,一份关于 AI 虚拟细胞的行业研究报告正式发布。它由百曜科技发起,《麻省理工科技评论》中国团队负责调研和撰写。报告在中关村科学城管理委员会指导下完成。
报告要回答的问题很具体。AI 虚拟细胞能不能从论文里的能力指标,走到药物研发里真正跑得起来的基础设施。也走到生命科学的真实场景里。
答案写在三条产业趋势里。这一层最关键。
细胞被做成计算空间里的镜像
先把名字解释清楚。AI 虚拟细胞,常用缩写是 AIVC。它把研究对象从分子层面推到细胞层面。
在这个新范式下,细胞不再只是被观察的对象。它可以被表征,可以被模拟,可以被干预,还能持续校准。它要回答的不只是「这是什么细胞」。它还要预测,敲掉一个基因会怎样,加进一种药之后细胞又会怎样。
报告给它的定位是基础设施,而不是又一个模型。这个判断的由来,得从十年前说起。
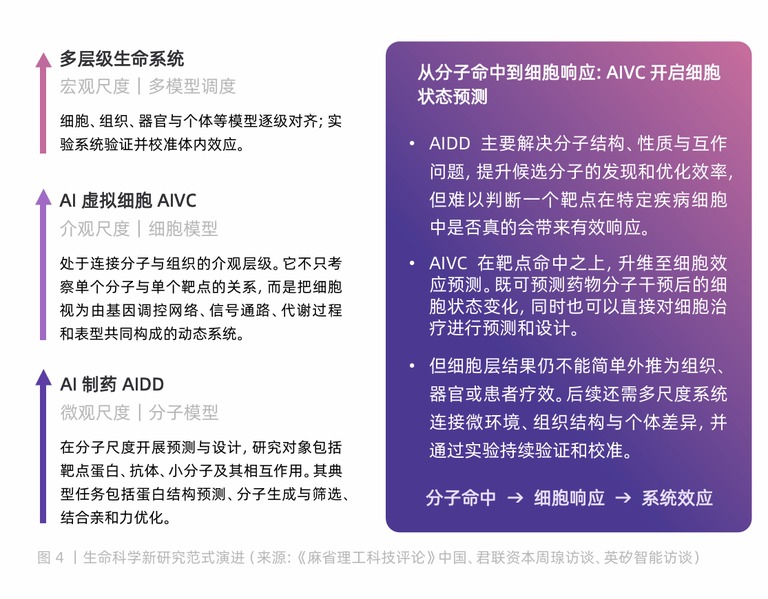
以 AlphaFold 为代表的 AI 工具证明了一件事。蛋白质结构预测可以变成一个计算问题。AI 制药也因此在分子层面明显提升了研发效率。
问题出在下一步。分子层面的成功,不等于细胞层面的有效。药物进了人体,基因被编辑,或者细胞所处的环境变了,细胞究竟会怎么响应,这才是真正要紧的事。临床转化阶段的不确定性,大多卡在这一层。
报告还给了一个新视角。它把细胞看成计算系统,而不是实验台上的样本。这背后是一层层的尺度。微观是分子,介观是细胞,宏观是组织和器官。AI 制药解决的是分子那一层的事。AIVC 要接的是细胞那一层。这一层最难。
AIVC 成熟之后,有望沉淀成可复用的模型与工具平台。服务对象是制药企业、科研机构和医疗机构,覆盖的环节很长,从基础研究一路排到细胞工程。再往后,临床研究、患者分层和临床决策支持也在扩展方向上。
趋势一:比的不再是规模,而是泛化能力
长期以来,这个领域遵循一套缩放定律。把数据规模和参数量堆上去,模型效果就会更好。
报告给这个惯性泼了盆冷水。单纯扩大数据或参数,并不必然带来更好的零样本泛化。训练目标、扰动覆盖都会影响最终效果。数据多样性和细胞上下文也一样。任务类型也是变量。
所以未来的企业要同时练两种能力。一种是跨场景的预测能力。另一种是把模型扎进具体场景。比如某一种疾病,某一条药物管线。
与其继续堆规模,不如先把数据对齐做扎实。
报告还点到一条技术上的分岔。不少现有模型主要基于横截面的转录组快照来学统计表征。这类模型对细胞动态过程和干预响应的刻画有限。另一些研究开始尝试世界模型式的状态转移建模。也包括 JEPA 这类潜在空间预测方法。目的是提高对新扰动的预测能力。对新细胞背景也一样。

趋势二:私有数据和「新生产数据」成了硬通货
数据工厂能力,正在变成这类企业的核心能力。
报告给出的判断是,数据竞争的维度变了。从比规模,转向比质量、比对齐能力。公开数据只能撑起基础模型的状态表征。它很难形成差异化优势。
更有价值的是另外两类。一类是稀缺的私域数据。比如药物扰动和临床表型。另一类是为训练目标专门设计生产的「新生产数据」。
后者的门槛在于完整。要有基线对照,要有剂量梯度,要有时间维度,还要多模态对齐。有了这些,模型才能学因果关系。报告认为,这类数据是难以复制的核心资产。具备多模态数据生产能力的企业,护城河会更深。门槛不低。

趋势三:干湿闭环决定谁能产业化
报告提到,全球这个产业正从概念验证,进入产业价值验证期。
这个阶段,单一的模型性能不再是唯一评判标准。能不能打通这条链路,成了产业化的核心门槛。从数据生产,到模型预测,再到实验验证和数据回流。
报告特别强调,干湿闭环不等于自动化实验室。它是一套系统能力,把技术研发和商业交付拧在了一起。企业既要有高质量的预测与方案,又要能用实验完成验证,还要把实验结果喂回模型。这样才转得动。
海外跑得早,国内刚起步
从全球格局看,这条赛道已经聚起了四类玩家。创新企业在里面。科技公司、药企和科研机构也在里面。报告把百曜科技列进了以 AIVC 为核心产品的创新企业图谱。图谱里还有 Recursion 和 Xaira 这些海外公司。

分工上也有差别。海外起步更早,协作体系更成熟,已经走到药企合作与产业验证阶段。国内还在发展初期,正在从技术研发往场景落地赶。
报告里写了国内一家企业的具体做法。今年 6 月,百曜科技发布了 AI 虚拟细胞世界模型 AURA CellOS。它的底座是 LLM-JEPA 架构。公开评测里,它在预测精度和扰动建模等指标上与主流模型拉开了倍数差距。按报告的说法,这款模型的重点不在参数规模,而在架构上的重新设计。它让表达视角和感知视角协同工作,在隐空间里学细胞状态变化的稳定特征。
数据侧的动作是一套自建平台。它用高通量的扰动实验平台生产扰动响应数据。这些数据是多模态对齐的。同时,它联动临床合作资源,积累真实世界的肿瘤微环境数据。落地场景已经选了几个。肿瘤患者分层是其中之一。CAR-T 优化和皮肤抗衰靶点发现也在名单上。
写在最后
这份报告的价值,不在于又给出一个新名词。它把一条路线的关卡讲清楚了。数据要成套,模型要泛化,实验还要能回流。
对普通读者来说,AI 虚拟细胞离日常还有一段距离。三百多页的报告,讲的也是药企和实验室的事。别指望它能给出可以直接照做的方案。
不过「用模型替人试错」这件事并不遥远。同类的 AI工具 已经在很多行业落了地。材料是一个,药物和芯片设计也是。只是名字不叫虚拟细胞。
想找现成能上手的,可以从 AI小工具 这类轻量产品试起。它们解决的都是很小的具体问题,反而更容易见到效果。
至于怎么用、哪些场景值得试,站内的 AI软件教程 栏目里有更细的步骤。
