

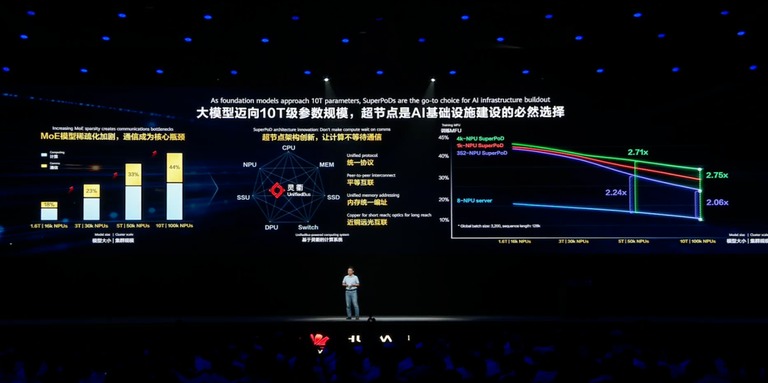
先说一个让人心里发凉的数字。十万张卡的集群里,卡与卡之间的通信能吃掉四成以上的训练时间。真正拿去算东西的算力,往往不到三成。
这就是眼下大模型竞赛的尴尬。海外在冲十万亿参数,国内在追数万亿参数。为了训出更强的 AI工具,万卡集群早就不够看。十万卡正在变成新的门槛。
可卡堆得越多,有效算力并没有跟着涨。
算力利用率每提高几个百分点,省下的就是好几天时间。账单也一样。数千万元,甚至上亿元。对训练周期以月计算的前沿模型来说,尤其如此。
于是越来越多厂商把目光转向一种新的组织方式:超节点。它不再把计算卡拆散在一排排服务器里。更紧密的互联,统一的内存空间,更低的时延。几千张卡就这么被捏成一个整体。
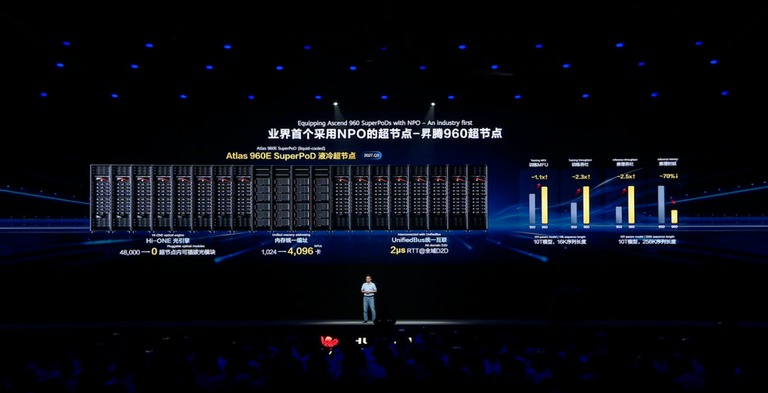
日前发布的昇腾 960 超节点,就是冲着十万卡时代来的工程化方案。
超节点为什么成了必选项
从去年开始,超节点这四个字在算力圈里越来越热。华为昇腾 910C 超节点把话题带了起来。随后国内做算力和服务器的厂商也陆续跟进。一时间,它几乎成了新一代算力基础设施的代名词。
在日前的 HC2026 大会上,华为轮值董事长汪涛给出一个判断。大模型迈向十万亿级参数规模,超节点会是算力基础设施的必然选择。
但产品一多,一个更基础的问题就冒出来了。到底什么才算真正的超节点。如果只是把更多服务器摆在一起,再用高速网络连起来。那它跟传统集群有什么区别。
今年 7 月的世界人工智能大会期间,《超节点定义与实践白皮书》正式发布。这份文件由鹏城实验室和全球计算联盟牵头,38 家单位一起参与。它第一次从行业层面给超节点划出边界。
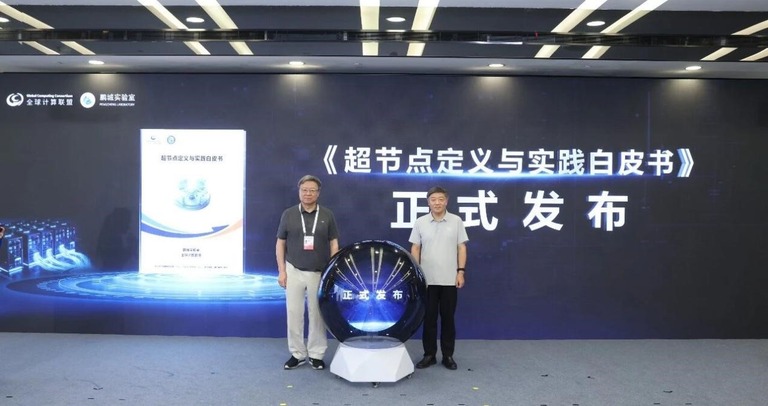
白皮书的定义是这样的。多个计算节点通过高效的互联协议紧紧连在一起。并且具备跨物理节点的统一内存编址能力。逻辑上,它表现得像一台计算机。
为什么非要这样,答案在模型本身。以混合专家模型为例。这类模型在 AI编程 和长文本任务里很吃香。可它的中间结果,需要在大量计算单元之间来回交换。集群越大,通信和同步的开销就越扎眼。
换句话说,如果计算单元还是分散在不同服务器里,靠网络传数据。那卡变多了,有效算力并不会等比例变多。
超节点改的不是把 8 卡服务器一路扩到 4096 卡。它没那么简单。它动的是计算单元之间的连接和协作方式。让分散的算力在硬件和软件上都更像一台机器。
在符合这套架构的系统里,算力单元可以访问统一的内存共享池。它靠全局地址空间跨物理节点取数。传统集群里的数据,往往还得走网络协议在节点之间搬运。
华为马尔科夫实验室的仿真给出一组对比。同样是十万卡集群。由 4000 卡超节点组成的系统,算力利用率能到 2.75 倍。对比的是传统 8 卡集群。
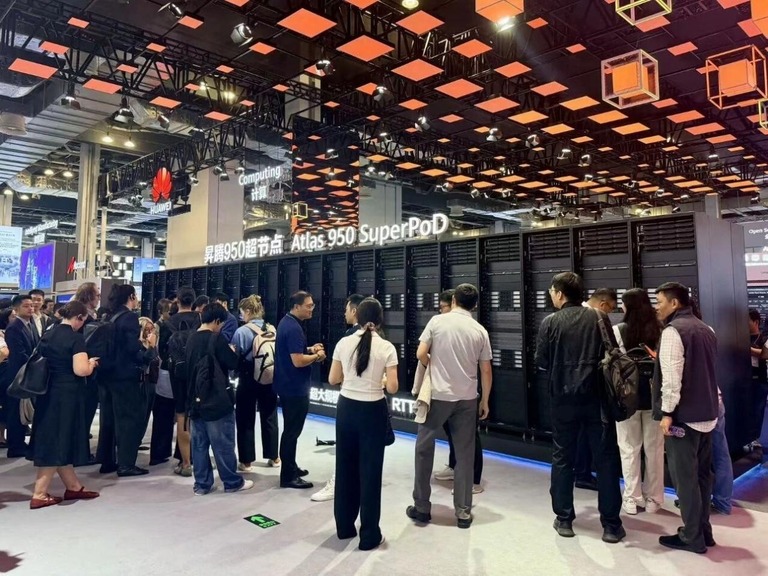
按白皮书定义的这类产品,已经开始批量落地。截至目前,昇腾 910C 超节点部署超过 1000 套。昇腾 950 超节点进入规模商用。互联网和运营商在用。金融、教育和医疗等行业也在用。
从标准到落地,超节点正从概念走进现实。可规模一大,卡间要交换的数据量跟着暴涨。带宽、时延和可靠性,要求都水涨船高。互联的工程难度开始集中冒出来。
把光引擎搬到算力身边
现在大规模算力集群内部主要靠铜缆做电互联。当高速串行接口的速率冲到 224G 及以上,传统电互联方案就有点扛不住了。
速率越高,铜缆里的损耗越明显,信号能跑的距离也越来越短。几千根高速铜缆挤在一个高密度系统里。布线、散热和维护都会变得麻烦。
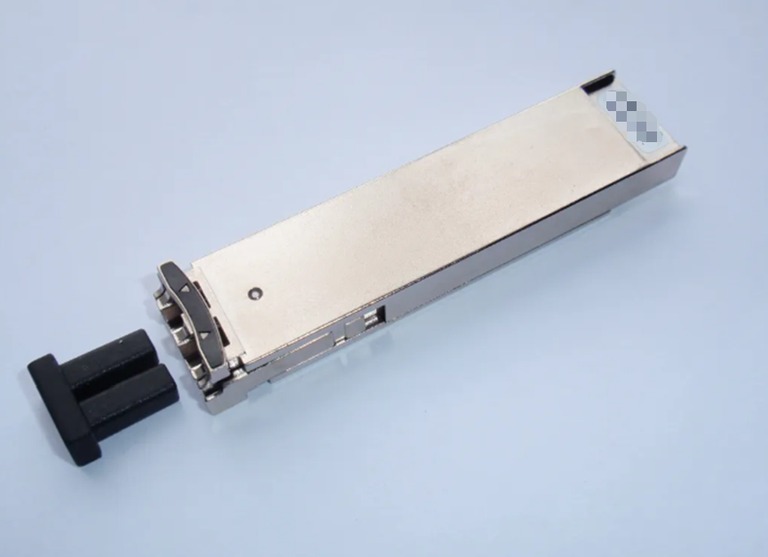
于是行业把目光投向光。在此之前,数据中心的光互连长期依赖可插拔光模块。光模块是一个独立器件,插在设备面板上。信号先沿着电路板走一段,到接口处再完成电光转换,然后进光纤。
可插拔的好处是标准化、好维护。坏了自己换一个就行。这也是它统治数据中心互联二十多年的原因。但它有个先天弱点。电信号从计算单元走到模块,要经过一段很长的电路板路径。速率一提,这段走线带来的麻烦就变得难以忍受。
近封装光学想改的正是这一段。思路很直接。把光引擎挪到计算单元边缘,让电信号尽早变成光信号。
原本要在电路板上跑很远的信号,现在在离计算卡更近的位置就完成光电转换。剩下的长距离,交给光纤。
对超节点来说,这意味着电连接的路径可以更短,带宽反而更高。互联功耗和时延一起往下走。高密度系统里的布线,散热压力也跟着缓解。
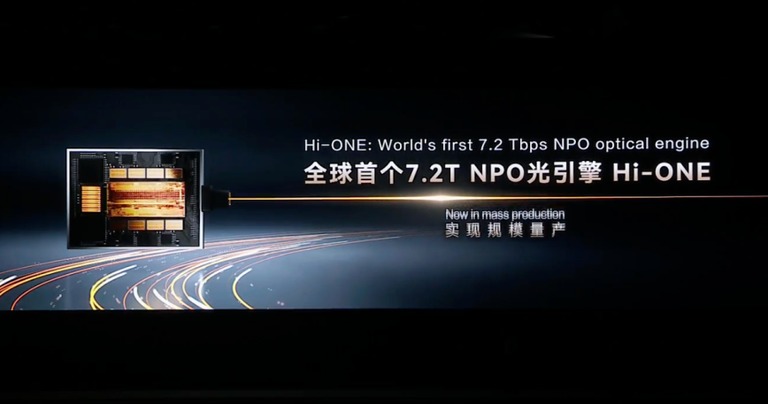
华为的 Hi-ONE 就是这条路线上的一次工程化尝试。汪涛说,这是业界首个量产的近封装光学产品。它的传输能力目前最大。也是唯一把光源做进模块里的。
Hi-ONE 的带宽达到 7.2Tb/s,由 36 个 200G 通道集成而来。一个这样的模块,能替代 9 个 800G 光模块。
对动辄几千个计算单元的超节点来说,互联器件本身就是系统复杂度的来源。器件数量降下来,布线复杂度、功耗和潜在故障点会同步减少。
眼下近封装光学还有一个痛点是标准缺位。光引擎贴近计算单元之后,封装形式,接口规格,光源方案都没有统一约定。各家方案互不兼容,产业链没法分工放量。成本自然下不来。
在产业标准层面,华为在全球光互联标准组织 OIF 提出了相关立项建议。不少伙伴给了正面响应。它参与推动的《12.8Tb/s 光电近封装模块》提案,已经在 OIF 立项。未来有望形成统一的行业标准。6.4T 和 12.8T 两档。
4096 张卡怎么像一台计算机
超节点定义回答的是什么是一台机器。近封装光学解决的是机器内部怎么通信。昇腾 960 要回答的,是最后一步。这两件事能不能真的拼成一个系统。
昇腾 960 超节点基于灵衢和 Hi-ONE 打造。它用正交架构,全液冷散热。灵衢负责内存统一编址。4096 颗算力卡,在逻辑上融成一台超级计算机。
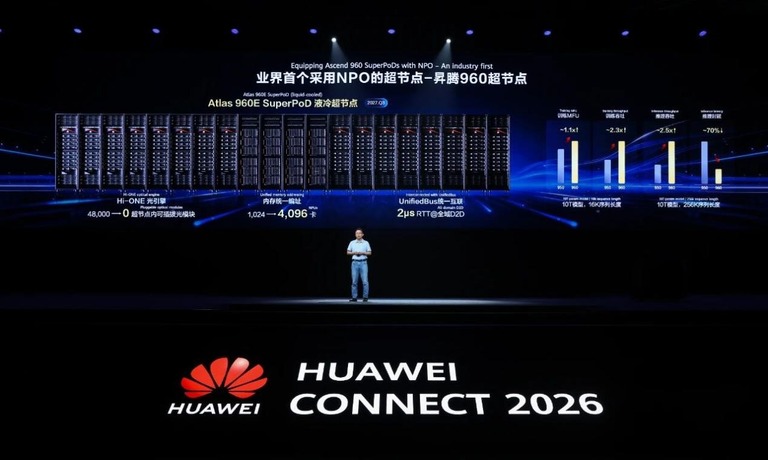
具体到实现层面,这套系统用了大约 5500 个 Hi-ONE。原本需要 4.8 万个 800G 光模块。模块数量降到约九分之一。光模块少了,连接器件和潜在故障点跟着少。互联本身的能耗也降了。
正交架构让计算板与交换板垂直相对,直接互联。板间路径大幅缩短,损耗更低,信号完整性更好。再叠上全液冷,4096 卡这样的高密度部署才成为可能。
先看规格。昇腾 960 超节点最多能扩到 4096 卡。八位精度下,算力是每秒八百亿亿次。换成四位精度,这个数字还会翻倍。显存容量最高到 1PB。节点之间往返一趟,时延最低 2 微秒。上一代昇腾 950 超节点是 1024 卡。到这一代,规模翻了四倍。
训练大模型时,权重和梯度,优化器状态和中间激活值,都得塞进显存。这些参数意味着,单个超节点能装下的模型体量上了一个台阶。跨节点切分带来的通信开销,也有望大幅下降。
按公开数据,这套系统的功耗降低超过 550 千瓦。可用度达到 99.8%。无故障运行时间翻了一倍。对跑十万卡级集群的企业来说,省下的都是真金白银。
到这里,规模扩大的问题算是回答了。4096 张计算卡可以被组织成一个逻辑整体。但更大的集群不可能只靠一台 4096 卡的超级计算机完成。新问题又来了。
4096 卡之后,难的是再把它们连起来
有了 4096 卡超节点,更大集群要解决的是节点之间的互联。也就是向外扩展。跨过这一步,十万卡集群才算真正成立。
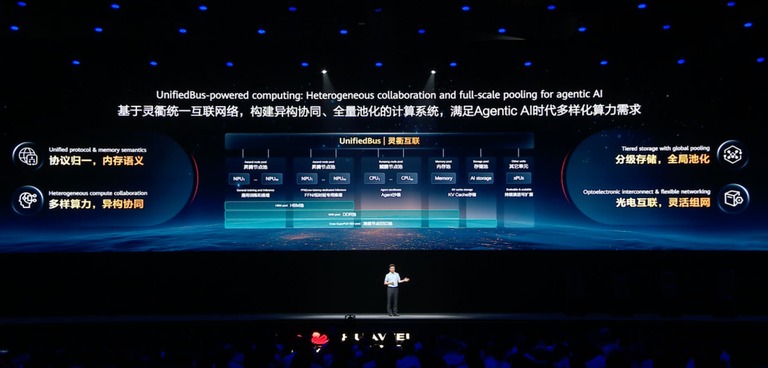
这正是灵衢统一互联架构想解决的问题。灵衢把十几种互联协议收进同一套体系,减少了协议之间的转换开销。互联带宽从百 GB 级拉到 TB 级。往返时延从 7 微秒压到 2 微秒。
基于灵衢,多个昇腾 960 超节点能连在一起。走灵衢网络可以,走通用的高速以太网也可以。这样就能搭出超节点集群。采用多层交换组网,灵衢支持的最大集群规模可达 51.2 万卡。再结合多轨道拓扑,最大可支持 100 万卡的集群。
但集群的挑战不止于连得更多。更大规模的算力集群不是某一类芯片的独角戏。算力芯片之外,处理器和内存和存储同样重要。而在传统体系里,这些资源各用各的互联协议。规模越大,协议转换和跨节点通信的开销就越突出。
灵衢想做的是打掉不同计算资源之间的边界。在这一体系下,昇腾超节点和鲲鹏超节点,加上键值缓存集群,这些子系统平等互联。处理器和算力芯片,内存和存储,都不再是各自独立的资源。它们靠统一协议协同。
这个需求在智能体时代变得更加迫切。不管是在 AI对话,还是让它自动干活。一个智能体跑起来,可能同时要干好几件事。调用模型,启动沙箱,查数据库,还要做向量检索。数据在计算芯片、内存和存储之间不停倒手。
所以通算与智算的融合,成了超节点往更大规模演进的方向。升级后的鲲鹏超节点基于灵衢全光组网。最大支持 4096 个节点。统一内存池做到 256TB。在智能体场景里,十万级沙箱启动比传统服务器方案快 30 倍。百亿千维的复杂向量检索,效率也翻了一倍。
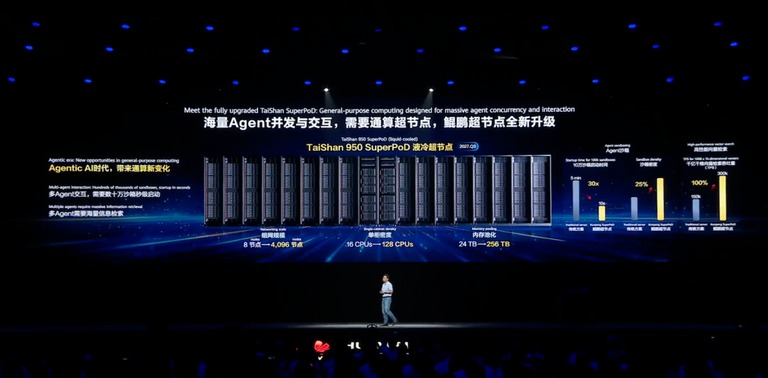
从单台 4096 卡超节点,到 51.2 万卡,再到 100 万卡。算力基础设施的边界不断往外推。贯穿其中的,是同一套互联体系。
十万卡之后,拼的是系统工程
回到开头那个问题。十万张卡,为什么跑不出十万张卡的算力。
因为规模上去之后,卡住有效算力的早就不只是计算卡本身。数据怎么搬,结果怎么同步,通信和散热怎么扛,故障怎么恢复。集群运转的每个环节都在影响最终结果。任何一个环节掉队,都会拖慢整台机器的效率。
在 HC2026 大会上,汪涛反复强调一点。如今算力基础设施的竞争,已经走到复杂的、多学科的系统工程阶段。这场较量里,华为把计算和通信两块能力合在一起用。从算力芯片到超节点,从光引擎到统一互联协议,每一层都指向同一个目标。让算力真正被用起来。
