

2026 年 9 月,开发者社区被一个不会写字的模型刷屏了。
它不聊天,不写代码,也不写诗。你给它一段状态和几个问题,它只回几个带概率的判断。做这个模型的公司叫 TypeSafe AI,给它取名 Jev,定位是系统一模型。
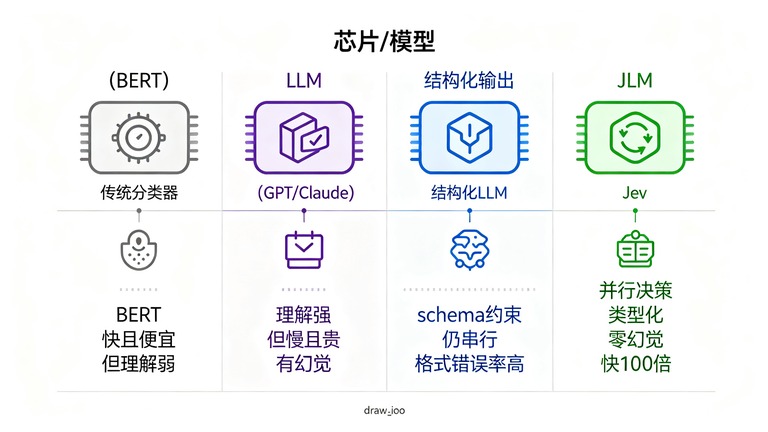
先说一个很多人踩过的坑。有家电商公司把每条客服消息都丢给大模型做意图分类。十万条工单一天,分一次烧掉八百个词元,一个月账单超过十二万。
更别扭的是,这类任务本来只需要一个答案。大模型却要先说一段「好的,我来帮你分析」,再给结论。程序还得写一堆容错逻辑,去解析那段多余的话。
我们平时用的 AI对话 产品就是这个套路。你问一句,它回一段。
这不是模型不够聪明。让一个会写文章的模型去干「是或不是」的活,等于请教授去当门卫。
Jev 要解决的就是这件事。它不生成任何自由文本。你告诉它当前的状态,再给几个结构化的问题,它直接返回类型化的答案和概率。官方口号很直白,要决策,不要文本。
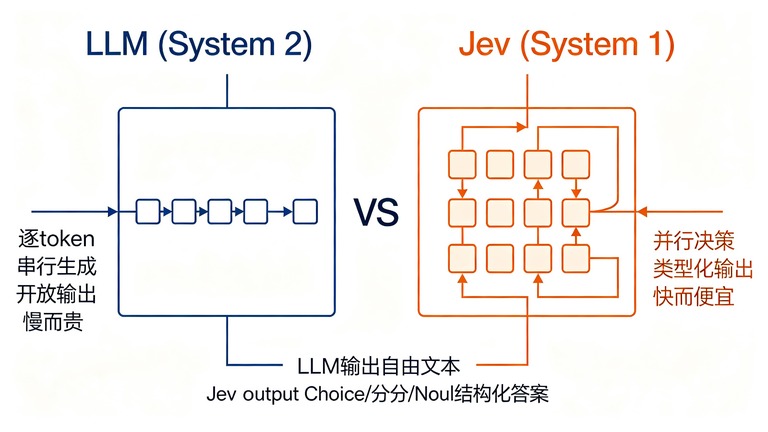
它只认三种判断方式。一种是从几个候选里挑一个。一种是按标准打分。还有一种是回答是非题,给出零到一之间的概率。
为什么它能比大模型快这么多。原因有两个。
一是它不做逐字生成。大模型是自回归的,吐一个字就要算一次。哪怕你只问一个是或不是,它也要先铺垫半句话,时间和钱都花在铺垫上。
二是它会一次回答多个问题。把一批判断同时丢进去,一次前向传播全部出结果。官方给的数据是快二十到两百倍。
还有一个差别更实在,它给出的概率经过校准。它说九成把握,长期看九成的时候确实是对的。这在工程上很重要。你可以直接按概率设阈值,比如超过零点八就自动处理,低于零点五就转人工。
对做 AI工具 的人来说,这条路线值得盯一眼。
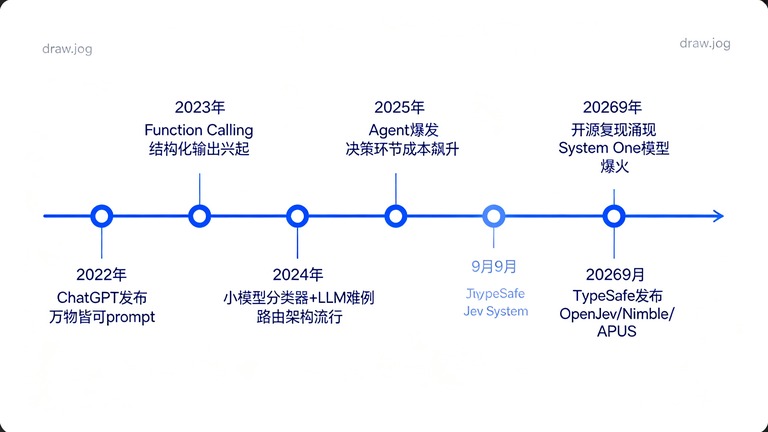
回头看,这条路走了四年。
2022 年什么任务都用提示词解决。2023 年开始有函数调用和结构化输出。2024 年流行大小模型路由。2025 年智能体爆发,每走一步都要问一次大模型,成本直接顶不住。到 2026 年 9 月,专门做决策的模型出现了。
它火得很快。发布几天,原帖浏览量破了三千七百万,十四万开发者点了关注。四天之后,开源社区就冒出一批复现。
有团队基于现成的小模型做出了对标版本,一致率报到百分之八十四。也有公司直接开源了跨平台版本,三个系统都能跑。云厂商那边也没等太久,已经把它挂上了自家的模型市场。
讲原理不如看代码。下面这段,是把大模型的部分活分出去的最小例子。
先装官方开发包,配好密钥,剩下的就是一次调用。
“`python
from typesafe_sdk import TypesafeClient, Choice, Noul
jev = TypesafeClient()
# 一次调用同时问两个问题,一起返回
decisions = jev.ask(
state={“message”: “付了钱但应用一直闪退”},
questions=[
# 挑一个:属于哪类工单
Choice(question=”主要意图”, options=[“refund”, “technical”, “billing”]),
# 是非题:要不要一小时内人工介入
Noul(question=”是否紧急”),
],
)
intent = decisions[0].selected # “technical”
urgent = decisions[1].answer # True
prob = decisions[1].probability # 0.88
“`
有了这两个判断,后面的路由就好写。紧急工单直接推人工,其余的按意图进队列。整套逻辑不依赖文本生成,也不怕格式跑偏。
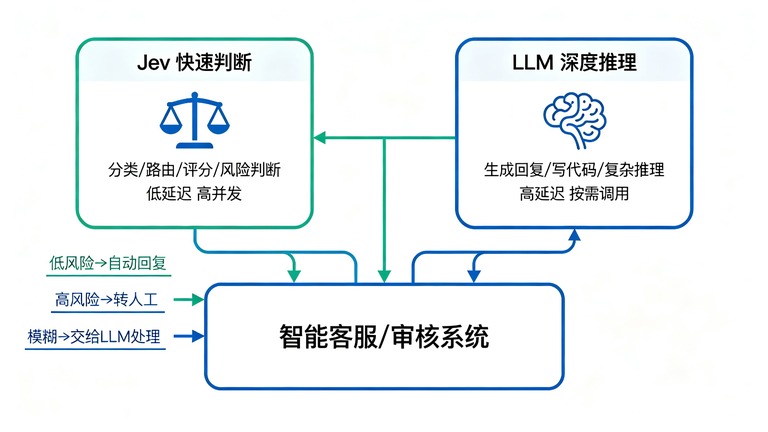
更值得学的是混合架构。让 Jev 挡在前面做门控,只有它拿不准的时候才把请求交给大模型。常见的比例是一九开。八成判断由便宜的那层处理掉,剩下的复杂问题才花钱。
落地还有几个细节。能并行就并行,把一批判断合成一次调用。阈值要按自己的业务设,别照抄别人的零点八。上线之后拿真实数据回看校准曲线,官方说概率准,也得自己验一遍。最后一条最容易被忽略,别拿它写文章,它不会。
四种方案怎么选,可以一句话说完。
任务简单又固定,量还特别大,微调过的小分类器最便宜。需要理解加生成,比如写方案或者 AI编程,还是交给大模型。需要理解但只想要结构化结果,试 Jev。数据一点都不能出内网,就等开源版本成熟。
它现在主要出现在几个地方。客服路由。内容审核初筛。智能体的决策门控。批量打标。风险筛查。搜索结果排序。
这些场景有个共同点,判断的频率远高于生成的频率。
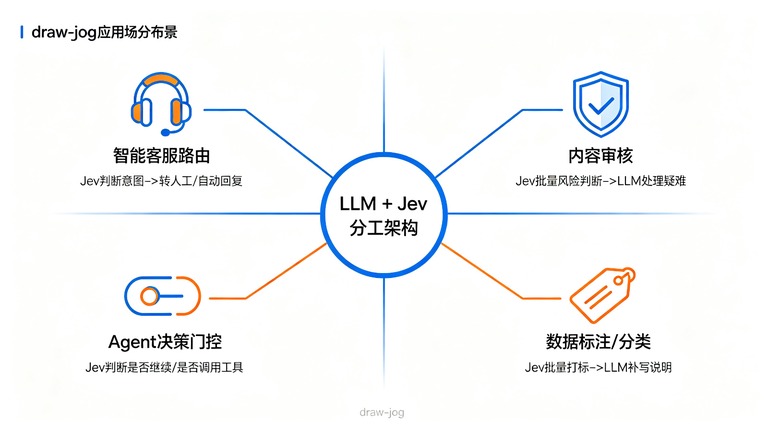
Jev 会不会是终局,不好说。但它指的方向很清楚,AI 正在从「一个模型干所有事」走向「几种模型分工协作」。
记住一句话就够了。大模型负责想,它负责判。
