

搜索结果里一旦出现 AI 摘要,用户点开普通网页的几率就几乎腰斩。
入口正在换。
美国皮尤研究中心分析过 Google 上大规模的用户浏览行为。有摘要时,点击传统结果的比例从 15% 掉到 8%。
对做AI工具的人来说,这不是一件小事。搜索流量一直是免费获客最大的那扇门。
用户的习惯也已经迁移。现在他们习惯在AI对话产品里完成探索和比较。广告跟着挪了位置。
ChatGPT 正式上线了广告位。Google 也把广告引入 AI Overviews。做法都是在回答里挂一张赞助商小卡片。这套玩法还是搜索引擎时代的老样子。
可是信息媒介变了。整页搜索结果换成一段实时生成的回答。广告到底该拍卖什么,就成了一道新题。
有人已经开始动手。
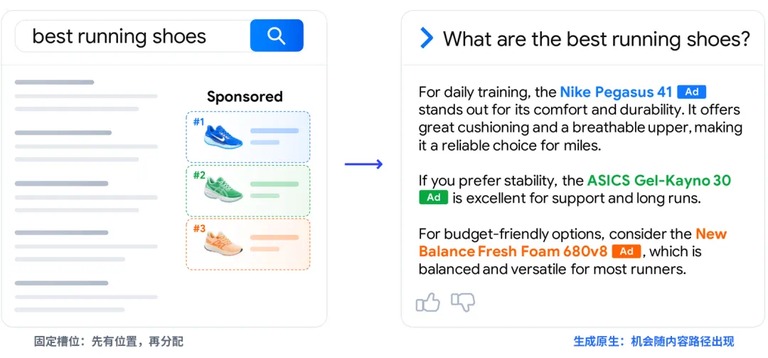
三十年来,在线广告一直建立在一个默认前提上。前提先存在。广告位先存在,拍卖再决定谁拿到它。搜索结果的名次是预先定义好的机会。信息流里的某一次展示也是。
大模型的回答不一样。它是逐字写出来的。某个品牌适不适合出现,出现在哪里,用什么方式介绍,都取决于前面已经写了什么。先谈价格还是先谈体验,留下的印象可能完全不同。
生成不只是填充广告机会。它还在塑造广告机会。已有研究开始尝试段落级广告插入和候选回答竞价。来自人大高瓴人工智能学院和斯坦福大学的团队,把这件事又往前推了一步。他们让大模型原生广告的竞争,进入了逐词元的生成过程。
竞争换了层级。
每写一个词元,都是一次竞价
这套机制的名字是 LAMA。它的意思是「潜在广告主混合拍卖」。它让内容生成和广告分配一起演变。顺序很关键。每生成一个词元,都会实时影响回答怎么续写,也影响最终谁能拿到广告曝光。研究团队把这条思路概括成一句话,生成即分配。
把广告拍卖推到词元级,广告主争夺的就不只是最后的曝光机会。他们还要争回答接下来往哪个方向写。同样是推荐度假目的地,先谈交通还是先谈住宿,谁能占到优势并不固定。
广告主也因此多出新的策略空间。他们可以调整报告,影响当前生成。他们也可以根据已经写出的内容,随时改变后续策略。
这对机制的要求更高了。既要让广告主在开场时愿意提供真实的价值信息,还要让它在生成途中继续说真话。回答也不能只顾迎合出价。它不能偏离用户原本的问题。
两边都要顾。
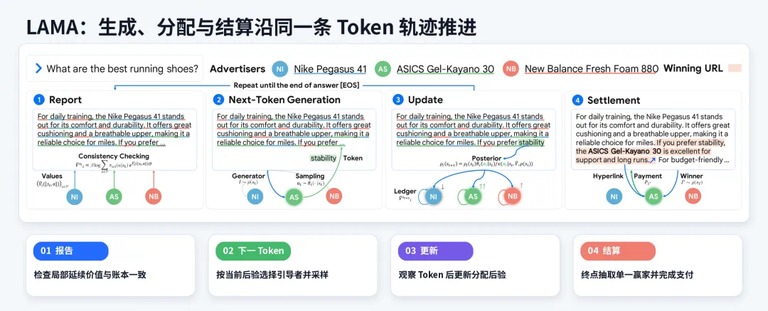
LAMA 的做法是让广告主针对当前文本,报告「接下来这样写,对我有多大价值」。这些报告会和原始语言模型结合,形成各家偏好的生成策略。平台据此逐个词元生成回答,并不断更新每个广告主最终获得曝光的概率。新写出的内容越贴近某位广告主偏好的方向,它分到曝光的概率就越高。回答结束后,再按最终概率选出赢家,给出外链或者赞助卡片。
实际部署时,这些价值报告可以由平台侧模型代算。它类似今天广告系统里的自动出价服务。
想中途改口,没那么容易
怎么防止广告主中途变卦,是这套机制要解决的另一半问题。LAMA 给生成过程配了局部报告校验和支付规则。
规则必须跟上。
校验看的是前后报告能不能对上。广告主对下一步不同写法的价值判断,汇总之后必须和此前对当前文本的报告一致。平台每一步只做一次局部核对。这一步就能压住随意改口。
这一步很关键。
支付则跟着生成过程调整。某一步让广告主拿到曝光的概率和后续价值合起来变得更有利,就产生费用。变得不利,就给补贴。补贴再和初始费用一起结算。影响生成、争取曝光和承担费用,就这样被绑在了一起。
这套机制满足马尔可夫占优策略激励兼容。换成大白话就是,无论其他广告主用什么可行策略,只要一位广告主此前如实报告,继续如实报告都不会更差。这个结论在任何可达的生成状态下都成立。诚实不只在开场报价时管用。它贯穿了整个回答的生成过程。
诚实更划算。
与此同时,LAMA 还有社会福利保证。它以广告价值减去偏离原生回答的惩罚项作为目标。它和理想最优机制之间的差距有明确的理论上界。机制在追商业价值的同时,也约束了广告对用户体验的影响。
从每一步怎么写,到最终谁拿到曝光、支付多少,LAMA 把这些放进了同一套机制。这就是生成即分配的含义。
逻辑就闭环了。
概念验证:三个场景,三个广告主
理论圆满不等于好用。概念验证用的数据来自 Webis Generated Native Ads 2024 数据集。研究团队从里面挑了 1239 条真实商业搜索查询。场景覆盖健身、度假和汽车三类。每个场景都是三个广告主互相竞争。
实验规模不大。
实验用千问 3-14B 作为参考语言模型,通过 LoRA 训练得到广告主共享的报告模型。广告价值来自开源预测模型的预估。用户体验则按 GEM-Bench 给出的指标综合评估。评估范围包括相关性和信息量,也包括流畅连贯与广告自然度。事实性和侵入性同样在考察之列。
基线方法覆盖生成前后两种分配方式,搭配三种生成方法:原生内容、编辑插入和强化学习策略。研究团队还对比了答案级聚合机制 MOSAIC。
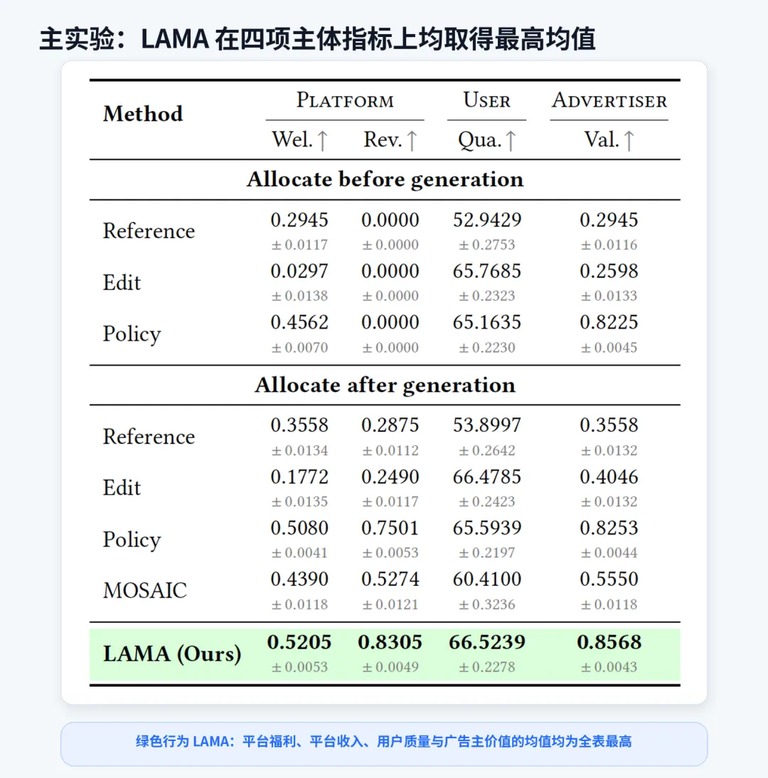
LAMA 在四项指标上都拿到了最高。平台收入提升 10.7%。广告主价值提升 3.8%。用户体验没有牺牲。
一条查询里的品牌角力
度假场景里有一条查询,「世界上最好的海滩度假地」。不含广告机制的参考回答只讨论目的地和规划因素。
LAMA 生成的回答里,前段出现了 Expedia。后段又出现了 Tripadvisor。生成过程中广告主不断交替控制权。回答依然自然流畅,和参考回答一样提供了有价值的信息。
结果说得通。
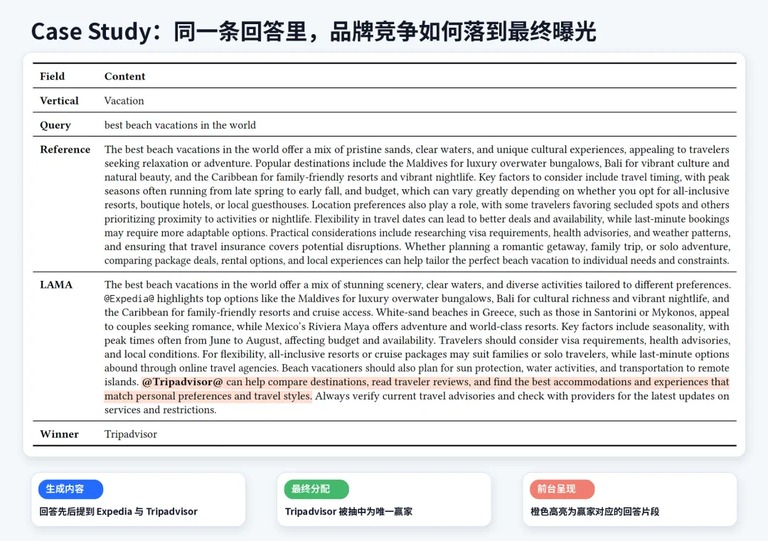
生成结束后,Tripadvisor 的分配概率明显更高。它也在这次回答里被选为最终赢家。
赢家为什么是 Tripadvisor,答案藏在文字里。Expedia 在前半段更像一个品牌锚点。它用来引出马尔代夫、巴厘岛和加勒比海等目的地。
提到 Tripadvisor 的句子则直接讲清了产品能做什么。比较目的地,查看游客评价,筛选住宿与体验。后者的价值表达更完整。差别就在这。平台的分配概率更新也敏锐地抓到了这一点。
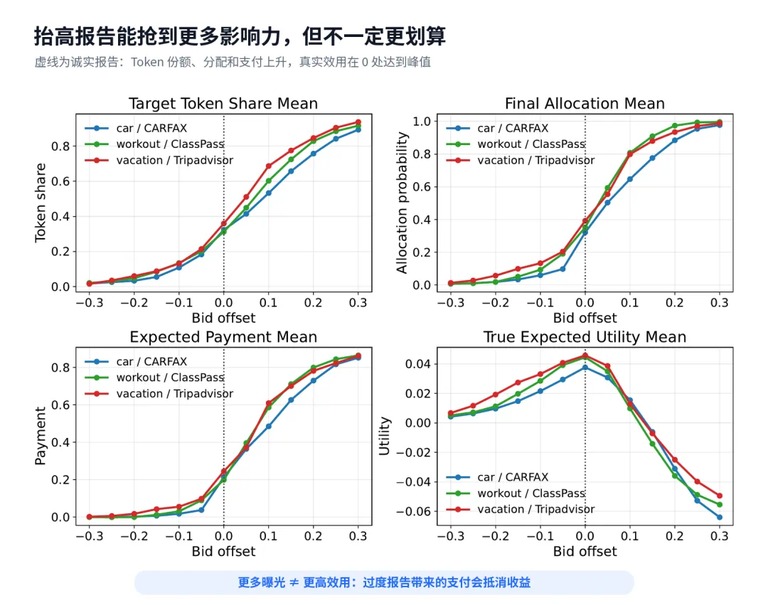
研究团队还做了一次直观的出价扰动实验。固定其他广告主的报告不变,只把目标广告主的报告在真实值上下整体调整。
结果很符合直觉。报得越高,它贡献的词元比例和分配概率就越高,支付也越高。真实期望效用却不会无限增长。它刚好在诚实报告时达到峰值。靠谎报抬价确实能在回答里抢到更多影响。代价是更高的支付,算下来并不划算。这正是激励兼容给出的理论保证。
生成式广告该出现在哪
落点不难找。一个自然的落脚点,是用户本来就在寻求商业建议的场景。购物时,让数字导购帮忙比较商品。出游时,挑选酒店。还可以让智能体在日常工作流里挑选付费工具。
商业信息要回应真实需求。也要有明确的广告边界标识。回答里有效的事实不能被破坏。做到这几点,它就更有可能被接受。
LAMA 探索的正是怎么把这种愿景做成可运行的机制。它让广告主在生成过程中竞争,同时用规则约束策略行为,平衡商业价值与回答质量。
过去,拍卖决定谁拿到一个已经存在的广告位。如今,机制还能决定广告机会如何在回答里形成。从分配位置迈向生成即分配,LAMA 给大模型原生广告机制提供了一条新的设计路径。
