

这是港大 MMLab 和 Kinetix AI 的论文题图,讲的是从野生人类经验里学灵巧操作。
如果给机器人看的训练视频来自乱糟糟的厨房。
镜头还跟着人一起晃。
它还能学会拆快递吗。
香港大学 MMLab 团队说能。
他们提了一套叫 EgoWild2Dex 的方法。
直接用 538.9 小时没经过编排的人类第一视角视频。
去训练一台双臂机器人。
每个下游任务只用不到 1 小时真机数据。
拆快递。
用热熔胶枪把断掉的手办粘回去。
铲冰调一杯冷饮。
平均成功率 96.7%。
纸箱是软的。
胶带会粘住刀。
冰块会滑,杯口还得对准。
这些活拆开看都是小事。
串起来就是长时序任务。
论文已经挂在 arXiv 上。
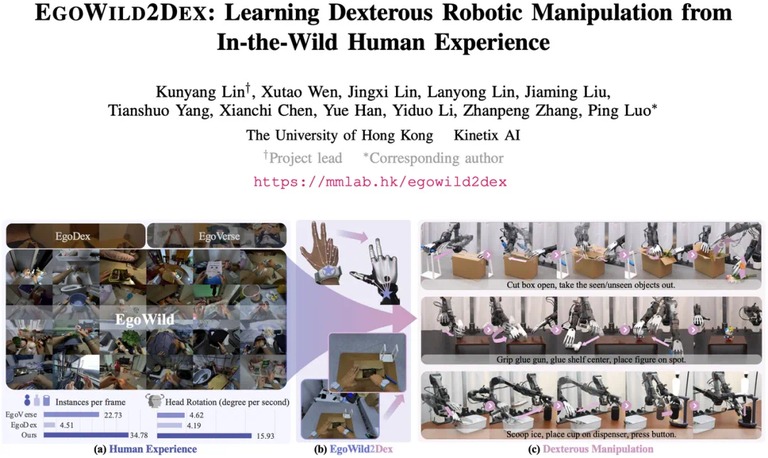
论文的题目和作者名单,来自港大和 Kinetix AI。
数据脏,但脏得真实
机器人学得慢,卡在数据太贵。
要让机器人学会复杂操作。
得有人在真机上反复遥操作。
采一条专家轨迹。
背后往往跟着一堆失败轨迹。
任务一旦涉及双臂协同。
涉及工具、精细接触和长时序。
成本还要往上翻。
可人类每天都在真实世界里干这些活。
拆包。
理货。
装零件。
拿工具。
调饮品。
这些动作本身就是现成的操作经验。
于是这几年,用第一视角人类视频训练机器人成了热门方向。
问题是,之前的数据集大多在受控环境里采。
任务预先设计好。
背景干净。
镜头稳。
机器人真正部署时遇到的却是另一套。
EgoWild2Dex 换了个做法。
不要求把画面拍干净。
直接进真实环境。
记录人本来就在做的事。
家庭。
工厂。
药房。
医院。
超市。
包裹站。
这些视频没人刻意稳住镜头。
人一走路画面就晃。
低头转身,全是变化。
数据里,每秒累计头部旋转角度平均 15.93 度。
每帧图像平均包含 34.78 个不同物体实例。
按传统机器人数据的标准,这批数据很脏。
但这里的脏不是标错或者质量差。
是它把真实世界本来的复杂留下来了。
镜头的晃动,本来是个麻烦。
物体多,背景乱,也不利于对齐。
可研究团队的想法反过来。
这些不方便,恰是机器人出门以后要面对的。
实验室里练出来的本事,换个房间就废。
数据越干净,落地越挑环境。
这条路上,宁可要真实,也别要漂亮。
代价是模型更难训。
收益是数据几乎不用再花钱。
图省事就别碰这批素材。
换句话说,稀缺的不是算力,是人的操作。
一台机器人一天能采的数据有限。
一个人一天干的活却很多。
把人类视频当成矿,比从零采矿便宜得多。
为此,这套方法里加了一个几何变换模块。
它把人在移动时看到的画面,变换成接近机器人相机的样子。
靠的是学习两种视角之间的几何关系。
不用人刻意稳住相机。
跟传统那套先标定再重投影的办法比。
它不太吃精确标定。
处理速度快了 21.9 倍。
对齐效果也更好。
对做 AI编程 的人来说,这有点像把手工活挪进了网络层。
少一步标定,就少一处误差源。
现场采集的人也不必懂相机参数。
拿起手机就能录。
录完直接进训练。
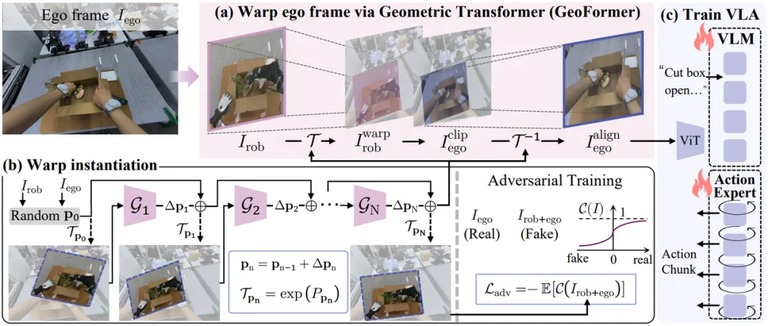
GeoFormer 的视角对齐与训练流程,先预测人与机器人之间的几何关系,再逐级优化变换参数,最后把对齐后的数据拿去训练策略。
这一步是整套方法里最讨巧的地方。
它把最难的对齐交给了一个可微模块。
人不用为了迁就机器端着手机走路。
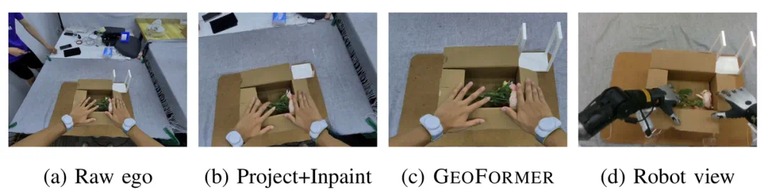
GeoFormer 把晃动的人类画面,对齐到接近机器人相机的视角。
视角对上了,动作还没对上。
人抓杯子和机械臂抓杯子,走的是两套关节。
EgoWild2Dex 用动作重定向加逆运动学。
把三类数据塞进同一个动作空间。
一类是自然环境里采的人类第一视角数据。
一类是在机器人视角下戴手套演示的数据。
一类是真机演示。
归一到同一套表示之后。
它们就能一起参与策略训练。
这一步听着像工程细节。
其实是能不能混着训的前提。
三类数据映射到同一套机器人原生动作空间。
两个不对齐,两条补丁
训练是一条渐进的路。
第一步,用大规模人类第一视角数据预训练。
这一步不要求数据来自机器人最后要干的活。
模型由此见到更多场景、物体和操作方式。
学到的是通用的视觉与操作先验。
第二步,人机协同训练。
在预训练的基础上,加进与任务相关的第一视角数据。
再加手套演示和少量真机数据。
靠统一的动作空间,人类的经验开始和具体任务对上号。
第三步,真机精调。
用少量真实示范和恢复轨迹微调。
让模型适应真实机器人身上的接触、动力学和执行误差。
三步走完,每个任务用的真机数据不到 1 小时。
对做 AI工具 的人来说,这个数字很关键。
过去卡住这条路的,就是真机数据的价格。
现在它从主料变成了调料。
预训练那一步最费数据。
也最不挑数据。
后面两步才开始挑。
先广后精,顺序不能反。
这条经验在别的任务上也成立。
数据在手,模型才有得挑。
反过来,先精后广,模型容易学死。
所以顺序比配方更要紧。
第一视角数据、手套演示和真机数据,是这条流水线的三种原料。
数据集这一块,团队同步放出了 EgoWild。
这里的脏,同样不是标注错误。
是数据没有回避真实环境里的复杂因素。
采集地点就是家庭和工厂。
也有药房和医院。
还有超市和包裹站。
物体分布是长尾的。
操作流程也是人自己随手定的。
除了语言标注,它还带全身人体姿态和手部关节。
操作行为被分成原子动作、动作指令和技能指令三层。
数据处理流程专门优化过手部动作识别和人体滑步。
相机怎么晃,它就怎么记。
没有后期修图这一步。
长尾物体也没被剪掉。
这些细节在训练时都用得上。
监督信息因此更干净一点。
EgoWild 记录家庭、工厂和超市里的自然操作,镜头会动,背景也乱。
538 小时换了 96.7% 成功率
真机实验做了三个长时序双臂任务。
第一个是用美工刀划开胶带开箱。
第二个是热熔胶枪固定摆件。
第三个是铲子铲冰做冷饮。
这三个任务都不短。
一步错,后面全废。
平均任务成功率 96.7%。
它还能应付中途的打扰。
手指卡住了,它会换个角度再试。
人把花放回去,它接着往下做。
在开箱任务里,团队还试了没见过的物体。
零样本泛化成功率 33.3%。
同一个框架,从松灵机械臂迁到另一台双臂机器人。
迁过去也能用。
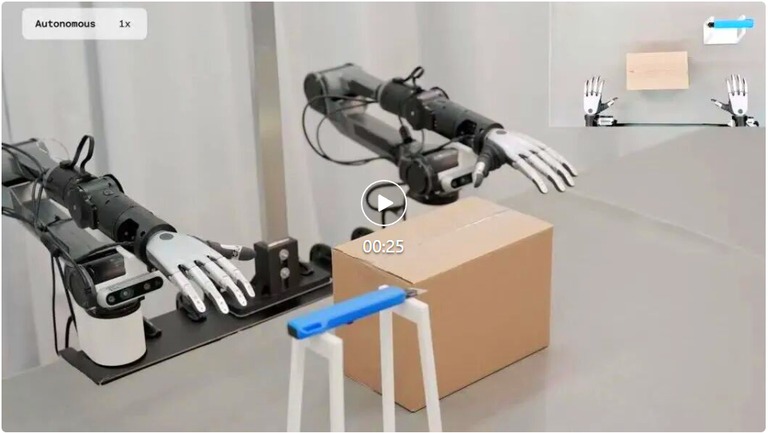
连续完成抓取工具和划开胶带,再打开箱盖取出物体。
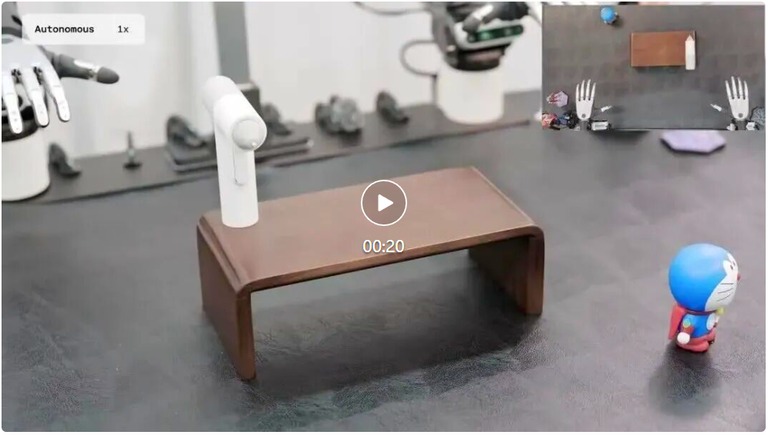
双手协同操作胶枪和摆件,对准和施胶之后抓取固定。
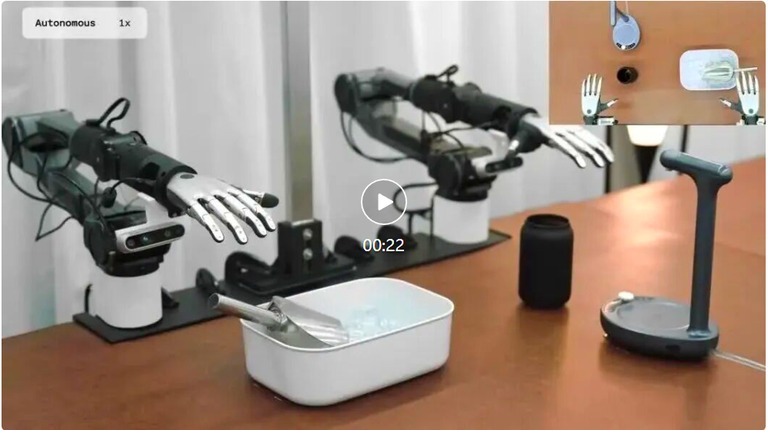
舀冰和倒冰,持杯对准出水口,再接下整杯水。
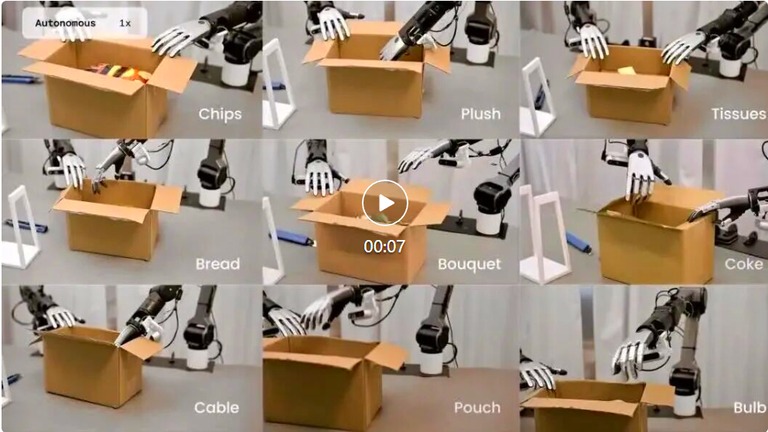
箱子里是没见过的物体,它仍然会伸手去试。
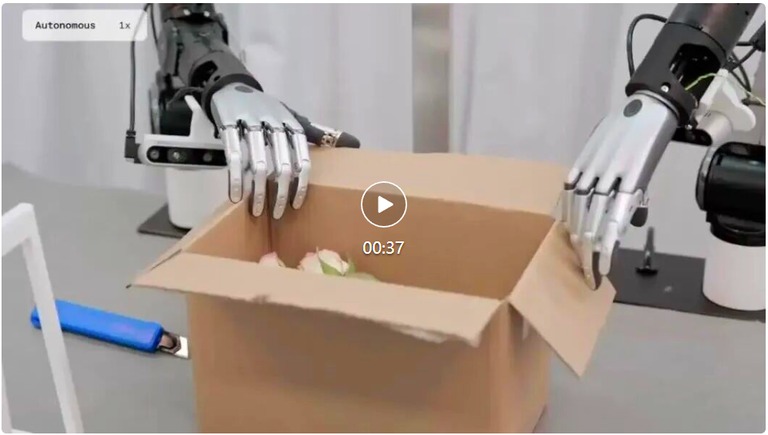
手指卡住之后,它自己调整动作,把后面的步骤走完。
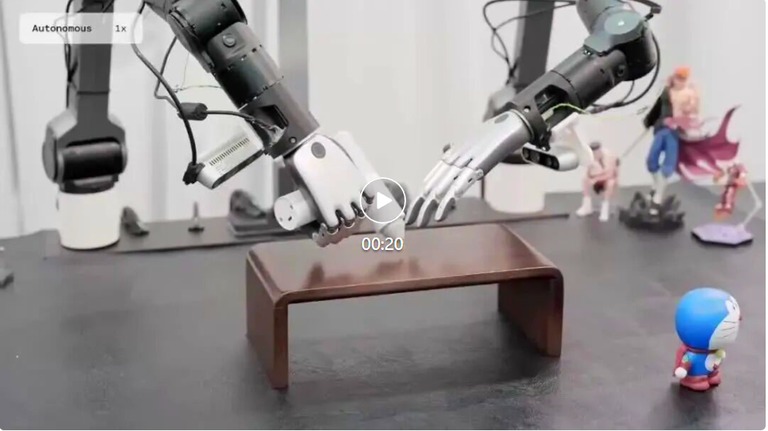
抓到的摆件被拿走,它重新调整手臂和手,再抓一次。
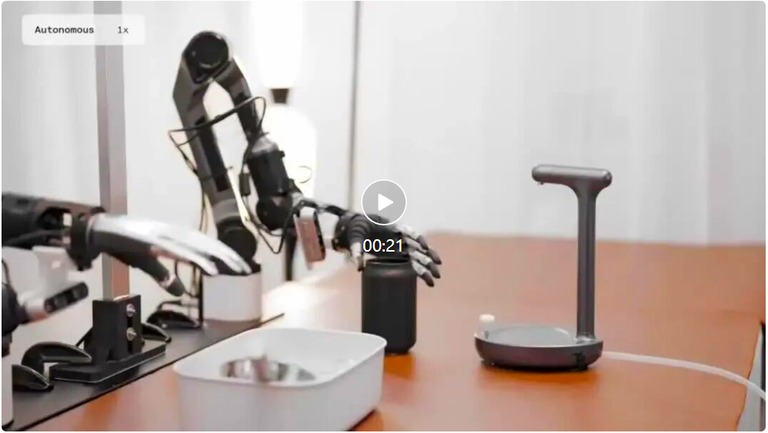
杯子被人拿走,它重新找到杯子,接着把水倒完。
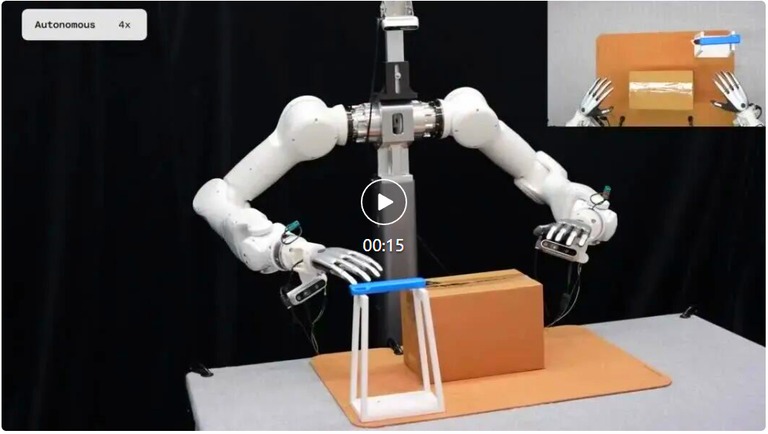
从一台机械臂换到另一台,整套流程照样跑得通。
值钱的是数据来源
EgoWild2Dex 最值得看的地方。
不是某一个任务的成功率。
是它把训练数据的来源拓宽了。
除了昂贵的真机演示。
人日常干活的过程也能当素材。
当然,从人类视频到稳定的机器人策略。
中间还隔着视角、本体和动力学。
这几道坎没有一道是白送的。
就像做 AI对话 的人常说的。
输入越贴近真实,后面越省事。
如果这批数据能被更高效地用起来。
机器人能拿到的数据规模会大一个量级。
这只是第一步。
真正的考验在更多任务和更多机器上。
