

英伟达把 Nemotron 3.5 Bolt 的权重放了出来。
740 亿参数的模型,原本要占 148GB,现在只剩 22.1GB。
一刀砍掉约 85%,目标就是能装进 24GB 显存的那一档笔记本。
读图写代码调工具,这些 AI工具能干的活现在可以留在本机干。
以前这类活必须连云端,网络一抖,智能体就卡在半路。
中间还要为每一次请求多付一笔延迟。
本地跑的意义,就在这几秒。
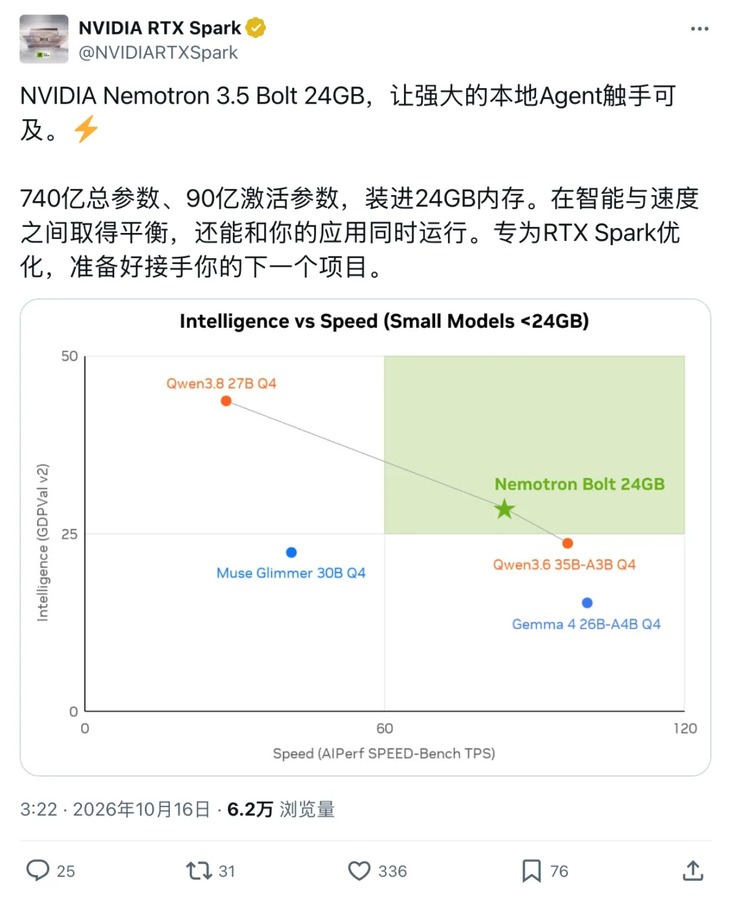
官方推文配图,740 亿总参数和 90 亿激活摆在一起
模型放出,电脑也在同一个月开卖。
10 月 16 日,搭载 RTX Spark 的笔记本全球发售。
联想和微软的新机一起上了。
大模型和新电脑,老黄一起端出来。
两件事挨得这么近,不像巧合。
本地跑智能体过去卡在两头,模型太大装不下,机器太弱跑不动。
现在两头一起松。
先有能塞进去的模型,才有愿意买单的机器。
顺序很重要。
原文配图,画面里没有可读文字
龙虾大脑搬家,笔记本接活
一句帮我改下代码递到智能体手里,往往要忙好几轮。
先读文件,再找位置,动手改完,运行报错还得回头重来。
每走一步,背后的模型都要再想一轮。
推理全在云端,AI对话的请求就得来回跑。
Bolt 想接下的,正是这些能留在电脑上的日常活。
它每次生成只激活约 90 亿参数,740 亿的家底都还在。
工具调用支持,图片和视频输入也支持,代码和图表都能读。
训练时团队让它进模拟环境练工具操作,学的是少绕弯。
智能体少走一次弯路,屏幕前的人就少等一轮。
这台机器的定位很清楚,不是替代云端,是把顺手的小活留在手边。
大任务照样上云,小任务不必再排队。
换个说法,先把最常做的那几件事搬回本地。
这也是笔记本第一次被当成干活的机器来配。
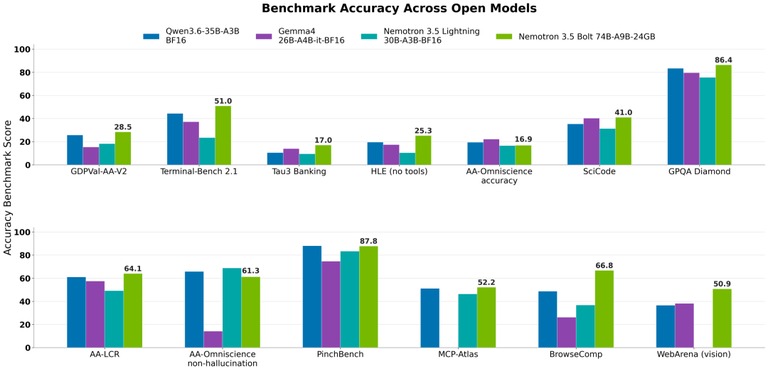
各家开源模型的准确率横比,Bolt 那根柱标着 24G 版
最终量化版 Bolt,在终端操作测试里拿到 50.98%。
在上网找信息的测试里,它拿到 66.75%。
这两门都是智能体接活时绕不开的功课。
本机的部署工具已经列出龙虾和另一个智能体框架的启动入口。
开发者可以给自己的智能体换成本地模型,联网搜索照常联网,推理交给自己的电脑。
这样文件、工具和负责推理的模型就在同一台机器上碰头。
跑分只是入场券。
能不能干活,要看接活的完整链路。
148G 压成 22.1G
Bolt 的底子来自同时发布的 1200 亿参数 Super VL。
后者每次激活 120 亿参数,面向企业智能体,图表和文档能读,视频也能读。
企业还能拿自家数据继续训练它。
到了财务平台 Ramp 手里,它被派去认小票。
商户和日期这类信息,整理成程序能读的数据。
报销时那些磨人的抄抄填填,正好交给它。
一个小票场景说明的是,企业要的不是通用聪明,是稳定的重复。
Ramp 的用法很朴素,让小票上的信息变成程序能读的字段。
磨人的抄写和不必要的回头重录,正好是它擅长的地方。
企业可以拿自家数据继续训练,这一层的空间比想象中大。
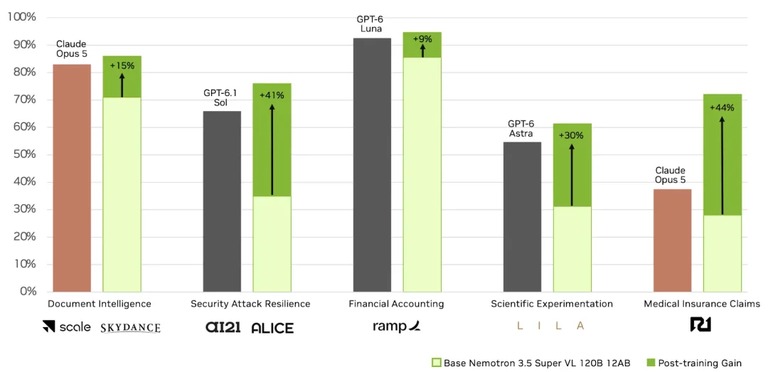
分领域的提升幅度,最高一档加了 44%
轮到 Bolt,团队要让这位大哥住进笔记本。
先动模型结构,从 1200 亿压到 740 亿,再把受损的能力练回来。
麻烦出在看屏幕上。
问题在眼力。
前面的压缩只动了语言部分,恢复训练也先保文字能力。
视觉模块接回来,和这副缩小的底子还得重新磨合。
让它按指令在屏幕上找目标,问题就露出来了。
屏幕定位测试里,父模型得分 41.6%。
刚压完还没补视觉训练的 Bolt,掉到了 0。
于是团队先用每轮约 660 万张图像训练视觉适配器。
再做视觉任务微调,把成绩拉回 39.79%。
瘦身省下的空间,差点把眼力也省掉。
这一步没有捷径。
这一步没有捷径,只能靠数据量堆回来。
一个模型瘦得快,眼睛丢得也快。
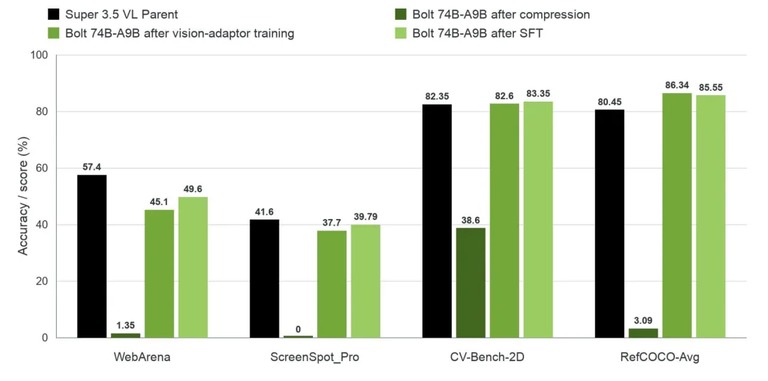
同一张测试上的三段曲线,从 41.6 掉到 0 又回到 39.79
眼力补回来了,体积还没过关。
740 亿参数按半精度保存,光权重就约 148GB。
连最高 128GB 统一内存的笔记本也装不下。
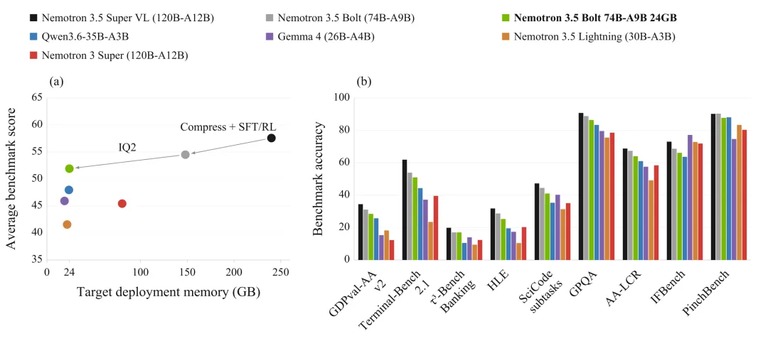
两个版本的部署门槛对比,横轴是目标内存
接下来,每个参数也得少占点地方。
占大头的专家权重压到约 2bit。
其他部分保留不同精度。
再用量化感知蒸馏向教师模型补课。
权重终于瘦到 22.1GB。
账面过关了。
同一组实验里,先把大模型练好再瘦身,比从头练小模型再量化留下的准确率更高。
装得下,还得跑得快。
Bolt 请来一个叫 LiliCorr 的小模型先打草稿。
主模型再成批验收,省掉逐个生成词的等待。
测试用的是一台 128GB 版的 Surface Laptop Ultra。
它让 Bolt 跑到约每秒 84 个词。
AI编程这类活最吃推理速度,慢一拍就得多等一轮。
这一步的取舍很直接,宁可多花一次蒸馏的算力,也别让每轮生成都等一遍。
草稿模型只负责快,验收还是主模型说了算。
换句话说,它先把容易的部分猜出来,难的再认真算。
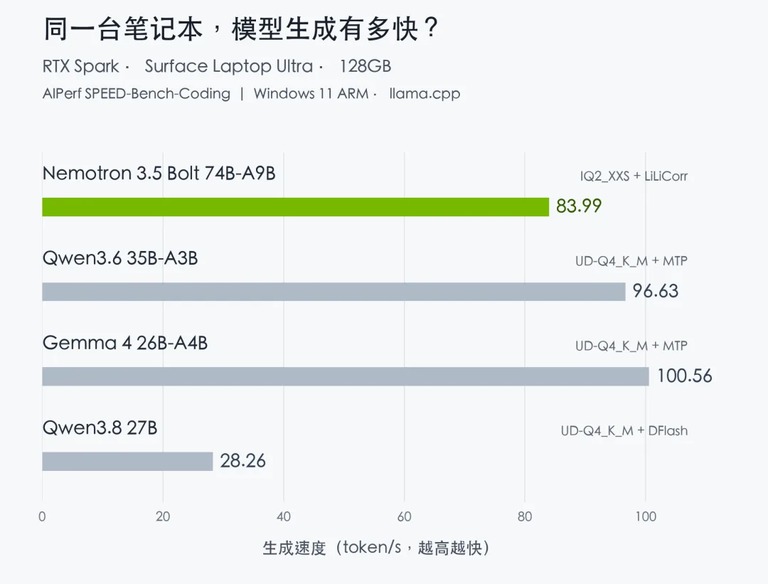
同一台笔记本上的生成速度对比,单位是每秒词数
真正配电脑时,还要给缓存和视觉模块留位置,加速小模型也占一份。
按第三方的短上下文建议,32GB 可以当规划起点。
48 到 64GB 更宽裕。
22.1GB 只是权重的账单。
整机的账单还没算。
账要算两遍,权重一遍,运行时的开销一遍。
买机器时宁可多留一档内存,也别只盯参数表上的那个数字。
实际的差别,往往出现在长上下文跑满之后。
128G 新本全球开卖
Spark 的电脑已经开卖,接下来就轮到这些模型上场。
图形核心和处理器集成在一颗超级芯片里。
两边共用最高 128GB 统一内存。
模型拼命瘦身。
电脑这边也得腾地方。
两边一起往前推,本地智能体才跑得起来。
缺一头都不行。
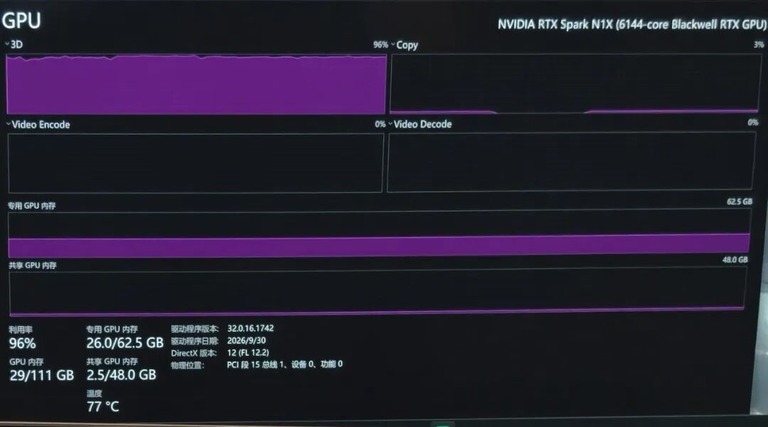
任务管理器里的显存占用,专用那一栏是 26.0 对 62.5
第三方评测拿了一份更大的模型来试这道门槛。
Ling 3.0 Flash 量化后,光权重就有 77GB。
64GB 的苹果笔记本装不下,32GB 显存的独立显卡也装不下。
只有 128GB 的这台还能继续跑。
同一张表上,装不下那一行的标注最扎眼。
门槛就写在那里。
模型的体积,先于速度决定了它能落在哪台机器上。
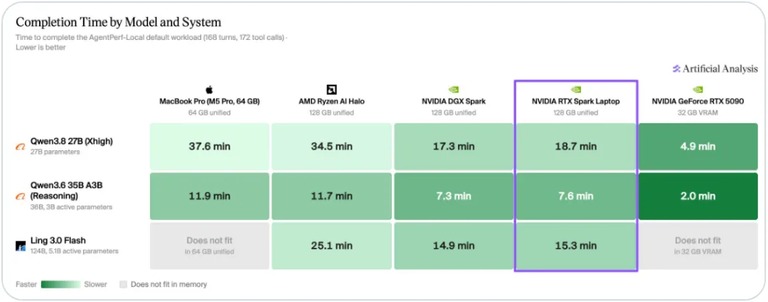
完成时间横比,装不下的那几行直接空着
旗舰显卡也会遇到这种尴尬。
算得再快,模型太大,照样进不了门。
到了本地这一档,挑电脑还得看看它的肚量。
英伟达也把龙虾和另一个框架列进了发售时的应用生态,并提供引导安装。
想让更多人养上龙虾,第一关总不能先考环境配置。
这台电脑也得照顾原来的活。
首发支持数百款游戏,图片和剪辑软件的原生支持也通过首发测试版提供。
处理完任务,还能接着剪片和打游戏。
一台机器要同时当开发和娱乐的机器,这在过去很难成立。
现在它靠一块统一内存做到了。
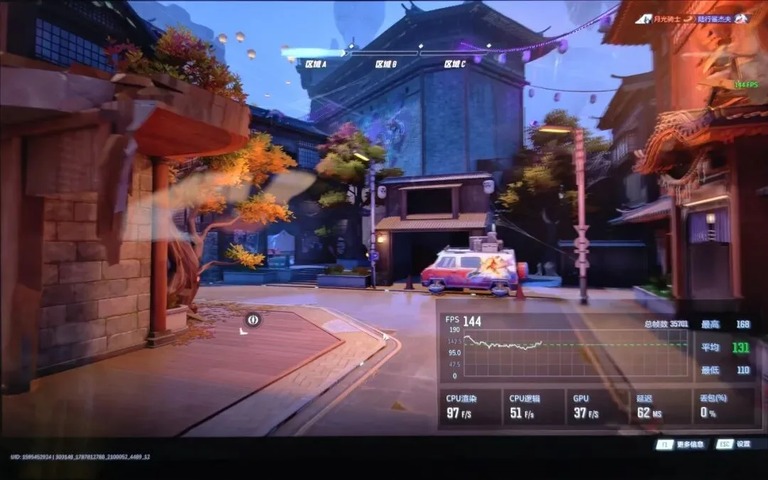
游戏画面这一档,帧率跑到 144
动图,图面没有文字
连 740 亿都嫌大,还有更小的一档。
这一档叫 E4B,计划 10 月 23 日推出。
它面向本地语音助手和交互角色这类场景。
Super VL 接企业里的复杂活。
Bolt 把日常任务搬进笔记本。
E4B 再去照顾更轻巧的设备。
这一家子,分头上班。
分工很清楚。
老黄的算盘很清楚,开放模型,让更多任务用上用户手边的图形芯片。新电脑开卖,再把这份需求接过来。
买了这么多年生产力工具,打工人的愿望也可以大胆一点。
电脑你先忙,我下班了。
模型越往小里做,落地的地方就越多。
反过来,机器越往大里做,能装的模型也越多。
两条线在一台笔记本上交汇,这才是这一轮的重点。
