

Agent 在本地跑得好好的。接上企业微信和钉钉,第三天客户开始收到两遍一模一样的回复。把AI工具接进企业,卡住的多半就是这一段。麻烦藏在平台给的那五秒里。
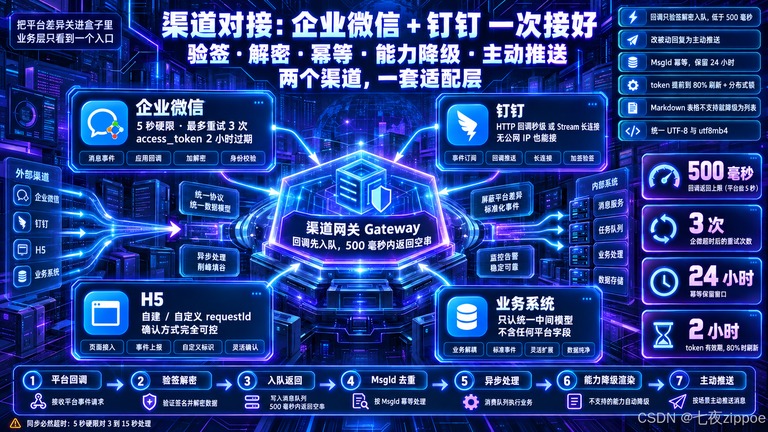
一张图看完渠道对接:回调只验签解密入队,业务层只认一个入口
平台把回调当处理器用
它不等你通知一声收到,它等你返回结果。超时就断开,然后重试。企业微信的时限是 5 秒,官方文档写得很直白,超时最多重试三次。钉钉的 HTTP 回调是秒级,建议尽快返回。
你的 Agent 处理一条消息要多久。模型思考,工具调用,知识库检索,加起来 3 到 15 秒。在回调线程里同步等这个结果,几乎必然超时。
超时的后果不是这次失败。是平台重发,你的业务系统也收到两遍同样的请求。
第二条约束更隐蔽。平台保证不丢消息,但不保证只来一次。网络抖一下,你返回慢一点,你回了个 500,都会触发重投。所以幂等不是锦上添花的优化,是接入的必需项。
第三条约束是格式。同一段回复在企业微信和钉钉上不可能长得一样。表格最典型。企业微信的 Markdown 不渲染表格,客户看到的是一堆竖线。这类内容在客服场景里天然就多,订单明细,槽位确认清单,全是表。按钮也不等价,同一个界面,两家渲染出两种样子。
这些差异一旦渗进业务代码,加一个渠道就要改一遍业务逻辑。所以先切一刀。

适配层把平台差异关进盒子,业务层只见内部消息对象
验签在前,解密在后
适配层只做三件事。收下,验签,转成内部消息对象。每家一个接收器,各写各的验签和解密,出门统一成同一个对象。
回调是加密的。企业微信这边有三个要素,Token 参与签名,EncodingAESKey 是 43 位字符串、Base64 解码后得到 32 字节密钥。
两个步骤,顺序不能反。先把 Token,时间戳,随机串,密文按字典序排好拼起来做 SHA1,跟回调带来的签名比对。不一致直接拒。
为什么不先解密。因为解密很贵,先解密等于给伪造请求免费算力。
漏掉这一步的后果很具体。你的回调地址是公网可达的,谁都能往里 POST。里面写一句帮你退掉订单,而 Agent 手里正好有退款工具。

5 秒对 15 秒:回调只入队,处理交给消费者
把被动回复换成主动推送
核心转换只有一句话。别在回调里回话。
回调只做四件事。验签,解密,入队,返回空串。全程目标 500 毫秒以内。消费者从队列里取消息,慢慢调 Agent,再用主动发送接口把回复推回去。AI对话的生成也挪到消费者里做。
被动回复的时限就是那 5 秒,绕不开。主动推送没有这个时限,几分钟后发也行。这一步把必须 5 秒内做完,变成了必须 5 秒内收下。
返回空串还有个副作用。被动回复时,你返回什么内容,平台就把什么发给客户。返回 success,客户就收到一条写着 success 的消息。
catch 里也别返回错误码。非 200 会触发重试,而重试救不了我们自己的解析 bug,只会让同样的错误重复三次。
幂等这块,键只能用平台给的消息 ID。去重放在消费端,不放在回调端。回调端要快,再写一次数据库会拖慢它。消费端可能多实例,去重必须跨实例生效,用数据库唯一键或者 Redis 原子操作。
回调端可以留一次只读的前置检查。查到了就直接返回空串,别写库。真正的去重还在消费端。
平台重试同一条消息时,这个 ID 不变。这就是它唯一可靠的地方。
保留多久。我用 24 小时,每天凌晨定时清。留 1 分钟会漏掉分钟级的重试,留太久表会无限长。
剩下三件杂事,队列,凭据,限流。日均消息五万以内,Redis 列表就够,省一个中间件。代价是没有消费确认和死信,重试要自己写。体量再大换消息队列。我的做法是先把队列访问封装成接口,换实现的时候业务代码不动。
队列积压了怎么应急。先看是处理变慢还是流量突然涨。变慢就先关掉知识检索,只回固定话术,保住消息不丢。流量涨就临时扩消费者,这也是消费者必须无状态的原因。
两家平台的发送接口都要凭据,有效期两小时。关键性质是新凭据会让旧的立刻失效。多实例同时刷新就会出事,后刷的把先刷的顶掉,先刷的拿着废凭据去发消息,全失败。正解是分布式锁加提前刷新,缓存有效期设成 80%,约 96 分钟,别等到过期才刷。
限流的分布还不对称。收消息几乎不限,主动推送有明确配额。于是出现一个反直觉的现象,你的 Agent 越勤快,越容易撞线。客户一次问 20 个订单,Agent 认真回 20 条,从第 12 条开始被拒。
三个办法一起上。多条回复先合并,这是从根上减请求量。本地按平台配额的 70% 做令牌桶,因为同一份配额可能还有别的服务在用。被限流就指数退避,1 秒,3 秒,9 秒。立即重试会让限流持续更久。
乱码也几乎全出在编码上。三处必须统一,接收解析,数据库存储,发送序列化。
数据库字段用 utf8mb4。MySQL 的 utf8 实际是三个字节,存不下四个字节的表情。测试时没人发表情,上线后客户天天发。
还有一类是实体转义。消息体里的小于号被转成实体,解析时要转回来。自己拼 XML 的时候也要转义回去。
降级这件事要保语义。业务层只产出一份结构化回复。标题,正文,分段,按钮,媒体引用。由各渠道的发送器按自己的能力渲染。
正文那个纯文本字段必须永远存在。它是唯一不用赌平台支持什么的形式,任何渠道都能发。
降级顺序是这样。有按钮且渠道支持就发卡片。没有按钮但支持 Markdown 就发 Markdown,表格转列表。都不行就发纯文本,表格改成逐行的字段加值。
超长按段落边界分片,每片前面加第几条共几条。按字数硬切会把一句话切成两半,客户看到金额为 299 和元,预计 3 天到账。
有一条不能丢。涉及金额必须加粗。降级降的是渲染形态,不是业务语义。
能点按钮就别让客户打字。钉钉的卡片按钮点完回传明确事件。企业微信要文本回复确认,你就得做归一化,一个嗯字算不算确认。
在退款这类不可逆操作上,我用白名单严格匹配,只认确认,是,确定这三个词,其余一律重新追问。宁可多问一次,不可误判一次。
渠道不支持可靠确认,就在这个渠道关掉写操作,只留查询和咨询。这不是妥协,是能力边界。
多实例要从第一天就假设。回调模式天然适配多实例,因为它是无状态入口,落到哪个实例都行。长连接模式不是这样,连接挂在某个实例上,平台只知道从这条连接下发。连接保活和断线重连,也得自己写。
目标架构是全实例无状态,会话状态放 Redis。这样任何实例都能处理任何消息,换实例,重启,扩容都不丢上下文。接口定义好之后,剩下的AI编程工作就是填实现。
埋点也要按渠道维度分开看。不然一个渠道的抖动会淹没在总量里,你只会看到成功率掉了零点几个点。
同一个人为什么变成两个客户
平台的用户标识是应用内唯一,不是全局唯一。外部客户在平台侧没有稳定的跨应用标识,映射表只能自己建。
主键别用手机号,也别用 OpenID。我的做法是渠道加 OpenID 做唯一索引,内部自增 ID 当主键,留一个手机号哈希字段给人工合并用。
别自动合并。手机号相同看起来合理,一旦合错,两个客户的对话记录和工单就混在一起。合并必须人工确认,还要留审计。
映射表要能反查。主动推送的时候你得知道这条回复走哪个渠道,发给哪个 OpenID。

同一个真人两个 ID,只能靠映射表并成一个人
跨渠道的上下文,默认不串。客户在企业微信说了半句,又去钉钉接着说,Agent 能不能串起来。我的答案是默认不串。
技术上不可靠。两家的会话 ID 体系不同,拼接要靠映射表,而映射表本身可能需要人工确认。安全上更不行,映射错了人,A 客户的订单信息就出现在 B 客户的对话里。
体验上也没必要。客户换个渠道,通常愿意再说一句。跨渠道拼上下文这件事,做对了没人夸,做错了就是事故。
所以策略是同一渠道内上下文连续,跨渠道不自动拼。客户说我刚才在别处问过,就提示他再说一遍,然后转人工。
多媒体别让模型自己猜。客户发截图问按钮在哪,这条消息里没有文字,只有一个素材 ID。做法是先调平台接口下载素材,转存到自己的存储。
然后按类型分发。图片走 OCR 或者多模态理解,语音走 ASR,文件解析出文本。等文字填进正文字段,才交给 Agent。不转文本直接塞给模型,又贵又慢,还答不准。

图片走 OCR,语音走 ASR,转成文本再交给 Agent
四个必守配置。回调里不放业务调用,耗时压在 500 毫秒以内。幂等键用平台消息 ID,留 24 小时。凭据提前到 80% 刷新,加分布式锁。数据库统一 utf8mb4。
三个必建表。消息幂等表,渠道用户映射表,发送记录表。
渠道对接不是接个 webhook。它是把 Agent 接进一个有硬时限,至少一次投递,格式受限,身份还不统一的分布式环境。
