

谷歌开源了一个新东西。
名字叫 Harness²。
它不改模型的参数。
动的只是模型外面那一层。
模型还是那个模型,参数一个字没改。
也就是提示词,工具链和技能库。
装上去以后,GLM-5 在办公基准上多考了 11.5 分。
直接压过原版的 Gemini 3.5 Flash。
项目已经开源,支持 OpenCode 和 Codex。
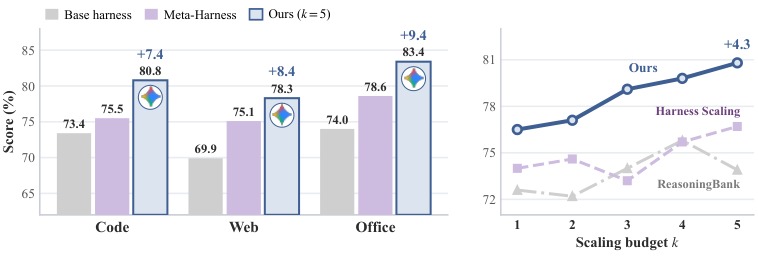
横轴是并行预算 k,柱子越高分数越高
一 · 自己改自己,卡在两处死穴
过去两年,AI工具 都在同一个方向上使劲。
写代码的 AI编程,做表格的办公流程,底下都是同一层脚手架。
提示词听着玄,其实就是 AI对话 里那句开场白。
业内的想法很顺。
让模型自己写代码,自己改提示词,自己调工作流。
这条路有个名字,叫递归自我改进。
真放进开放场景,几乎全趴下。
卡在两处。
第一处是没有标准答案。
实验室里刷题有单元测试。
对错有标准答案摆在那儿。
真实的活儿不一样,写一份商业企划,审一份合同,没人给你打分。
模型改了一版提示词,它怎么知道自己变聪明了,还是在瞎编。
分不清的时候,人多半就当它变好了。
第二处是过度拟合单次任务。
为了修某个任务,把脚手架改了一通。
下一个任务换成写爬虫。
之前改的规则全成了负担。
硬套下去,系统会陷进噪声螺旋,越改越傻。
Harness² 就是冲着这两处来的。
它搭了两层互相嵌套的递归。
一层管任务,一层管改进。
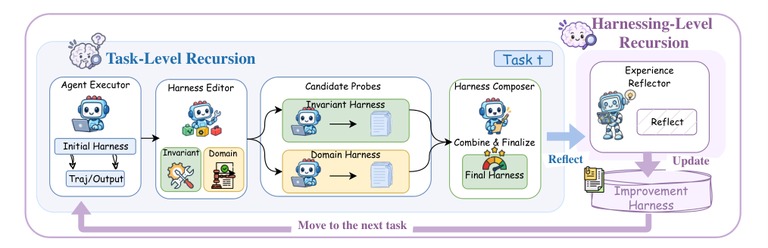
两层递归套在一起,任务级在里,改进级在外
第一层是任务级递归。
手里没有标准答案,那就先做对照实验。
系统先拿初始脚手架跑一版参考轨迹。
重点看模型执行的时候,暴露了什么毛病。
接着走三步。
第一步是提议。
由一个编辑角色针对轨迹,提两套修改方案。
一套修通用缺陷,比如规划乱,工具调用死循环,上下文炸掉。
另一套修领域问题,专盯当前业务的特定知识。
两套候选互相不打架,各修各的。
第二步是探测。
两套改完的候选脚手架,放回同一个任务各跑一遍。
没有裁判也能比。
系统把执行轨迹和参考轨迹摆在一起,做行为对比。
看有没有修好卡住的步骤,有没有带出新的退化。
改完不倒退才算数。
第三步是合成。
合成器只认证据,把真正有效的改动并进最终脚手架。
没被证据撑住的改动,直接扔掉。
它还能并行铺开 k 个候选一起探测。
探索面更宽,挑出来的东西更稳。
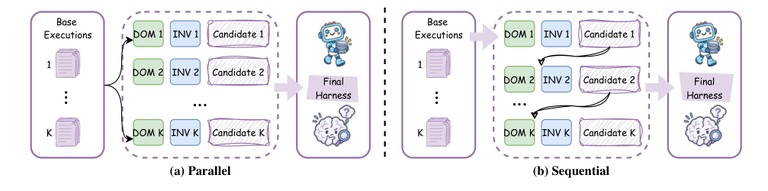
并行铺开 k 个候选,或者一个接一个试
第二层是改进级递归。
任务做完,交付物交出去,很多系统就停了。
它在这里多走一步。
把整份调试记录交出去。
参考轨迹,候选改动,对比证据,合成决策,一样不少。
反思模块读完,写一份经验文档。
这次为什么这么改,什么条件下起效,带来什么后果,全记下来。
存进持续改进经验库。
这里存的东西,跟模型记忆不是一回事。
记忆记的是任务内容。
经验库记的是改脚手架的判断。
哪种毛病该用哪种补丁,哪条改动在什么场景下会翻车。
等下一个任务进来,执行端拿到的还是干净的初始脚手架。
但负责改脚手架的那个模块,手里已经有厚厚一本经验。
提议和合成的时候,它先去库里翻相似场景。
捡别人踩过的坑,也捡验证过的组件。
改的不只是眼前这层脚手架。
改的是以后改脚手架的能力。
单次的临时修补,变成能攒下来的资产。
这一层,才是它真正贵的地方。
二 · 换个基准,分数照样往上走
机制讲得再顺,也得看实测。
团队拿了三个基准。
办公的 WorkBuddy-Bench,端到端岗位的 JobBench,还有法律智能体基准 LAB。
模型和脚手架,就是开头提到的那几样。
先看单步改进,k 等于 1。
GLM-5 在开源的脚手架上从 64.2 涨到 75.7。
换另一套,从 64.4 涨到 75.3。
3.5 Flash 也从 72.4 到 77.5,另一套从 74.5 到 77.5。
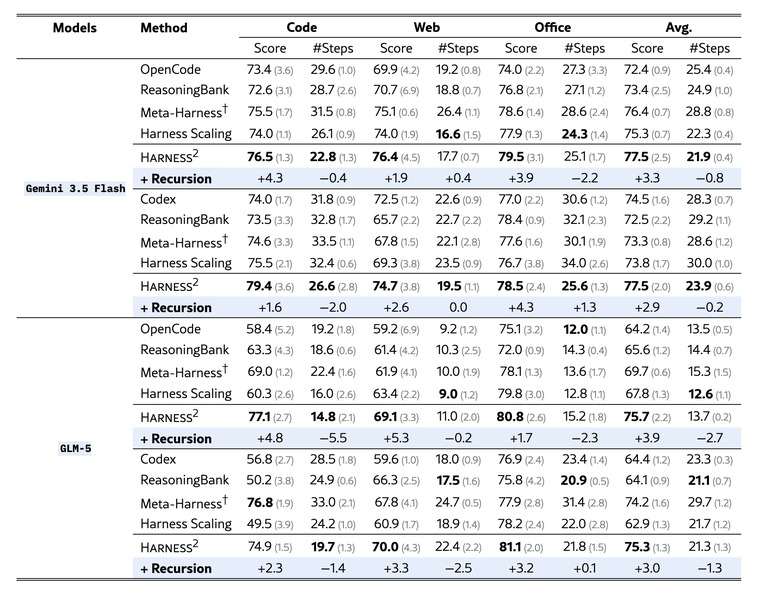
每格是分数,括号里是多次运行的波动
GLM-5 拿的是 75.7 和 75.3。
没改过的 3.5 Flash,是 72.4 和 74.5。
改过的国产模型,压过了没改过的谷歌模型。
换到岗位基准,单步改进还是全线涨。
两款模型分别加 4.5 分和 3.6 分。
法律基准上,通过率抬了 11.8 个百分点。
并行预算拉到 5 路,还能再涨。
办公基准再加 3.9 分。
岗位任务再加 4.2 分。
法律基准再加 6.7 个百分点。

换两个基准,柱子还是往上走
更值得看的是,经验库能不能搬家。
团队把岗位基准上攒的经验库拔下来,插到办公基准上用。
不做任何额外探测。
代码涨 0.6,网页涨 0.5,办公涨 2.9。
白白捡的分。
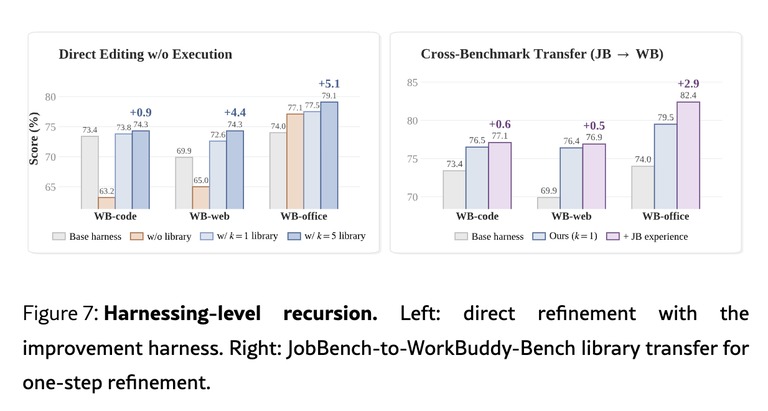
经验库从岗位基准搬到办公基准,不做探测也涨分
这两年,行业几乎把期待全押在底座模型上。
总觉得下一代模型出来,手头的问题就自己解决了。
现实不太给面子。
基座越来越贵,边际收益在放缓。
落地时的长尾问题,还是无穷无尽。
买更贵的模型,解决不了长尾。
上下文窗口给到再大,跨文件对账它照样偷懒。
跑分再高,写完报告它还是不会自己打开文件校格式。
这些毛病,靠预训练参数喂不饱。
参数是死的,场景每天都在变。
它要的是一套运行时的自我感知和自我修补。
以前的脚手架,靠工程师一条条手写。
它给的是另一条路,把改规则的权力交回智能体自己。
顺带说一句作者。
论文一共九位,华人占七成八。
篇幅有限,只说前三位。
一作兼通讯是西北大学的博士生 Ruiyao Xu。
导师带他做语言模型,图机器学习,异常检测和智能体系统。
这篇是他在谷歌实习期间做的。
第二位是 Yanfei Chen,谷歌云研究院的资深研究工程师。

Yanfei Chen,谷歌云研究院资深研究工程师
本科读北大,电气工程加经济学。
2018 年拿到匹兹堡大学工业工程博士。
之后在一家做机器学习的小公司做过研究工程师。
2020 年进谷歌,参与过搜索和企业版深度研究两个项目。
现在做语言模型智能体,检索增强和工具学习。
第三位是中国姑娘 Zoey,也是研究工程师。
Zoey 的个人主页,研究方向写在第一段
2019 年斯坦福电气工程博士,研究通用智能体和可验证智能体。
Codex安装汉化 中转站 微信:douhanq
