

问一句答一句的日子过去了。现在的智能体,得自己跑好几轮。
论文首页,标题写着逐步同伴优势
多答案问答,考的是覆盖。
不是找到一个就算完。
它要把整个答案集合挖出来。这类需求在现实里很常见。做行业盘点或者查竞品名单,都得给出一串名字。
少一个就不合格。
AI工具 为此改了工作方式。
它边搜边答。
发出查询,读回证据,判断何时收手。可做 AI对话 的团队,大多盯着单答案题。
举个真题。
列出 2021 年成功入轨的发射场。答案是一串实体,分布还很不均匀。肯尼迪、范登堡这类头部,一搜就来。
普雷塞克这种长尾,藏在偏僻角落。得一轮轮改查询,才挖得到。头部和长尾,报酬却一样。
这就是后面所有麻烦的起点。普通智能体的做法很朴素。
搜一次,拿到几个名字。
换个说法再搜一次,还是那几个。
它便收工了。
看上去它答对了,其实只答了一小块。人工去查同一道题,会翻好几个来源。一个发射场官网,一份年度报告。
线索不同,答案才会慢慢补齐。机器要学的,就是这套往下挖的习惯。挖得越深,越难判断哪一步有用。
训一个模型做这件事,成本也在这里。奖励给得粗,它就只学头部。奖励给得细,它才愿意往远处走。
这篇论文盯的正是这一层。

同一道题下,普通智能体与它的搜索轨迹对比
上面那张是普通智能体。
第一步搜汇总,拿到三个头部实体。第二步换个说法,回来的还是那三个。
第三步它直接作答。
下面那张是训练过的智能体。第一步一样,但它抓到一条线索。商业发射这四个字,前面没被覆盖。
第二步改查这条,挖出两个新的。接着沿低纬度和海上发射继续改写。
到第六步才作答。
要学这种本事,靠提示词教不出来。近期流行把工具问答当成策略学习。用强化学习去优化搜索策略。
可这套方法在多答案题上卡了两处。
第一处,功劳怎么分。
一条轨迹能跑几十步。
中间有有效搜索,也有冗余和无用搜索。哪一步真正扩大了覆盖,很难指认。
现有几条路线都有短板。
带价值网络的那类,要在长程上估回报。误差一层层累积,训练又贵又不稳。去掉价值网络的那类,稳了一些。
但优势还算在整条轨迹上。轨迹赢了,说不清哪一步搜得好。给中间步骤打分的那类,要外部评估器。
本质上仍在用轨迹级信号优化。靠状态匹配的那类,前提太硬。搜索观测天生噪声大,精确匹配很难成立。
第二处,奖励和目标不对齐。常用的 F1 奖励,对每个实体一视同仁。长尾更难搜,却没有任何额外激励。
过程里也没信号告诉它,该继续还是收手。结果是找到几个显眼答案就提前终止。
一处错在训练信号太粗。
一处错在奖励不看覆盖。
所以问题不在模型不够大。在训练时给的信号,粒度不对。信号太粗,模型分不清哪步有效。
奖励太糙,模型只盯容易的答案。两件事叠在一起,长尾就没人管。这也是为什么,把模型换大也没用。
它照样会在搜到几个显眼名字时收手。换个更大的模型,只是把头部答得更快。覆盖这件事,得从训练信号上改。
作者的思路很直接。
既然优势停在轨迹上,就把它拆到步上。既然奖励不分稀罕,就给它分出来。两个改动各自解决一处错位。
合起来,是这套框架的全部新意。这套框架叫 SPADER,名字很长。
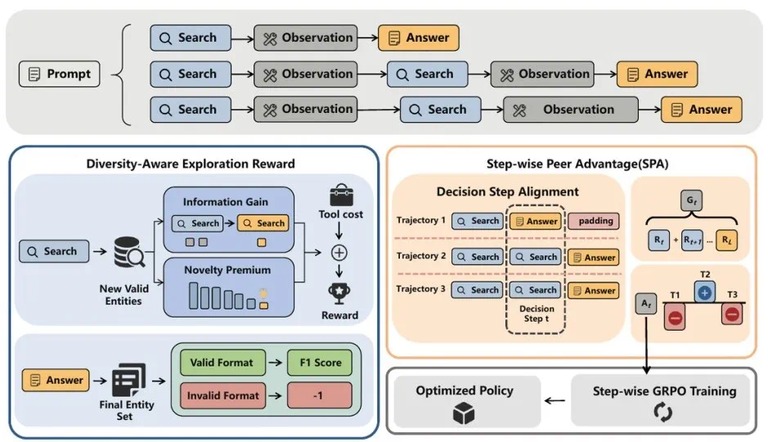
框架总览,采样轨迹后逐步打分再优化策略
第一个组件,按决策步对齐。同一道题先并行采样一组轨迹。组内互相比较,得到相对优势。
原来的比较停在整条轨迹上。
它把比较细化到每一步。
提前结束的轨迹补齐长度,未来回报记零。再用掩码挡住终止之后的梯度。每一步的基线,取同一步全组的均值。
跑赢这个均值的步骤,得正优势。
跑输的得负优势。
训练时把轨迹级优势整个换掉。按步做重要性采样和裁剪。
全程不需要价值网络。
也不需要外部评估器。
这一步很关键。
价值网络要另训一个模型,误差会累积。
同行比较不要额外模型。
同题同步采样,基线天然可比。它只借用同一轮里其他轨迹的结果。不需要假设轨迹之间语义等价。
观测再乱,也能比出高低。
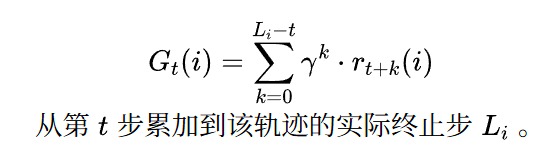
未来回报的蒙特卡洛估计式
未来回报按折扣累加。
从第几步往后算,一直加到轨迹结束。组内超越均值的步骤,权重放大。
低于均值的,权重压小。
这套算法不猜哪一步重要。它让同一组的轨迹互相投票。
组越大,票数越稳。
第二个组件,把奖励拆成两头。每搜到一个新实体,先拿一份基础分。
再乘一个新颖度溢价。
某个实体被越多轨迹搜到,溢价越薄。头部实体人人能搜到,溢价接近零。只被一条轨迹挖到的长尾,拿满额。
这个设计直接对准覆盖。
每次搜索还要扣一笔工具成本。继续搜,就不再是免费动作。预期收益抵不过累计成本,它自然停。
终端作答另有结算。
格式不合法扣分。
合法就按最终 F1 给分。于是什么时候继续,什么时候收工。
不用人为规定轮数。
它从奖励结构里自己长出来。
优势不是拍脑袋给的。
它由同一组的实际结果算出来。所以训练里没有额外的模型要训。也没有人工标注的过程分数。
成本只落在采样上。
组件之间的分工很清楚。
一个管信用,一个管探索。信用错了,学不到对的步骤。
探索弱了,走不出头部。
两件事缺一件,效果都会掉。
实验部分先看主表。
两种基座模型,四套多答案基准。
对手分三类来比。
提示类的,还有结果监督类和步骤监督类。后两类都是当前常见做法。指标看精确率,召回和 F1。
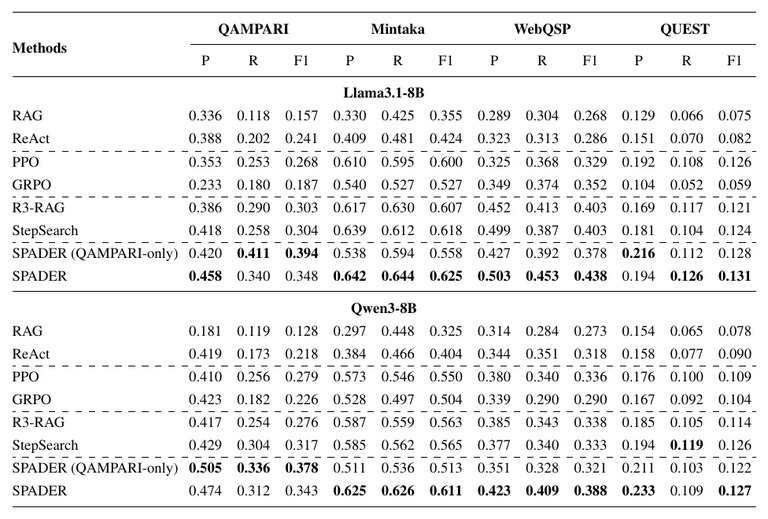
四个基准上的精确率与 F1 对比,两种基座
它在两套基座上,四个数据集全是第一。有一个基准上,提升超过八成。对步骤级基线也一直领先。
不是某个数据集上的偶然。四个数字都往一个方向走。
最值得看的是召回。
精确率没有掉,召回上去了。多挖到的名字,都是答案里的有效实体。
不是拿噪声换覆盖。
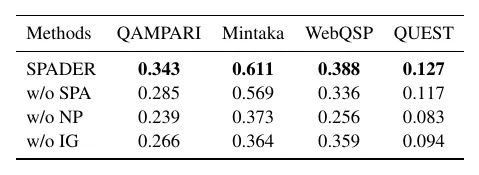
同一基座上逐项移除组件的消融结果
两个组件是不是缺一不可。作者逐个拿掉,再重新训练。少掉逐步优势,性能稳步下滑。
再看新颖度溢价,掉得更多。说明它是防止早塌的关键。最后是基础分,策略会被带偏。
它开始追稀罕但没用的实体。横向和纵向两条轴,得同时在场。这个结果比总分更有说服力。
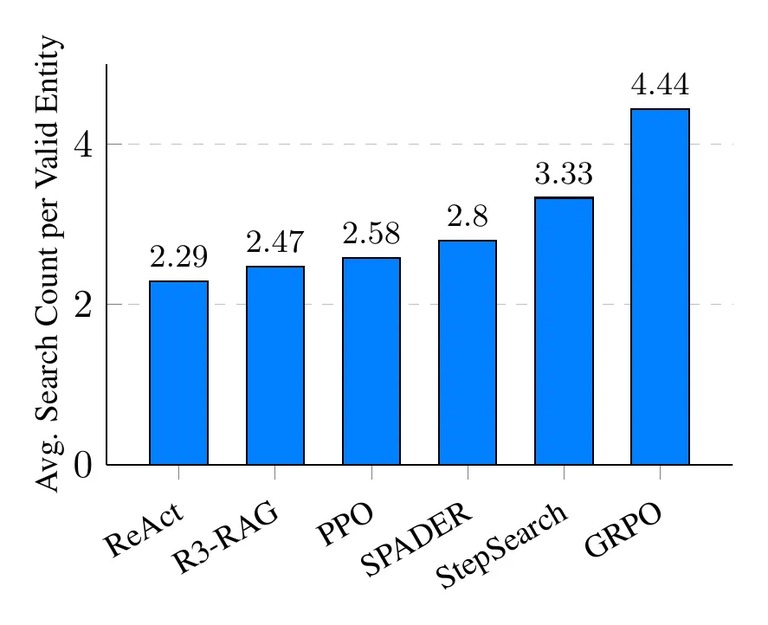
检索到一个有效实体,平均要搜几次
覆盖更全,会不会只是搜得更多。作者统计了平均搜索次数。它排在中游,召回却最高。
比它更省的做法,召回更低。那种省,来自抓到头部就收工。搜得最多的那类,召回反而最差。
陷在冗余搜索里出不来。
它没有靠堆次数换覆盖。
同样的搜索预算,挖到更多有效实体。
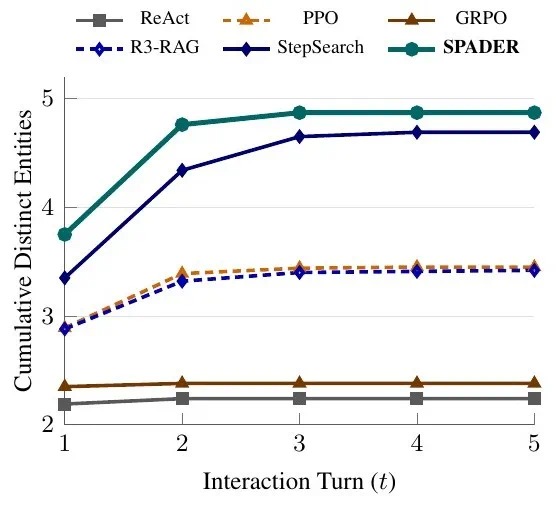
每一轮的累积不同实体数,它一直在涨
还有一张图看时间动态。
两种老做法,第一轮之后就平了。一种改进版能撑到后面几轮。它整条轨迹保持最高产出。
直到有效目标被挖干净,才进平台。有新的就继续,挖完才收工。
回到开头那道题。
找全比找到难。
难在每一步的功劳要算清。也难在奖励得替长尾说话。
这套方案把优势拆到步。
奖励也分出了稀罕度。
两处错位,各补一处。
四条线指向同一件事。
提升来自更细的训练信号。
不是来自更多的搜索。
对做 AI工具 的人来说,这件事有现实意味。多轮检索的成本,大头常在无效轮次上。
能自己判断何时收手,比多搜几轮更值钱。这也是 AI对话 产品接检索后绕不开的一课。
AI编程 里的检索链路,道理相通。
