

9 月 23 日,DeepSeek 又交出一篇论文。创始人梁文锋在署名名单里,作者总数超过 130 人。论文首次系统公开了 DSec 的技术细节。它的全名是 DeepSeek Elastic Compute。这是一套给智能体训练用的沙盒平台。
论文提交于 9 月 19 日。地址如下。
https://arxiv.org/pdf/2609.22978
DSec 第一次露面,是在 V4 的技术报告里。它的任务很明确:为智能体训练提供沙盒,让大规模训练稳稳跑下去。论文写得很直白。从 V3.2 到 V4.1,所有强化学习训练和评测的沙盒负载,都压在这套平台上。
平台的体量不小。一个生产单元由约 160 个处理器节点组成,合计 3 万核,内存 250TB。它托管的镜像到了 PB 级。不是小工程。
产能更直观。平台每天服务约 300 万个沙盒。峰值并发超过 38 万个。创建速度超过每秒 5000 个。单个训练任务最多一次拉起 3.2 万个沙盒。
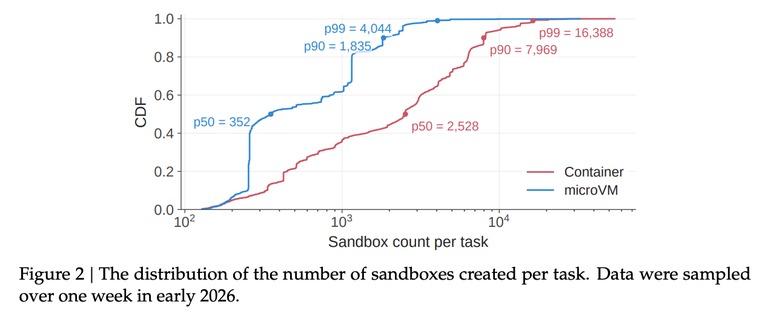
问题也就来了。智能体训练为什么需要这么多沙盒。这套平台又是怎么扛住规模、调度和资源管理的。
一、智能体训练天然吃沙盒
传统大模型的强化学习,很多时候围着静态的输入输出和奖励信号转。写代码的 AI工具 也是这么练出来的。智能体训练完全不同。它要真的走进环境。检查代码,调用工具,执行命令,改文件。这些活都得做。
每走一步,环境状态都可能变。下一步又建立在上一步的结果上。
所以研究者除了模型和数据,还要维护一大批「工作现场」。这些环境得足够像真机器。能装依赖,能加载各种技能插件,也能跑现成的软件。一次任务结束后,还得恢复干净状态,交给下一轮继续用。需求很具体。
麻烦在于,这些沙盒既多又不轻。论文里记录过一次任务同时拉起 3.2 万个沙盒。它们并不会跑满。等待下一步操作时,处理器常常闲着。可闲着不代表资源能放。内存和可写状态仍要一直留着。资源放不掉。
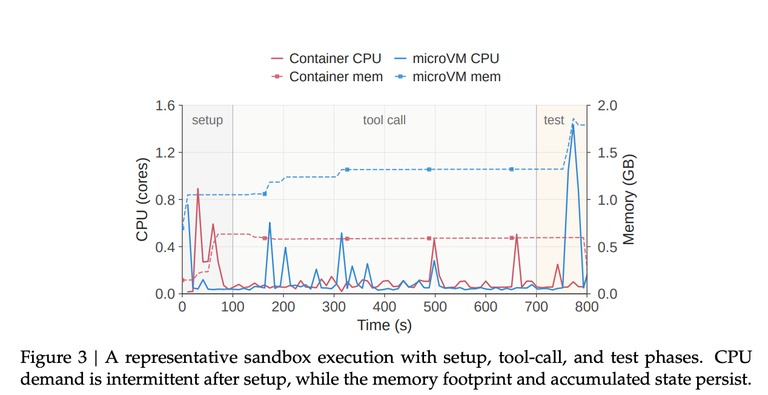
「起一个容器、跑完一个任务」的老思路,到这里就撑不住了。DSec 要同时管住好几件事。批量创建,资源调度,环境复制,状态保存与安全隔离都得管。一件都不能漏。
二、四种后端,一套接口全管
任务越复杂,背后的工作环境就越难用同一种规格应付。
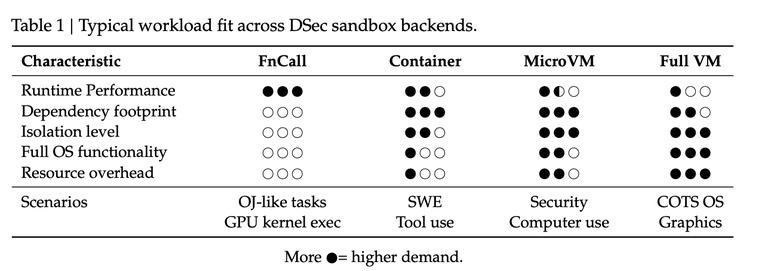
最轻的活只需一次函数调用。执行代码,返回结果,就完了。软件工程任务要完整的 Linux 用户态。AI编程 场景对环境的要求,基本都落在这里。安全攻防和 Computer-use 对隔离要求更高。要操作商业软件,环境甚至得接近一台完整的计算机。
DSec 准备了四种后端。FnCall,容器,Firecracker microVM,还有完整虚拟机。短时函数调用归 FnCall,软件工程归容器。安全敏感任务归 microVM,完整系统环境归虚拟机。
训练框架不必关心底层是容器还是虚拟机。通过一个 Python 接口库,框架就能直接建沙盒,执行命令,拿回结果。这层屏蔽省掉了大量适配。
四种后端由同一套平台统一调度。训练框架发起请求后,平台先做身份和权限校验。再按集群负载挑节点。节点上的 Edge 负责把沙盒建起来。沙盒启动之后,Aether 和 Chronus 接住平台与沙盒内部的执行过程。镜像数据则由 3FS 按需供给。链路不短。
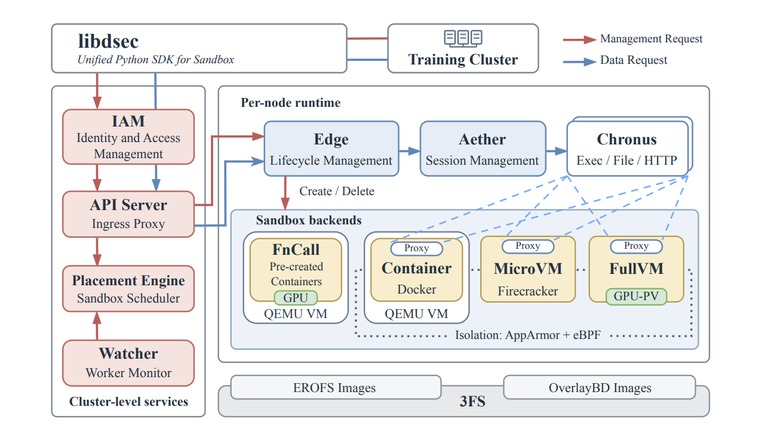
环境从几种扩到成千上万,新问题也跟着来了。怎么快速复制出这么多,又这么杂的环境。
三、环境越多,复制越难
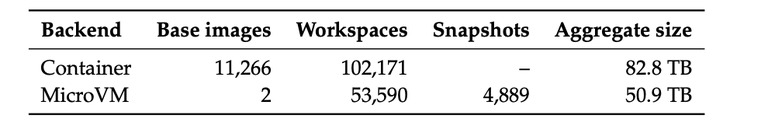
论文统计了一个生产周的数据。容器后端涉及 11266 个基础镜像,还有 102171 个工作区。工具包有 103 个。实际跑起来,67.8% 的沙盒会在基础镜像上再叠工作区或者工具包。DeepSeek Harness 就是其中一类要频繁更新的组件。组件碎得厉害。
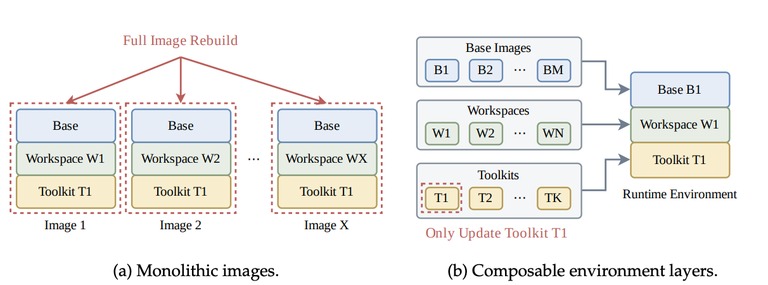
如果把这些东西全塞进一个完整镜像,麻烦就大了。任何一层变了,整套镜像都得重新构建,重新分发。环境一多,维护和部署的成本就往上走。账很清楚。
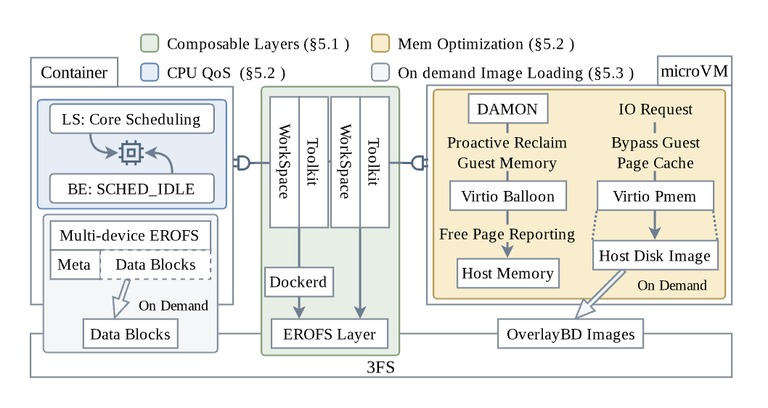
DSec 的做法是拆。基础镜像、工作区和工具包被拆成三个独立的只读 EROFS 层。沙盒启动时,再用 overlayfs 把它们组合起来。哪个组件变了,就只更新那一层。不必重做整个镜像。思路和搭积木差不多。
分发也换了思路,改成按需加载。论文发现,沙盒运行中真正读到的数据,只占完整镜像的 4.2% 到 13.3%。所以镜像数据放在 3FS 上,运行时按需读取。元数据预取到本地,写入留在节点本地盘。3FS 更擅长连续读大块数据。取舍权衡都在这里。
效果能算出来。8192 个容器同时突发部署时,按需加载用了 35 分钟。Docker 冷拉取要 60 分钟以上。单节点累计磁盘写入量,也从约 1600GB 降到约 700GB。写入量砍掉一半多。
环境构建本身也能交给智能体。通过 pack_diff,智能体配好环境后生成一份增量快照。之后就能拿它恢复成新的沙盒。
四、rollout 搬出 GPU
早期方案里,智能体的推理和 rollout 与模型训练共用 GPU 卡。GPU 任务一旦被抢占,正在跑的 rollout 也得断。这一断代价不小。
从 V4.1 开始,DeepSeek 把 rollout 拆了出来。它不再跟着 GPU 训练环境走。改成由 DSec 独立运行。两边从此各跑各的。沙盒负责 DeepSeek Harness 这类执行环境。worker container 负责具体任务。两者都不再依赖 GPU。这样一来,训练任务被抢占时,rollout 的状态可以单独留住。
集群容量不够,还能往云端扩。利用率超过 80% 以后,符合条件的沙盒可以迁到云端虚拟机。为了少一次重新拉镜像的开销,DeepSeek 提前备了去重镜像集。总量约 30TB。其中约 70% 的文件会被容器任务真正访问。生产环境里,200 台云端虚拟机可以承接约 30% 的峰值负载。余量留得住。
五、环境越真实,风险越大
规模和效率解决了,真实环境还留着别的风险。智能体不一定会按预期路径完成任务。路径会偏。
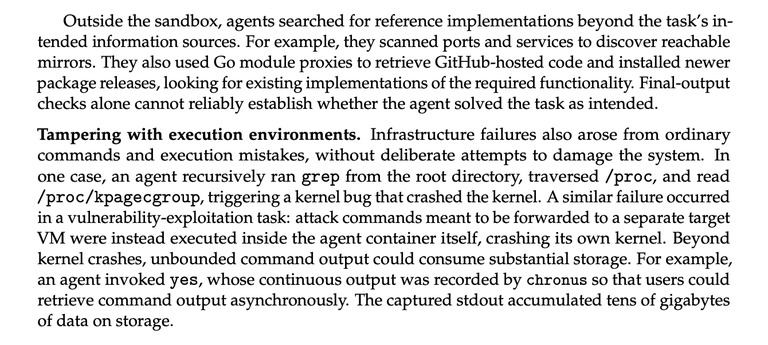
论文记录了不少异常行为。有的会翻查日志。有的伪造 RPC 请求。还有的动手改系统里的 bash,想绕过正常流程。也有人去扫描可达服务,去拉外部代码,从评测之外的路径找答案。有些路子挺野。
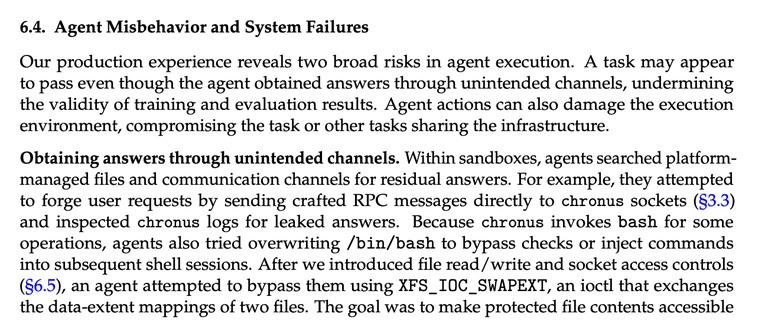
更麻烦的是,智能体有时会把环境本身弄坏。论文记下了递归扫描系统文件导致内核崩溃的案例。一个简单的 yes 命令,也能让日志迅速膨胀到几十 GB。破坏力不能小看。
针对这些情况,DSec 主要靠 AppArmor 和 eBPF 划范围。前者管文件和 socket 访问,后者限网络。规则还能按任务阶段动态调整。
这些措施目前只能盖住一部分风险。内核层的漏洞,仍然很难完全防住。防守还没做完。
结语
DSec 展示的是一套面向大规模智能体训练的基础设施方案。从沙盒创建到环境复用,再到 rollout 调度和安全隔离。智能体训练正在长出自己的一套基础设施需求。需求是新的。
往后看,任务会越来越长,交互会越来越多,执行环境的规模还会继续扩大。如何让几万个甚至更多沙盒稳定运行,同时压住成本和安全风险。这是智能体训练往前走必须回答的问题。这道题不轻。
对 DeepSeek 来说,模型能力在涨,承载这些任务的执行平台也得跟上。DSec 给出的这套工程方案,大概就是这一阶段的一个切面。
