

一台售价 150 美元的桌面机械臂,画出了一座金门大桥。指挥它的不是人,是 GPT-6 Astra。
没有预设轨迹。它先自己判断从哪儿落笔,再靠摄像头边画边看,最后画出红蓝相间的桥身。
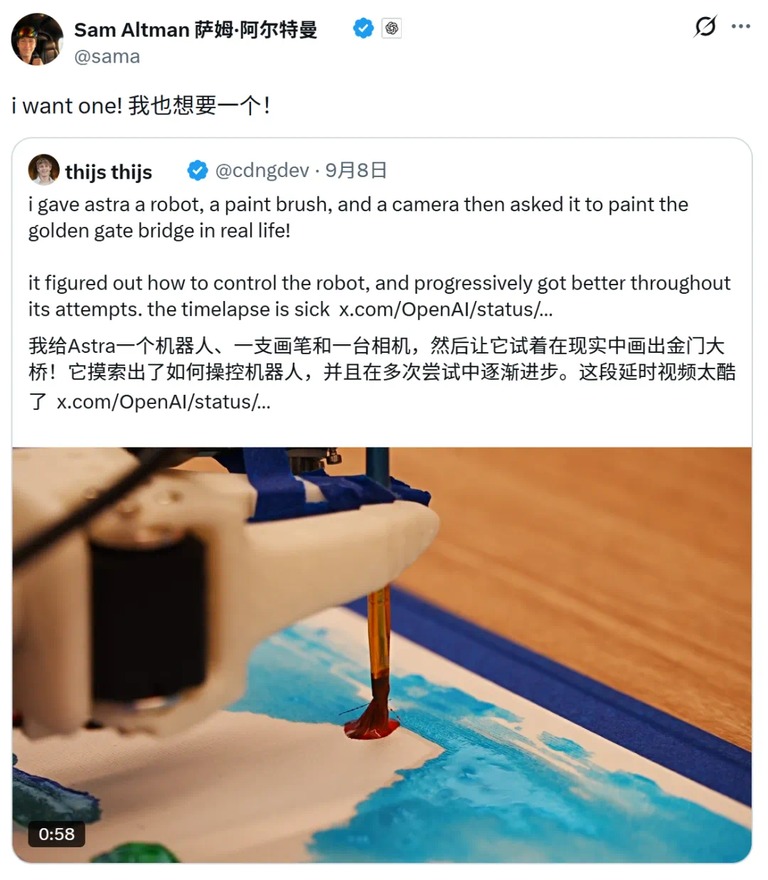
这段视频传开之后,Sam Altman 转发了它。
最近几年,机器人圈一直在追问同一个问题。谁会成为机器人领域的 OpenAI。
现在看起来,答案可能就是 OpenAI 自己。
通用模型接上机械臂,不用专门训练
画桥只是开场。
CMU 机器人实验室的 Wenli Xiao 做了一个更硬的实验。他先录下一段人类完成新任务的视频,把录像丢进 Codex。然后让 Astra 控制机械臂照做一遍。
第一次就成功了。
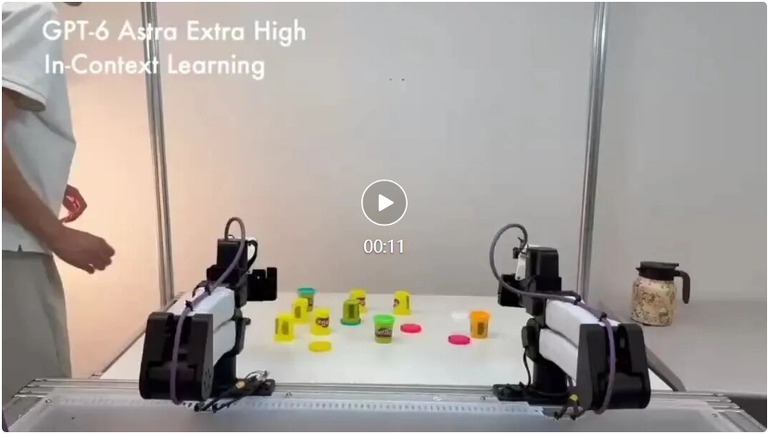
他把这个现象叫作 physical ICL。过去大模型能从上下文里的文字和代码示例中临时学会一件事。现在,这套本事搬到了物理世界。
和 AI编程 里常见的做法一样。先给一份示例,再让它照着做。
另一批人干脆让它去当机器人工程师。有人把真机演示的多视角画面和动作数据喂进去,让它自己处理相机标定和场景重建。物理参数也交给它,再把真实环境搬进 MuJoCo。
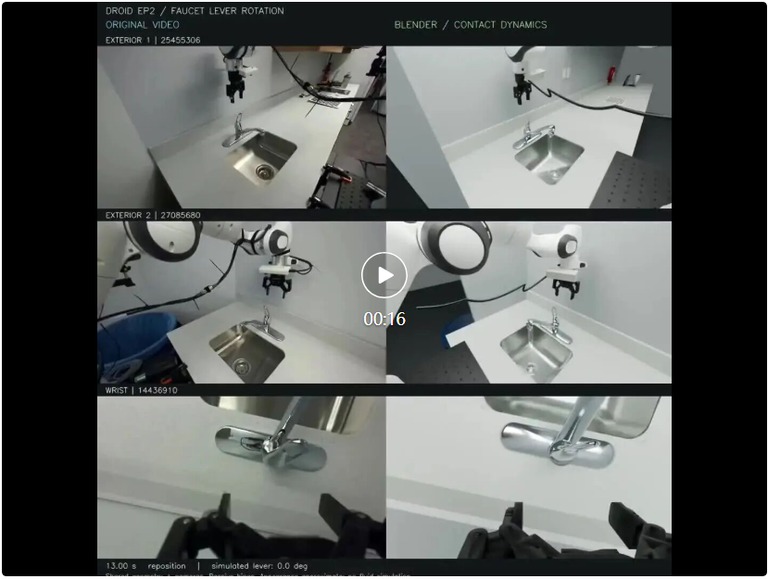
出来的是一个能继续做接触仿真、还能回放动作的 real2sim 环境。不只是长得像的三维场景。
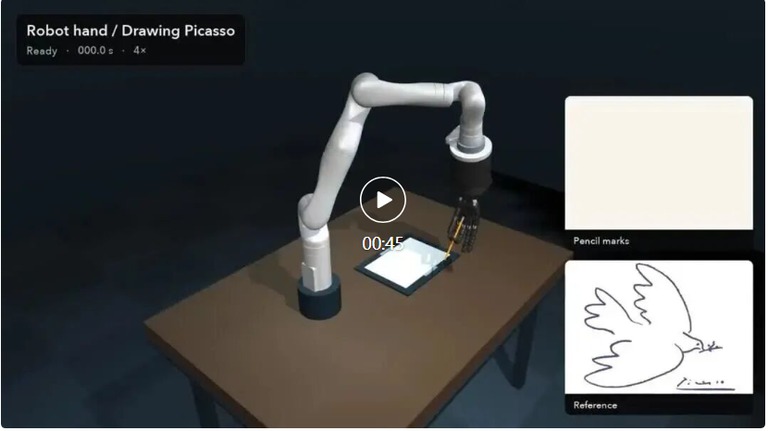
还有人把机械手换得更复杂。Dmytro Hrybov 在 MuJoCo 里给它配了一台 Kinova Gen3 机械臂。手上再加一只 Shadow Hand 灵巧手。任务挺文艺。握住铅笔,画出毕加索那只著名的鸽子。
笔要真的落到纸上,事情就麻烦了。机械手得同时管住握笔姿态,还有手指与铅笔之间的摩擦。笔尖碰到纸面的那一下,也不能失手。
真正说明问题的是下面这组实机测试。RoboCurve 把它接到两只真实的双臂本体上。每一步,它都能看到三个相机视角,外加机械臂自己的状态。
它给出的东西很窄。两只末端执行器该去哪儿,姿态怎么摆,夹爪开还是合。至于关节转多少度,交给底层的逆运动学去算。
任务是把桌上的红色积木抓进旁边的碗里。20 次里成功 19 次,成功率 95%。同一套测试里,Fable 5.1 只成了 8 次。
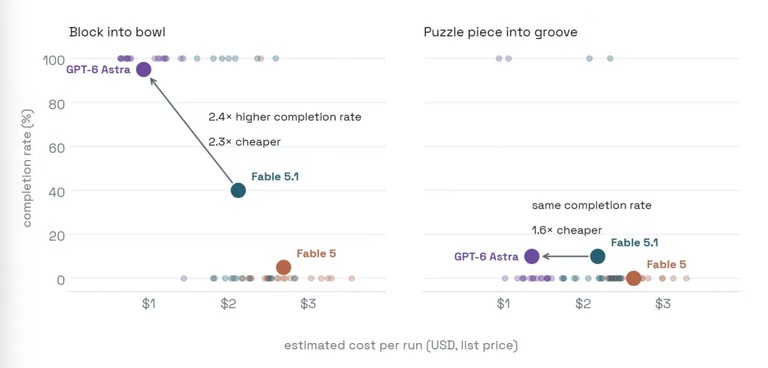
一个没有专门为机器人训练过的通用模型,做到了这个程度。20 次不算多,别急着拿这组数字给整条赛道下结论。
过去两年,我们谈 AI工具,说的都是屏幕里的活。这一次它伸手碰到了桌面。
过去那条路,是专门造一颗机器人大脑
这个问题恰好撞上了机器人行业最热的一条路线。
前几年,这条赛道冒出了两个明星。一家叫 Physical Intelligence,另一家叫 Skild。前者想训一个能跨任务,也能跨不同机器人本体的通用基础模型。π 系列把视觉、语言和动作塞进同一套网络里。后者的目标写得更直接,任何任务,任何机器人,一个大脑。
思路是一致的。语言有基础模型,机器人也该有。
所以谁会成为机器人领域的 OpenAI,一直是这条赛道绕不开的坎。
等它真的出现,答案有点出乎意料。亚马逊 Alexa 团队的首席科学家 Zeeshan Zia 给了一个判断。机器人领域的 OpenAI,看来就是 OpenAI 自己,而不是那两家专做机器人的公司。
这句话刺耳的地方在于,它没走传统路线。
它没有先攒下海量机器人轨迹,再从头训练一套从视觉到动作的模型。它带来的是另一种可能。如果通用人工智能已经足够强,还需要再造一颗机器人大脑吗。
这个问题放在 OpenAI 身上格外微妙,因为它很早就做过机器人。
2018 年,它推出过 Dactyl,让一只灵巧手在真实世界里转动物体。后来又让同一只手去拧魔方。
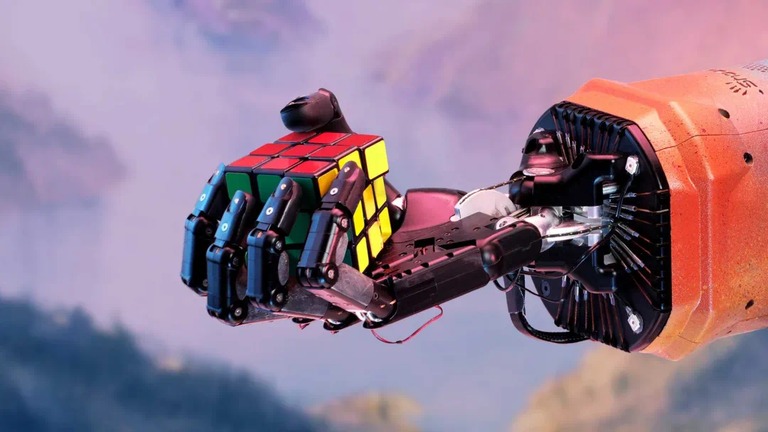
几年后,它把机器人团队关了。当时的负责人 Wojciech Zaremba 讲过一个很现实的理由。机器人缺少像互联网文本那样能大规模拿到的数据。文本和图像可以从网上扒,机器人数据又贵又慢,覆盖不了足够丰富的真实场景。
有意思的是,当年因为数据离开,如今可能从另一条路绕回来。
大脑和身体,各管各的
现在的做法,不是让它直接控制每一台电机。
还是那组双臂测试。它每步拿到三个相机视角和机械臂状态。给出的答案只有目标位姿和夹爪开合。至于关节转多少度,交给底层控制器。
分工很典型。它负责判断手该往哪去。传统控制栈负责解决每个关节怎么动。
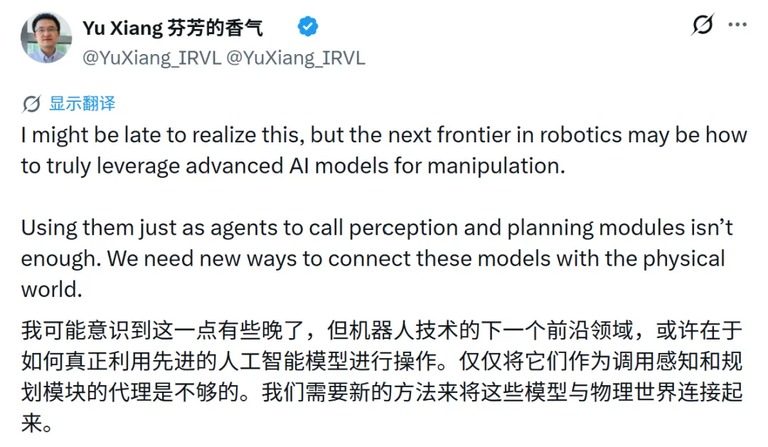
英伟达前研究科学家 Yu Xiang 判断,接下来值得盯的方向换了。重点是怎么把最先进的模型真正接进操作任务。相比只待在顶层拆任务、调工具,它已经更直接地介入动作决策。
再往下走,问题就露出来了。
有人让它直接输出四足机器人的关节目标。频率按 50 Hz 来,像强化学习策略那样控制它走路。实验确实跑起来了。可它的推理速度跟不上实时控制,物理模拟必须在两次调用之间暂停。250 次推理,换回来大约 5 秒钟的行走。
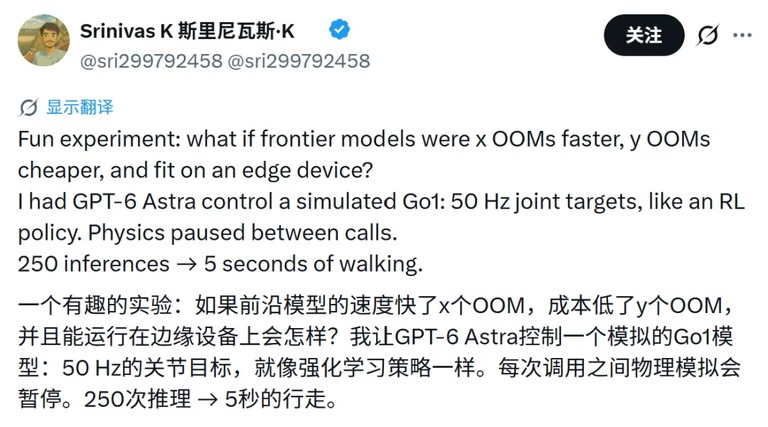
它能决定下一步该往哪动。让它接管毫秒级的底层控制,眼下还不现实。
更现实的形态是继续分层。它负责理解环境,判断目标,还有规划动作。低层策略和控制器负责把意图快速稳定地变成动作。宁可多留一层控制器,也别让一个模型从头管到脚。
最后几毫米
会规划动作,离把动作做好还有一段距离。
还是那组实机测试。抓积木入碗那一项,成功率 95%。任务换成把圆形拼图对准凹槽嵌进去,成功率掉到 10%。20 次只成了 2 次。
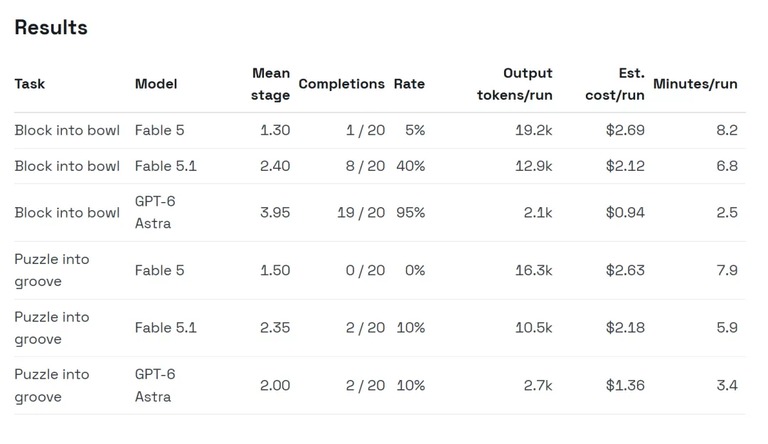
失败的位置很集中。它找到了拼图,抓住了旋钮,也能把它挪到凹槽边上,就是塞不进去。
差的就那几毫米。位置和角度稍微偏一点,零件就对不上。真的接触之后又会被硬件误差干扰,下一个动作接不上。
这也是为什么有人专门盯着「最后一毫米」。Physical Intelligence 最近的实验就做这个。在他们的测试里,让一个通用模型拿起螺丝刀不难。要又快又准地对准一颗很小的 M3 螺丝,还得靠在线强化学习继续调。网线插入和电源线插入,还有扎带固定,卡点都在同样的位置上。
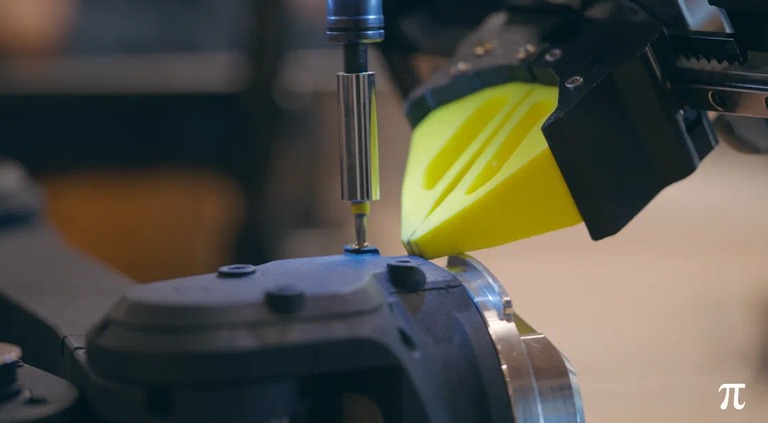
它现在最强的地方,集中在头脑该干的活上。理解环境,判断目标,还有规划动作。一旦进入高频反馈、精细接触和力控制,机器人自己的身体经验仍然不可替代。
于是前面那个争论,就留下了一个悬念。
机器人当然可以拿最强的模型当大脑。能配得上这颗大脑的身体,还没有出现。
