

AI 完成任务之后,还能留下什么。
多数系统的答案是「什么都没留下」。下一次遇到相似需求,它还得从头试一遍。
研究团队来自北京航空航天大学和香港中文大学,联合新加坡国立大学,给出了另一条路径。他们发布的 OmniHarness 让视觉智能体主动练习,主动检查结果,再把有效的流程留下来。
面对下一个需求,AI 手里就多了一份经过验证的方法。
创意任务解决率 95%
研究团队把 OmniHarness 放进 ComfyBench 评测。创意任务这一类里,它拿到 95%,比表中最好的对照 SymbOmni 高出 27.5 个百分点。
配置换成 Codex 加 GPT-4o 时,总体解决率是 92.5%。
表里有两个指标要分开看。Pass 看流程能不能跑起来,Resolve 看输出能不能满足任务要求。
OmniHarness 两种配置的 Pass 都是 100%。ComfyMind 和 SymbOmni 也做到了 100%。
所以真正拉开差距的不是「能不能跑」,而是「跑完的结果有多少合格」。
推理骨干统一用 GPT-4o 时,这套系统的总体成绩是 89.5%,ComfyMind 是 83%。放到创意任务上,两者分别是 95% 和 57.5%。
这说明经验怎么被调用,工具怎么被组织,会成为模型能力之外的变量。
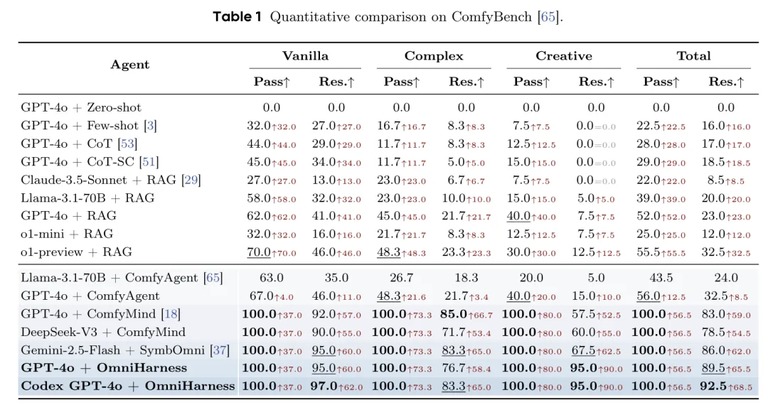
换成 Codex 做规划之后,总体从 89.5% 升到 92.5%。复杂任务从 76.7% 升到 83.3%。
优势也有边界。复杂任务的 83.3% 仍然没超过 ComfyMind 的 85%。它并不是在每个子集上都领先。
这些成绩落在什么样的画面上
输入可以简单到一张花朵涂鸦。
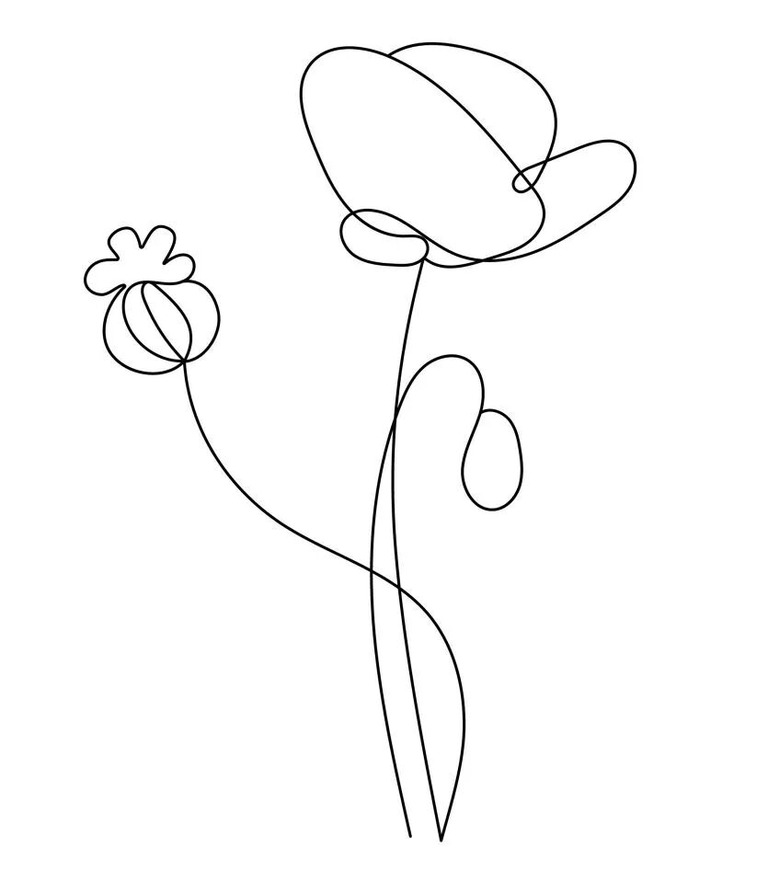
涂鸦被重绘成写实红花,这个风格又被拿去生成一整片花田。
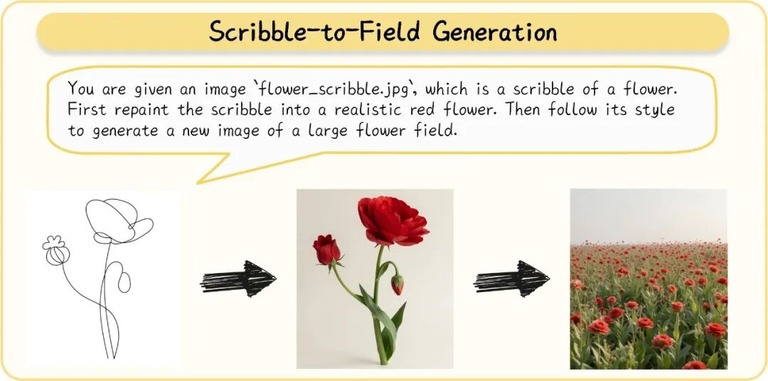
两次生成通过中间图像连了起来。
换成四格漫画,任务就变成讲完一个周日早晨。醒来。看手机。发现是周日。继续躺平。动作和文字都要服务剧情。
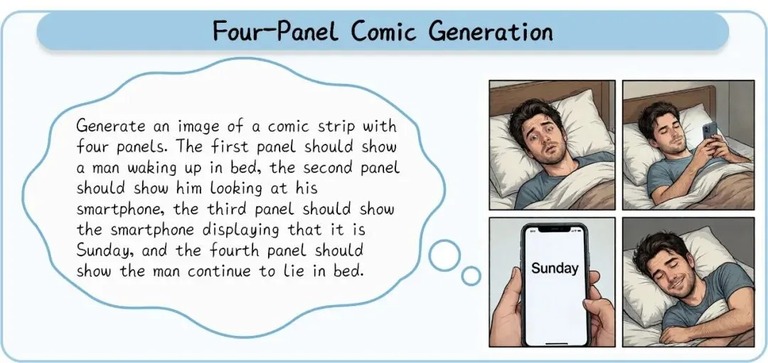
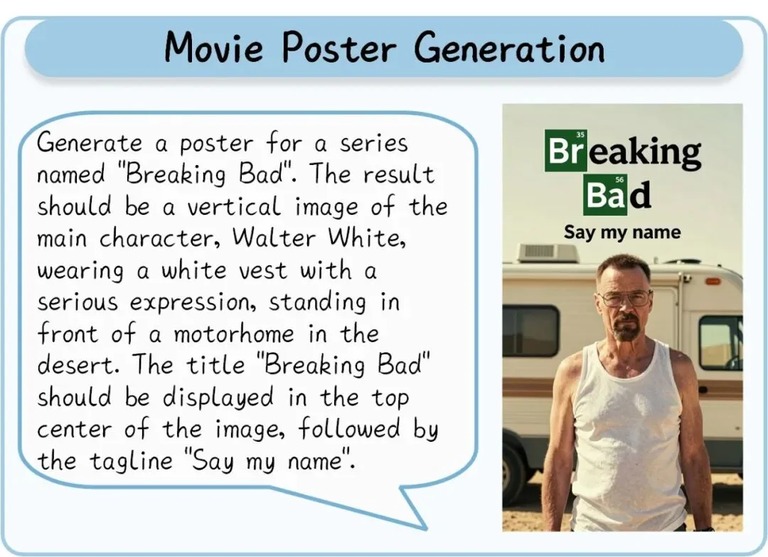
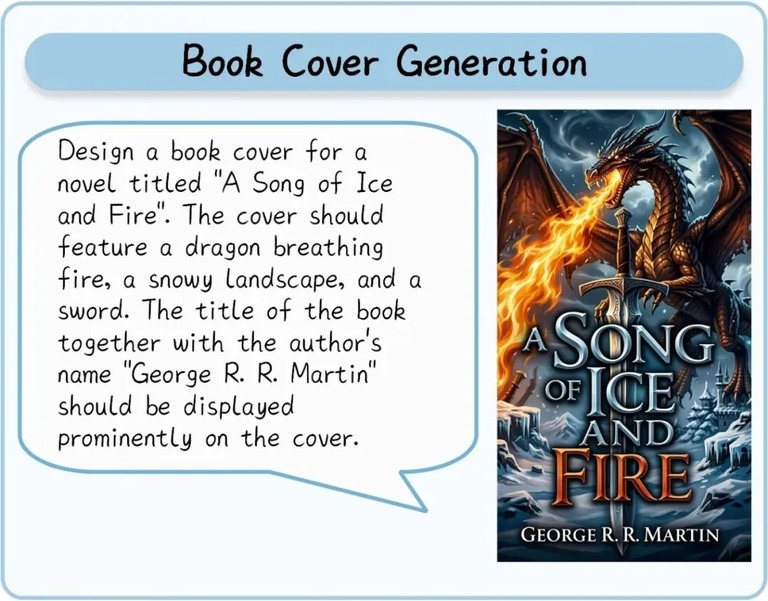
换成海报和书封,主题和标题还有版式,又构成一组要同时满足的要求。
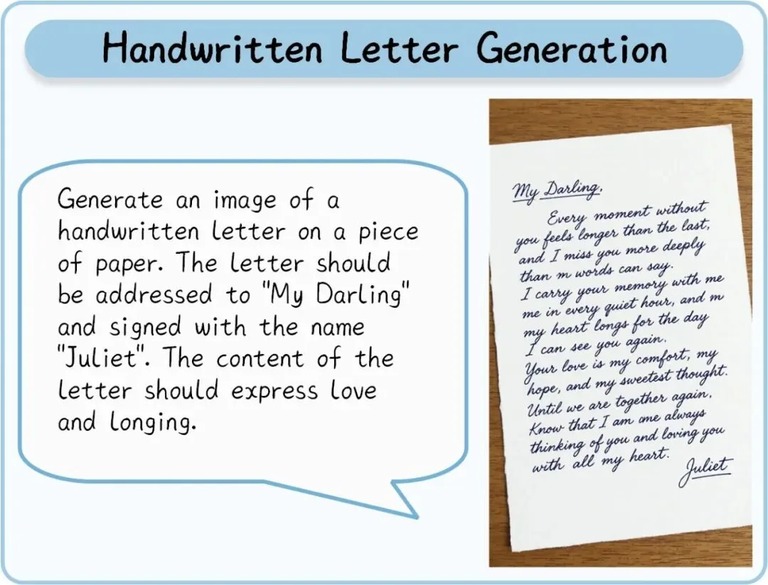
手写信这一类更典型。称呼要对得上。信件内容要对得上。纸张质感也要对得上。
餐桌编辑则更细。叉子要移除,或者替换成勺子。旁边的食物和杯子,还有桌面布局,都得尽量保留。
改好目标,也要顾及周围。
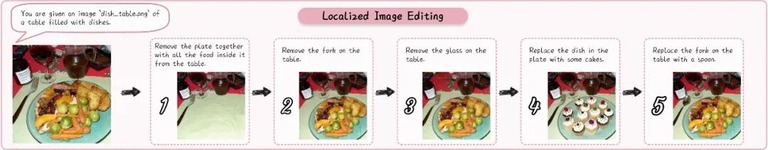
这类任务覆盖 AI图片生成,也覆盖局部编辑和海报设计。
做成一次之后,怎么留住经验
创作需求总在变。红花可能换成别的主体,重绘之后可能还要调布局。一次成功怎么帮到下一次。
OmniHarness 用的是符号策略学习。它把验证成功的流程,整理成可以复用于一类任务的策略。
借花田任务理解这件事。花朵和颜色可以替换。而先重绘草图、再借参考生成新画面这种连接方式,可以沉淀成可调整的方法。
保存下来的策略包含三样东西。工作流模板。适用条件。资源依赖。当前图片和具体描述这类实例输入,则被抽离出去。
后续调用时先检查策略是否适用,再绑定新输入。需要的话就调整步骤,或者把多条策略组合起来。宁可少存几条策略,也别把不适用的流程硬塞进来。
出题和检查,再积累
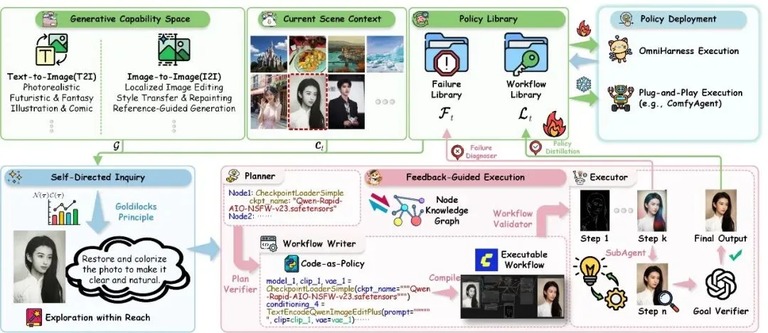
第一步是把练习选在值得探索的地方。自主练习发生在下游任务明确之前。
只做熟悉的题,补不上空缺。挑战拉得太远,又缺少方法支撑。与其把题目堆满,不如把练习压在能力边界附近。系统结合练习记录和现有能力,让探索有迹可循。
每轮默认生成 10 道候选题。选题分数由新颖性和能力边界评分相乘决定。
同类情境练得越多,新颖性得分越低。系统会记录每种「情境—能力」的练习次数。图生图按源图区分情境,文生图共享一个标记。
得分按所需能力取平均,避免能力项列得多就自然占优。
每项能力由适用且未停用流程中的最高可靠性提供支持。可靠性用 95% 置信区间的下界估计。整道题的能力估计取其中最低值。
这相当于先看短板。大部分步骤熟练,只有一处缺少可靠方法,整体完成照样会被拖累。
第二步是让检查跟上每一次执行。系统安排步骤和依赖,把代码编译成 ComfyUI 工作流。
检查分三件事。流程能不能运行。每一步效果如何。最终目标有没有达成。
以花田任务为例。假如红花已经偏离要求,下一步继续沿用,偏差也会进入新画面。
失败之后,系统定位问题并做局部修复,尽量保留已经验证过的部分。需要时请子智能体协助,在重试预算内再检查一次。
第三步是让成败都成为下一次的依据。验证成功的流程被抽象入库。失败的记录下证据、原因和修正方法。等价流程会合并。可靠性随着调用更新。
策略还要接受后续检验。新的成败记录会继续影响它的可靠性和调用优先级。
经验换个使用者,还管用吗
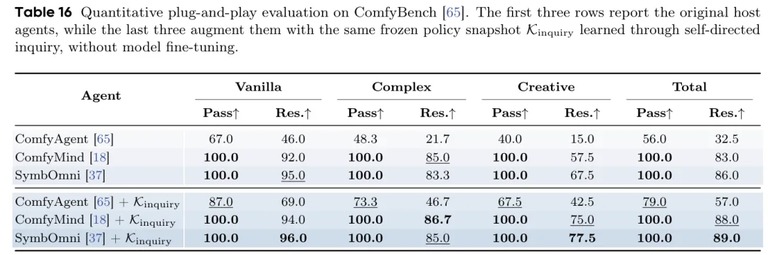
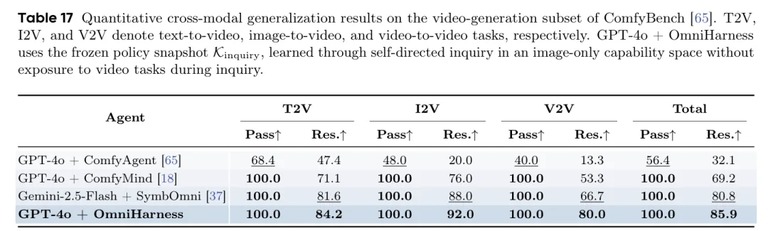
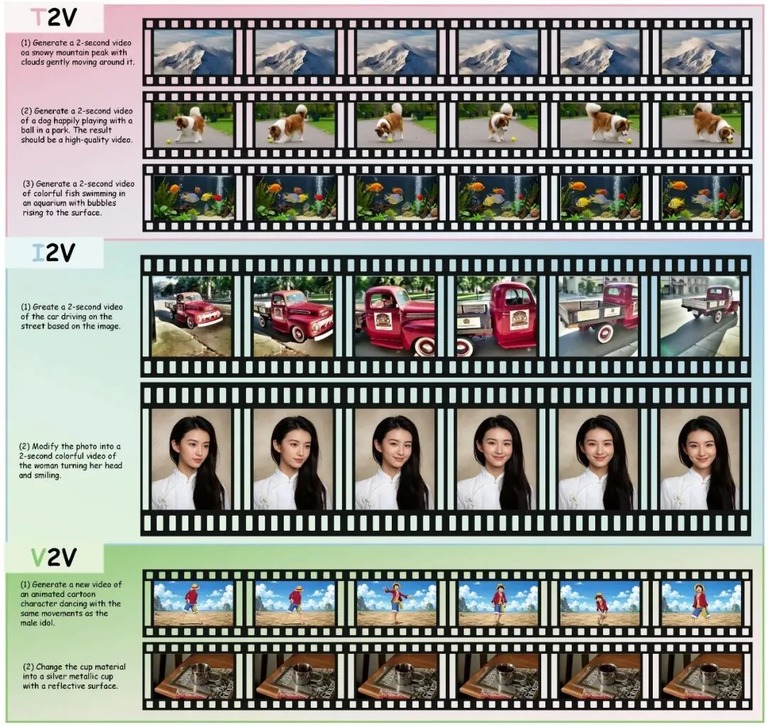
团队把自主练习后的策略库冻结,再适配到其他智能体的知识接口。宿主保留原有控制流程,模型也不做微调。
交付的内容既有成功流程模板,也有失败证据和修正办法。其他智能体按自己的方式检索和规划,再去执行。
同一份经验,让三个系统的总体解决率都提高了。
ComfyAgent 从 32.5% 升到 57.0%。ComfyMind 从 83.0% 升到 88.0%。SymbOmni 从 86.0% 升到 89.0%。
创意任务上的增幅,三家分别是 27.5 个百分点和 17.5 个百分点,SymbOmni 是 10 个百分点。
创意任务的提升都超过了各自的总体增幅。面对新要求,已有的流程和纠错经验仍然能帮到不同的系统。
还有一层迁移更值得看。只练过图像任务的冻结策略库,被用到了 AI视频生成的工作流上。
视频总体解决率是 85.9%,比表中最好的对照高出 5.1 个百分点。视频到视频达到 80.0%,高出 13.3 个百分点。
分工上,图像策略负责内容构建和参考保持这类操作。时序处理仍然交给视频专用组件。两者要经过适配和组合。
这条路径同样要付出计算成本。自主练习要开销,多轮验证要开销,修复也要开销。检索效率和推理预算还有优化空间。
OmniHarness 展示的是一种积累方式。模型参数不变,可调用的方法随着实践更新。
对做 AI工具的人来说,这条路径值得留意。今天留下的经验,有机会成为明天处理新需求的起点。
