

同样一句”我今天用了多少”,在 ChatGPT 里的 Codex 任务上和在 API 接口上,答案不是一回事。产品侧按计划额度和 credits 结算,API 侧按 token 算钱,走第三方中转的又是另一张账单。三套口径混在一起估,算出来的数字往往偏得离谱。
token 这一侧最容易算错的地方有两处。一处是 token 和字数的换算关系,另一处是上下文会一轮一轮往上叠。搞懂这两件事,再看账单就知道钱花在哪了。
Token 不等于字数
Token 是模型读写文本时的基本小块,既不等于字数,也不等于字符数。英文里一个 token 可能是一个短词,也可能只是词的一部分。中文里一个汉字或者一个标点都会影响 token 数,空格也算。
代码和 JSON 通常很占 token。Markdown 表格和长路径也一样,日志和依赖锁文件同样占地方。图片与音频会按自己的方式计入用量,工具调用和推理模型的内部思考也算在里面。
不同模型切分语义的策略不同。同一句”我是一只猫”,在不同模型里算出的 token 数可能不一样。中文模型对中文的分词通常更友好一些。
上下文是逐轮累加的
每次和 Codex 交互时,之前的聊天记录都会一起发到服务端。这就是上下文。
上一轮已经积累了 5000 token,本轮对话又产生 1000 token。下一次请求发送的就是 6000 token 的上下文。如果每轮都新增 1000 token,五轮下来累计消耗是 15000 token。
聊得越多,用量涨得越夸张。有一种技术专门对付这件事,叫 prompt caching。
Prompt caching 让长前缀变便宜
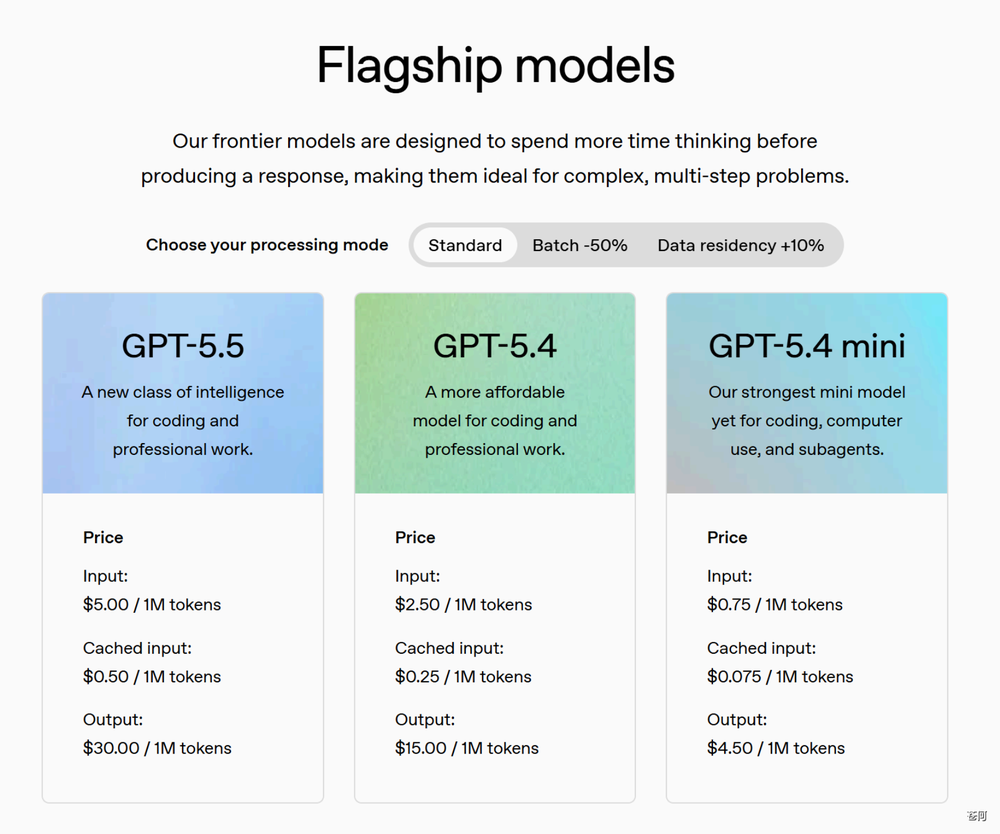
服务端会记住你最近用过的一段长前缀。后续请求的开头部分和之前足够相似时,这部分输入按缓存输入计价,价格低,响应也可能更快。
| 类型 | 含义 | 费用 |
|---|---|---|
| 输入 token | 发给模型的内容,包括你的提问,还有系统提示与历史消息 | 中 |
| 输出 token | 模型最终生成的内容 | 高 |
| 缓存输入 token | 命中 prompt caching 的那部分输入 | 低 |
缓存能不能命中,关键看前缀稳不稳定。固定的系统提示和项目规则,一直不变的背景材料,稳定的工具定义和输出 schema,这些容易命中。每次都放在最前面的临时问题,每轮都变的时间戳和随机 ID,顺序不断变化的文件列表,这些基本命中不了。
大部分情况下 Codex 会自动使用缓存,命中率按经验在八成到九成之间。缓存价格通常只有普通输入 token 的十分之一左右。只有上下文特别长的时候,缓存那部分费用才值得单独盯。
什么会进入上下文
Codex 每次发出去的不是单纯的聊天记录,而是一组整理过的上下文。来源有好几处,各自有加载时机和保留方式。
| 来源 | 什么时候进来 | 加载和保留的细节 |
|---|---|---|
| 当前消息与历史对话 | 每轮都带 | 上下文太长时,较早的内容会 compact 成摘要 |
| AGENTS.md | 会话开始时从全局到当前目录逐层发现 | 每次请求都加入,一般不会每句话重读文件 |
| Skills 列表 | 会话开始时 | 只带技能的名字与描述,还有路径,不读完整内容 |
| 被调用的 Skill | 任务匹配或用 $ 显式调用时 | 触发后才读完整说明,读进去就留在当前线程 |
| MCP 工具 | MCP 服务启用并初始化后 | 每轮都带工具名和参数 schema,返回数据调用后才进 |
| 文件内容 | 读文件或搜代码之后 | 仓库不会整包进来,只有被引用和读取的部分会进 |
| 终端与工具输出 | 命令执行之后 | 受 tool_output_token_limit 限制,长日志会被截断 |
| IDE 上下文 | 用 IDE 插件发起任务时 | 会自动带上打开的文件和选区,CLI 默认不带 |
| Subagents | 要求并行或 Codex 自己起子代理时 | 子代理有自己的线程,主线程只拿汇总结果 |
把账单压下来的几个动作
- 少用 MCP。MCP 加载的上下文量很大,现在更推荐用 CLI 加 Skills 的方式替代。
- 简化 AGENTS.md。只留必要信息,把”认真分析””充分思考”这类改不了模型行为的模糊话换成明确的工作流程、完成指标和边界。
- 精简 Skills。囤着不用的技能加载量虽小,仍会误导模型,只留真正会用到的。
- 必要时候才用 SubAgent。它会推高 token 消耗,可以先问 AI 当前任务是否复杂到需要它。
- 让频繁进入上下文的东西保持稳定。少改动它们,缓存命中率才上得去。
收尾
费用焦虑大多来自口径不清。把 token 和字数分开看,把上下文的累加方式记住,再顺手把 AGENTS.md 和 Skills 收拾干净,账单通常就稳下来了。
