

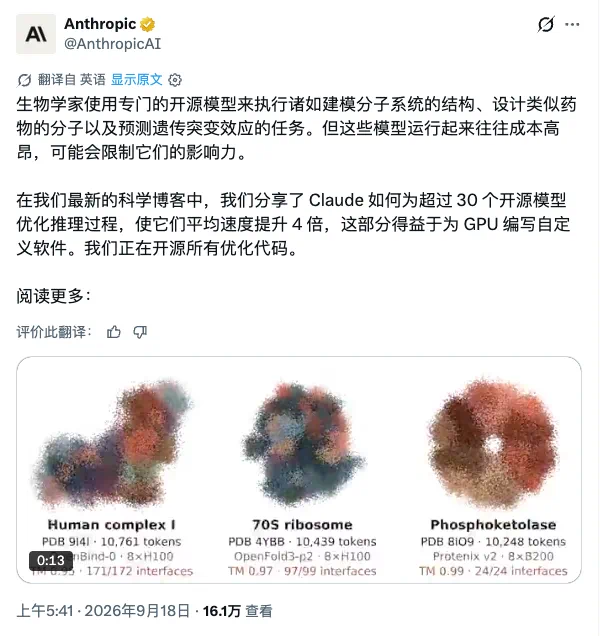
四周时间,超过 30 个开源生物分子模型被重新优化了一遍。
名单里有结构预测模型,也有分子设计工具。都是科研人员天天要用的东西。
做这件事的是一个通用 AI工具,不是性能工程师。它背后只有两名 Anthropic 技术人员,负责监督。
这两个人懂生物建模。但他们没做过推理优化,也没写过显卡内核。
结果写在 Anthropic 的报告里。在允许少量数值精度变化的前提下,这批模型平均快了约 4 倍。要求输出完全一致时,平均提速接近 2 倍。相关代码已经开源。
价值很直接。计算工具快一点,同样的时间和预算就能多跑几轮数字实验。
让模型去加速现成的科学软件,是加速科研最省事的一条路。
不过这份报告只回答了第一件事:AI 能不能做到。它留下另一个问题没答。
AI 写出的科学代码,距离吃满硬件性能还有多远。
几乎同一时间,另一群人想接住这个问题。
9 月 17 日,AItonomy Foundation 放出第一个开源项目。名字叫 ScienceIDE。
赞助方是 PhAI Labs 和阿里千问。
这个项目想把散落各处的科学代码库,整理成能执行、能验证的学习环境。技术报告和代码仓库都已公开。模型权重和项目页也放了出来。
一段跑得通、却慢了三倍的代码
团队拿来试手的是 PLUTO。
这是等离子体物理和天体物理领域里一套广泛使用的高性能计算代码。代表论文发表于 2007 年,用到现在快二十年。它覆盖流体和磁流体两大方向,每种方向又有相对论版本。
复杂度不在行数上。以磁流体模块为例,激波捕捉格式要把空间重构、界面求解和时间推进串成一条完整流程。
每一步都有自己的数据依赖和访存特点。磁场无散这个约束还得单独处理,这属于科学内容,不是工程细节。
PLUTO 团队自己也在做显卡化。他们 2025 年发表的新版本用 C++ 重写,靠 OpenACC 走英伟达显卡。
AItonomy 的团队换了个做法。直接在 M1 Ultra 和 A100 上重实现磁流体模块。
在 A100 的一次测试里,模型生成的第一版就能跑通,物理结果也对得上。可对比他们手边的 128 核处理器节点,提速还不到 5 倍。
这只是第一版。离硬件的极限还很远。
随后他们花了一两天,和模型一起找瓶颈。调整数据布局,改内存访问和内核组织,砍掉不必要的数据搬运。
求解的物理问题一个字没动。速度又涨到第一版的接近 3 倍。
模型把代码写出来之后,还留着数倍的性能空间。
这段空间为什么难挖。数据布局怎么匹配线程访问。相邻线程能不能形成合并访存。哪些中间结果值得缓存,哪些宁可重算以省内存流量。
这些问题都得靠实测数据说话。答案不在提示词里。
换提示词没用。这也是 AI编程 里最常见的一个误会,总以为模型写得不好是因为话说得不够清楚。
跑得通,不等于算得对
提速的另一面是正确性。改写之后的程序,还能不能回答原来的研究问题。
Anthropic 的报告里就有个现成例子。他们让模型在单台 8 卡 B300 节点上,预测完整的病毒衣壳和蛋白区室。一次要处理三万一千到七万个 token。
推理全部跑通了。这本身就是过去要靠多节点集群才干成的事。
报告写得很直接:这些结构没有被正确预测。模型在训练上下文之外近两个数量级的地方,缺乏泛化能力。
程序能跑,不代表科学上正确。判断一个科学结果对不对,要拿它去和参考答案比,而不是看程序有没有报错退出。
放到代码加速这件事上,验收标准很具体。质量和能量的守恒误差是否可控。磁场散度是否满足所选数值方法的要求。激波位置和波传播速度是否与参考结果一致。
不把这些定下来,一个程序完全可以通过少算几步、降低分辨率或者跳过重要过程来变快。
快是快了,用途也没了。
ScienceIDE 把这条判据叫做科学等效性。它用这条判据判断任务算不算完成。
把科学代码库变成可以学习的环境
一次成功的优化只是一个交付物。它能被使用,不能被学习。
ScienceIDE 想解决的是后面这件事。
科学代码库里其实存着大量人类知识。这些知识散在源代码、编译配置和测试算例里,更多的散在研究者的脑子里。
要让机器学得动,先得把它们组织成能执行、有反馈的环境。

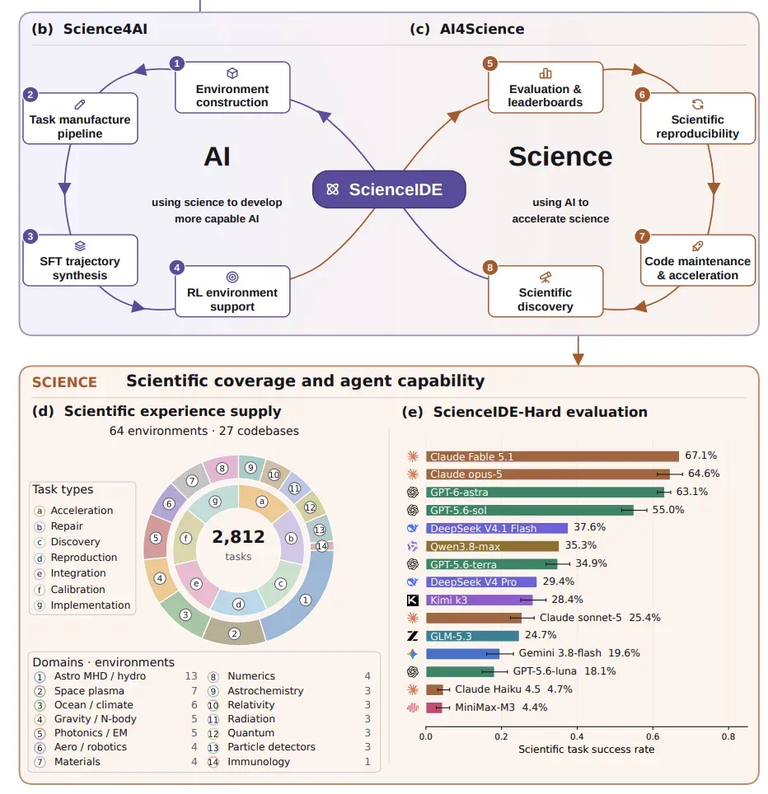
具体做法是,由领域专家定义科学算例和验收标准。然后再和模型一起,把代码库整理成可执行环境。模型在里面完成任务,自己跑程序,看科学结果。经过验证的交互经验,被拿去评测和微调。
目前论文报告的范围包括 27 个科学代码库。整理出 64 个环境,2812 个任务。另有 1076 项可执行的科学检查。
方向覆盖天体磁流体与空间等离子体。海洋气候和引力问题也在里面。光子学、材料和量子各有分工。
任务分成七类,覆盖加速与修复,一直到完整实现。
需要说明的是,目前任务主要集中在代码修复和功能实现,加速类还只有初步实例。团队说会继续拓展真实的性能优化问题。
想建的闭环很具体。给定科学问题、输入规模和硬件预算。模型理解并修改实现,用科学检查判断合格不合格。再在统一条件下,量运行时间和资源消耗。
最强的模型,也只做到 67%
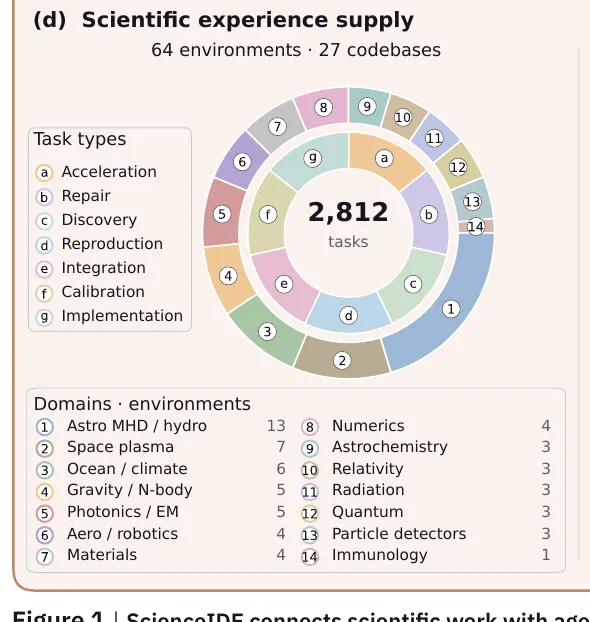
团队挑出 85 个难任务,组成公开评测集 ScienceIDE-Hard。
它们来自 PLUTO 等几个代表性代码库。修复任务 52 个,实现任务 33 个。
判定标准是与私有科学参考答案一致,而不是程序执行成功。
参评的 15 个模型来自 8 家厂商。都通过各家命令行工具执行,每题给一小时预算。
结果里最强的 Claude Fable 5.1 做到 67.1%。紧跟在后面的是 64.6% 和 63.1%。
一半以上的前沿模型停在 30% 以下。
真正的科学任务,远没有被解决。

科学不只是应用场景,也可能是训练场
这批工作还有另一侧结果。
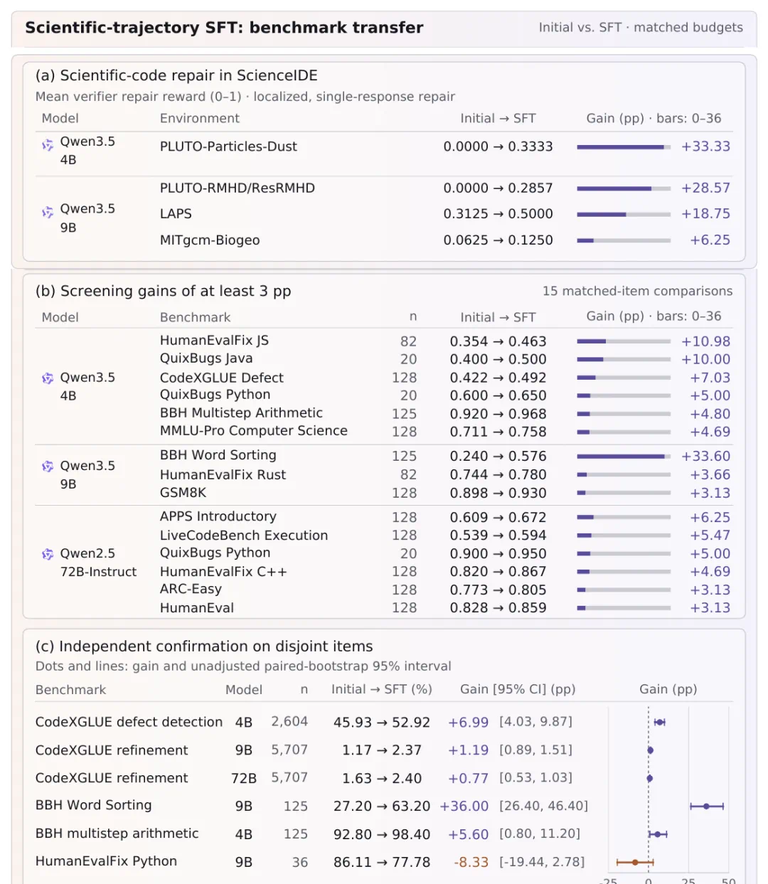
团队拿经过验证的科学交互轨迹做监督微调。训练并开源了三个不同规模的模型,小到 4B,大到 72B。
变好的不只是科学任务。代码、推理和知识这三类通用基准同时受益。
比如最大那一档。入门级编程题通过率从 0.609 提到 0.672。代码执行基准从 0.539 提到 0.594。
最小那一档则更夸张。排序类推理题从 0.240 直接跳到 0.576。
这组数字指向一个判断。科学不只是模型的应用场景,也可能是推高智能上限的训练场。
科学任务天然更长程,也更依赖对物理约束和数值行为的理解。
一个非营利组织和一份公开邀请
AItonomy Foundation 注册在硅谷。它想做的是加速人工智能与科学之间的闭环。
按官网的说法,这个闭环靠可靠的反馈撑起来。模型提出假设,得经过计算或实验检验。
科研过程里的数据、操作记录和失败尝试,也要整理验证之后才能变成学习材料。
论文能传递成果。它留不下得出成果之前的判断、调整和试错。
ScienceIDE 想把这些过程接住。科研人员可以从自己熟悉的代码库出发,参与定义任务和验收标准。专业判断就此变成可重复使用的科学检查。
目前参与的研究者来自二十余所机构。伯克利和牛津都在名单里,哈佛也在。他们以个人身份加入。
值得一提的还有一件事。团队公开表示,想把 Anthropic 这次开源的 36 个优化包整理成 ScienceIDE 环境。
这些包自带参考实现,也自带可量化的验收标准。条件接近理想。
如果这件事成了,社区拿到的不只是一批优化结果,而是能在这类工作上训练和评测模型。
回到开头那个问题:AI 写出的科学代码,离吃满硬件还有多远。
PLUTO 那次实验给出的答案是数倍。要把这几倍拿到手,靠的不是更强的一次生成。靠的是测量和诊断,修改和验证,再迭代。
Anthropic 的报告证明了模型有能力做这类工作。ScienceIDE 想回答的是下一问。怎么让这种能力持续积累。
一次次成功的优化,能不能变成可反复学习、可验证的经验,再迁移到新问题上。
几十年积累下来的科学软件,本身就是一座没被充分开采的富矿。现在它多了一位新的学习者。
