

一张家用显卡,一段参考视频,画面就跟着操作长出来。
这不是提前录好的演示。
一家做三维生成的公司,今天把实时世界模型开源了。
权重和推理代码都放了出来,技术报告和端到端演示也在。
图 1 · 参考画面交进去,精细画面实时长出来
三路输入一起说话。
图 2 · 同一套布局,换出另一种画风
同一条街,能长成写实,也能长成二次元。
图 3 · 单张消费级显卡上跑出的实时画面
官方给的口径很具体,单张消费级显卡,720P 分辨率。模型五十亿参数,生成速度超过每秒二十四帧。
不是撑住几秒,是能连着跑几分钟。从按下按键到画面更新,端到端延迟在百毫秒级。这个数字比帧率更影响手感。
它管的只是那张画面。
角色走到哪,血条怎么掉,由上游的交互系统维护。
模型接到状态变化,再把画面补出来。
两件事分开做,是这套东西的骨架。
跟 AI对话 那种一问一答不同,这里每秒要反馈几十次。
先说它能干什么,演示一共四类。
第一类是游戏原型预览。
二维和三维场景都能接进来。
岩浆闯关里,角色拿冷冻枪烧出落脚点,再一路跳过去。双人对打里,按键出招,血条和回合计时跟着走。
现阶段适合漫游这类交互不密的玩法。
操作太激烈,它还会掉链子。
第二类是场景和动画预览。
布局和运镜定好,只换美术风格。
那只天天被网友玩的鹈鹕,这回真骑上了自行车。
羽毛的质感和海边光影,都被补了出来。
拿简单模型搭的雪地公路,也能长出写实的车身和积雪。
参考画面给布局,首帧定画风,提示词补细节。同一套运镜,能出好几个美术版本。导演和概念设计师可以摆在一起挑。
做原型的 AI编程 工具已经能搭场景,难的是让它动起来还好看。
第三类是视频重渲染。
已有素材交进去。形象能换,内容能换,风格也能换。
蓝幕前的真人能变成卡通角色。姿态和衣服配色,还跟参考画面一致。
有点像虚拟主播换形象,用真人动作带另一张脸。
实拍的房子也能变成手绘动画。
屋顶和墙面用线条重新勾,光更柔。
第四类是给机器人攒数据。
真人干活的画面,可以换成机器人视角。
手拿喷壶擦台面,生成后双手变成机械手。抹布从橙色变黄,动作还是原来那个动作。
物体的材质和颜色,也能跟着改。
一段操作视频,能衍生出好几个版本。
四类用法有一个共同点。
参考一直在给方向。
画面可以换,动作不能飘。
这也是它没去做纯文生视频的原因。
纯文生视频每一帧都在重新猜。
猜出来的东西,接不住连续的操作。
这类 AI工具 得一直有参考托着。
它现在也有短板。
高频操作对速度和动作要求更高。
几个角色同时出现,谁是谁容易糊。
小物件的精细控制,长时间生成的画面一致性,都还要再练。
源码和权重都开了,技术报告和演示也在。
另外还开源一个技能包,把一句提示词变成能直接玩的游戏原型。
游戏逻辑在交互系统里跑,模型只负责把它画漂亮。
这条链路,现在普通人也能自己接一遍。
拆开看,技术路线就一句话。
世界怎么运行,和画面怎么呈现,分开处理。
比如那段街头对打。
角色怎么走,怎么打,怎么防,都来自玩家按键。
交互系统收下操作,算位置,算动作,还算血量。
模型根据这些变化出画面。
左边是方块小人,右边是写实角色。
玩家看到反馈,接着按键,循环就这么转起来。
把分工放进整条管线,看得更清楚。
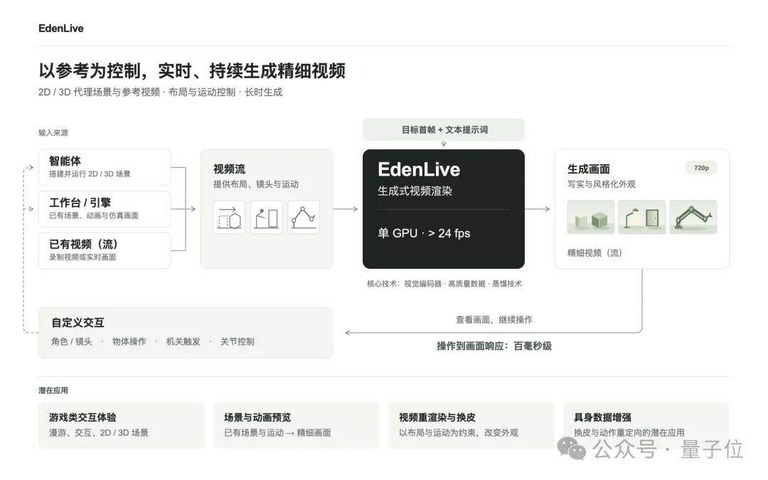
图 4 · 简化场景进来,精细画面出去
图里左边是参考输入,给布局和运动。
中间是模型,负责出细节。
右边是交互系统,负责改状态。
各管一段,谁也不越界。
听起来简单,做起来要同时兼顾四件事。
画面够细,动作跟得上参考,速度够快,还能一直跑。
第一件难在数据。
要让方块小人变成写实人物,动作还得对得上。
就得有大量成对的参考和成片。
布局和镜头,物体的位置,都要在数据里对齐。
这活覆盖二维和三维的简化场景,也覆盖引擎渲染和真实拍摄。
从采集到配对,全靠人一句一句抠出来。
第二件难在协作。
做三维的,做视频生成的,做系统工程的,得坐在一张桌上。
画面变好,推理速度就掉。
外观一换,动作又容易飘。
这些事只能一起解。
第三件难在判断。
方向定错了,再多数据也白搭。
它们四个月前就选了分开做这条路。
图 5 · 三层分开,各管一段
三层是这么分的。最下面一层存放一直在变的状态。中间一层管状态怎么变成观测。最上面一层是生成式渲染,把观测画成画面。
这套说法,比行业里形成共识早了三四个月。
那三四个月,就是它们攒数据、磨模型的窗口。
它们的老本行是三维生成。
做可交互的世界,需要角色、道具和场景。
物体的位置和尺度,还有空间关系,都得说清楚。
三维正好能把这些组织起来。
视频生成补的是另一头。
材质和光影,还有动态,都在这层出。
两边合起来,创作者改场景的时候,画面能跟着变。
这也是它们往世界模型走的理由。
原来的三维能力,除了生成资产,还能产数据。
从视频里提深度、相机位姿和几何轨迹。
再从游戏引擎里拿成对的状态和画面。
以前的积累,就这样接到了新问题上。
往后看,创作者能做的事在变大。
先出角色和道具,再搭场景,再加交互规则。
最后给跑起来的内容换一套皮。
它们给这件事起了个说法,让人人自由创造并体验可交互世界。
这一步先由实时渲染模块来趟。
对做内容的人来说,入口也变具体了。
把已经能跑的场景接进去,边玩边看效果。
顺便说一句,它们在招人。
方向是三维生成和三维理解,还有智能体和世界模型。
实习生也能碰核心模型的训练。
这一行的门槛,正在一层层往下掉。
以前要一个团队两三个月做的画面,现在一张卡就能实时算出来。
这不是终局。
但现在,普通人已经能摸到了。
