

好家伙,智谱把垂直模型卷到法律圈了。
就在刚刚,智谱发布了一个新的法律专用开源模型,名字叫GLM-Legal。
这次不是聊天助手,是奔着合同和案卷去的。

智谱官方宣布GLM-Legal上线
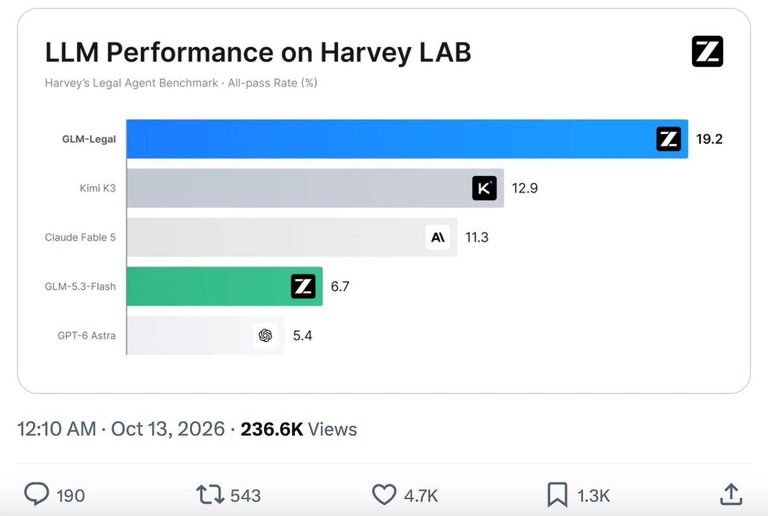
Harvey LAB 全通过率榜单
这类AI工具开始往行业里扎。
它干的事挺具体。
审合同是一块,串证据是一块,跨境合规研究又是一块。
干完还给你一份能直接用上的成果。
不是让你自己再整理一遍。
成绩也相当能打。
在一份海外机构最新公布的法律测评里,它的任务全通过率是19.2%,准确率86.23%。
开放权重模型里,两个榜单它都排第一。
一个是Harvey LAB,一个是LegalBench。
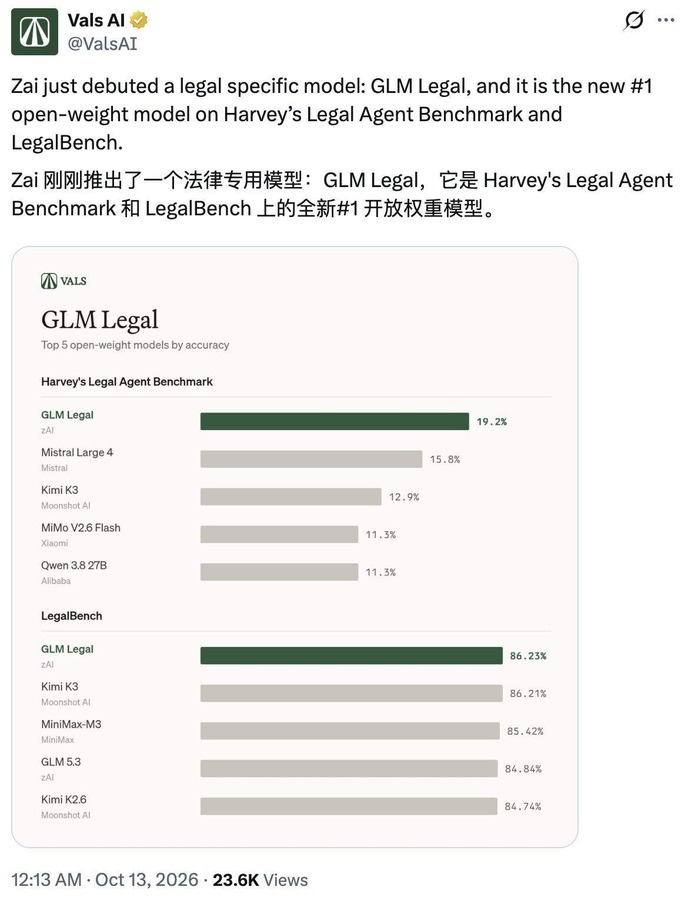
Vals AI 说它是开放权重第一名
AI对话这块早卷成红海了。
卷完聊天,卷完办公,卷完代码,现在开始盯合同和案卷里的细活。
消息一出,评论区坐不住了。
有人直接说,以后GLM-Legal就是我的法务团队了。
这话半开玩笑,也说出了不少人的期待。
网友说法务团队有着落了
替人干活的三种样子
但它到底学的是哪国法律。
能不能帮我们干活,还得展开看。
它适配咱们这边的法律,不太会水土不服。
中文的实务它接,英文的任务也接,东南亚的跨境合规照样接。
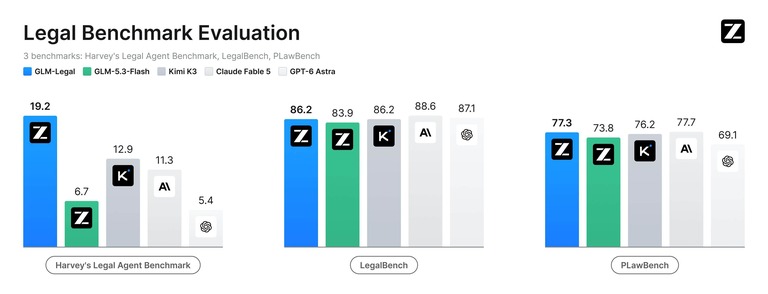
三套基准的得分,最高19.2
考试归考试。
真实法律工作的坑太多了,一踩一个不吱声。
所以还是得把它拉进真实环境里溜溜。
看它能不能替团队审合同,能不能把海外上线前的隐私合规捋清楚。
先看三组官方演示,都是拿它跟自家上一代通用模型对打。
图里那句我这一生如绿豆冰
一、审合同,顺手把散场安排说明白。
换软件供应商的时候,先要审明白合同里的终止条款和交接条款。
代码能不能拿回来,数据能不能拿回来,文档能不能拿回来。
新供应商接不接得上。
这些雷就埋在条款里。
这跟AI编程里的代码审查有点像,都是先找埋着的那句。
它给出的建议很具体。
终止通知时间从60天缩短到30天。
再增加最长90天的过渡支持,把代码和文档的交接都安排进去。
同时结合合同已有的成果归属约定,要求交回全部工作成果。
包括尚未完成的部分。
也包括尚未付款的部分。
两句话看着平淡,实际是把时间写死了。
通知期短了,主动权回到我们这边。
过渡期长了,对方跑不掉,我们也不用赶着上线。
分手这件事,它给安排得挺体面。
这类条款平时最容易被忽略。
签的时候没人细看,出事的时候才发现没写。
它把这一段拎出来,等于替人补了一课。
审合同的难点不在读得懂,在想到该问什么。
想到该问什么,才算真会审。
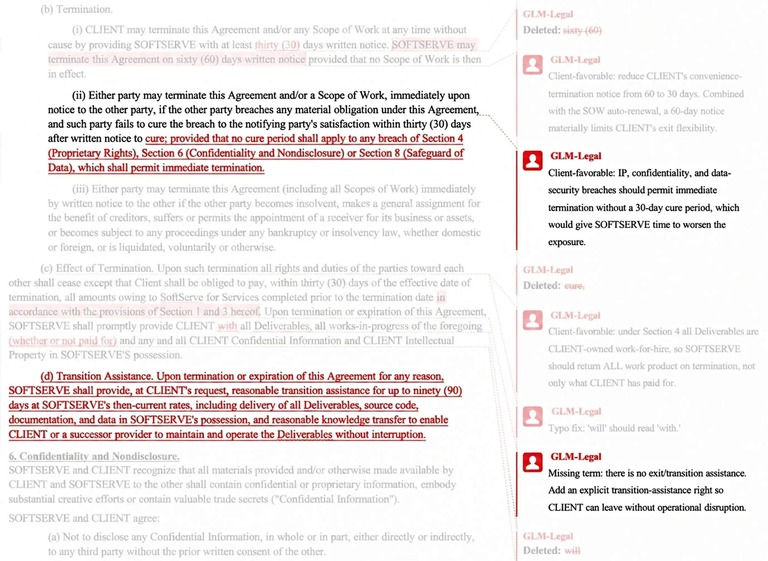
60天改成30天的修订痕迹
跟自家上一代通用模型比,差别一眼能看出来。
那边只给了一段比较泛的建议。
这边把时间写清楚,把交接范围列清楚。
还把修改方案跟合同里原有的约定对上了。
对得上,才有说服力。
不然条款改完,前后打架自己都不知道。
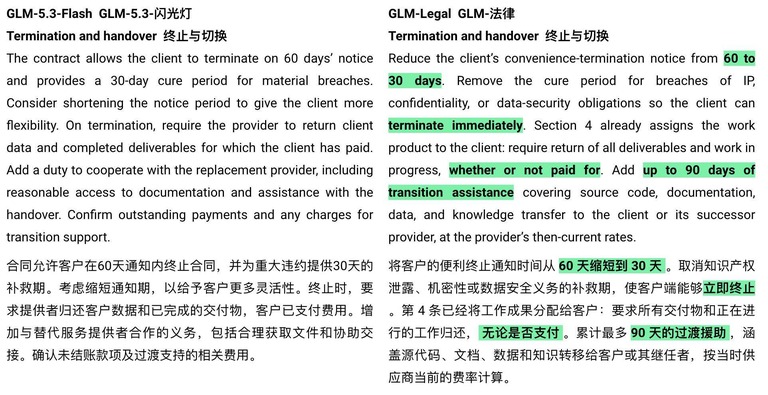
终止与切换:两边的差距在这
二、分析证据,把散落的线索串起来。
这个问题更现实。
项目合作起了纠纷,一方说干完了,另一方说没干完。
怎么从一堆报告、文档和聊天记录里判断真假。
官方给的例子是这样。
对外报告里写项目完成了60%,内部记录只有41%左右。
两个模型都发现了这个矛盾。
差别在后面。
上一代只给建议。
它则在建议之上,把进度报告跟更早的风险提示、内部沟通串了起来。
最后落到具体动作上。
这一串起来,问题就清楚了。
不是说数字不对,是有人在报喜。
有了这条线,才好回去翻原件。
散落的证据最难的,是时间顺序。
谁先说的,谁后改的,中间隔了多久。
人做这件事靠经验,也靠耐心。
机器做这件事靠的是把材料读全。
读全了才敢下判断。
这一步最费时间。
也最容易被跳过。
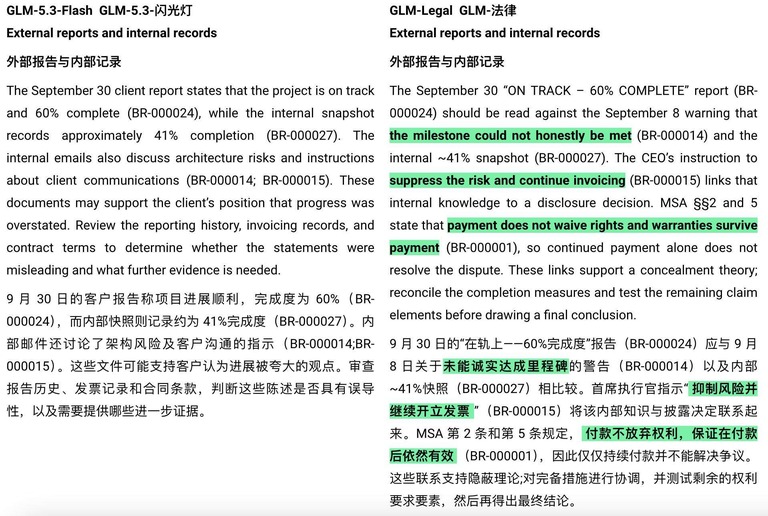
对外说60%,内部只有41%
回到原件逐项核对,才知道哪个数字能用。
这一步只能人来拍板。
模型把线索摆好,判断权还在人手里。
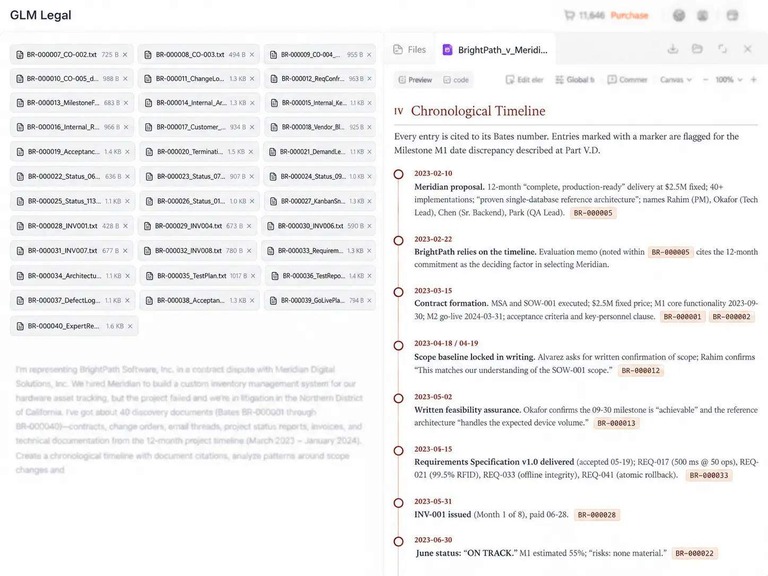
文件列表里有11,646这个数
三、企业出海,把法规要求整理成能动手的清单。
准备在东南亚几个平台上线的网站,麻烦事不少。
用户追踪涉及隐私,邮件营销涉及隐私,云存储放在海外也涉及隐私。
上线前到底要准备什么,很多人说不清。
它把需要关注的合规事项拆成了步骤。
一步能落实,下一步能继续核查。
包括发布具体的隐私声明。
也包括让退订请求进抑制列表这类细节。
看一眼就知道先做哪件。
清单的好处是能派活。
派得下去,才叫方案。
派不下去,就只是几句提醒。
这几句话,读过合同的人都懂。
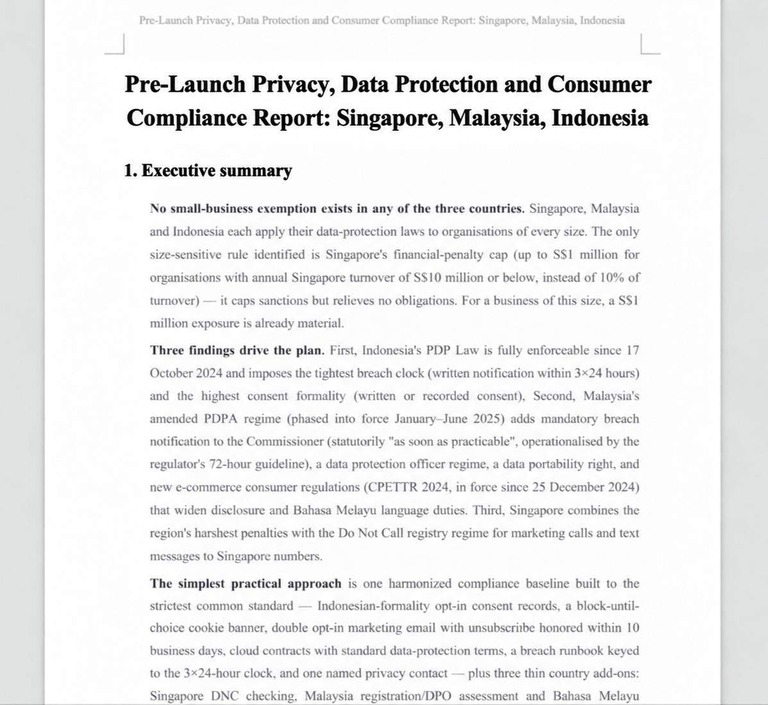
Pre-Launch 合规报告的第一页
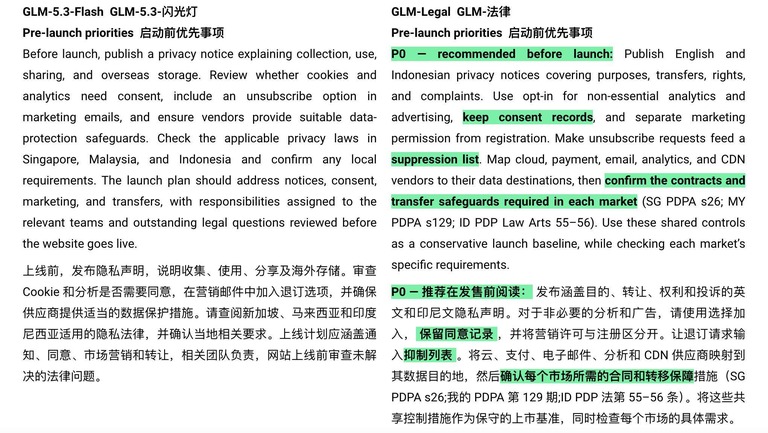
启动前优先事项的清单
这下方便多了。
现在回头看19.2%这个数字。
它不高,但它很难。
这套测评不是纸老虎。
它用的是全条件通过。
一项任务里所有评分条件都满足才算过。
少一条都不算。
任务本身也照着律所派活的样子设计。
给一个需求,给一组客户材料。
让它直接交出一份能拿去审阅的文件。
读材料,调工具,再按规矩把结果交出来,一路都不能掉链子。
这就是它值钱的地方。
换句话说,考的不是知识点。
考的是能不能把一件事做完。
做完还得能交出去。
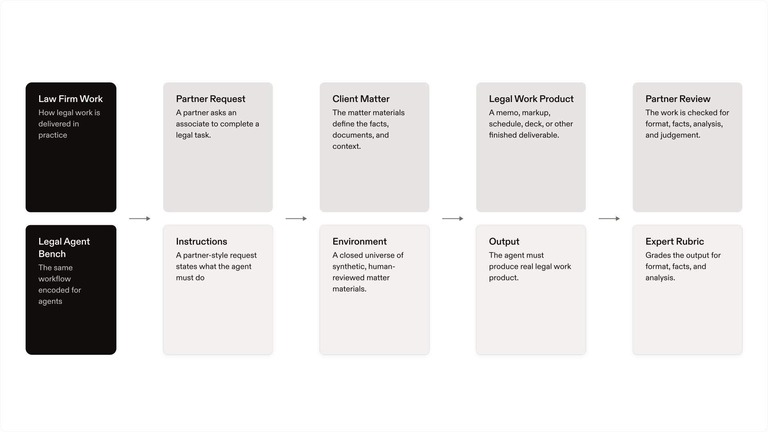
Partner Request 到成品文件
光是第一版测评,就设了1200多项模拟任务。
覆盖24个法律业务领域。
并购是一块,知识产权是一块,银行金融又是一块。
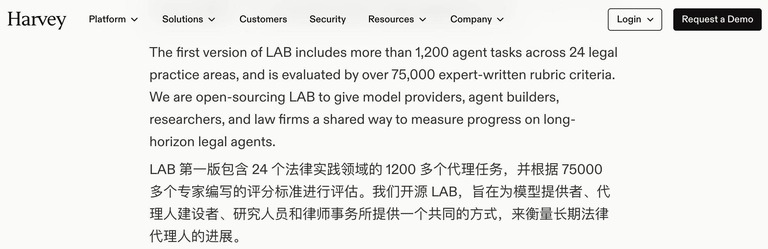
1200 多项任务,覆盖 24 个领域
成绩之外,还有一组账单值得看。
成绩差不多的情况下,它比Gemini 4 Argon慢了将近30分钟。
但对方每项测试的成本,大约是它的70倍。
慢半小时,便宜七十倍。
这笔账放在真实业务里,方向完全不同。
一次两次看不出来。
一年几千份合同,差距就出来了。
律所最怕的不是慢,是贵。
贵到不敢多用,再强的模型也落不了地。
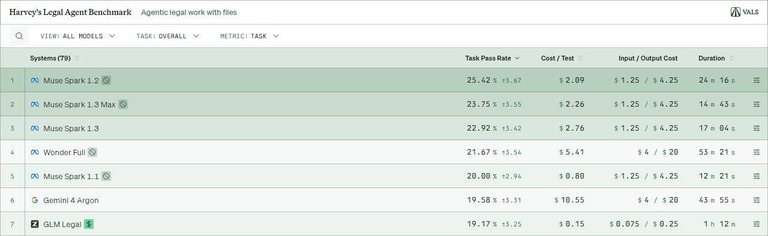
Harvey 榜单上,价格一栏也在
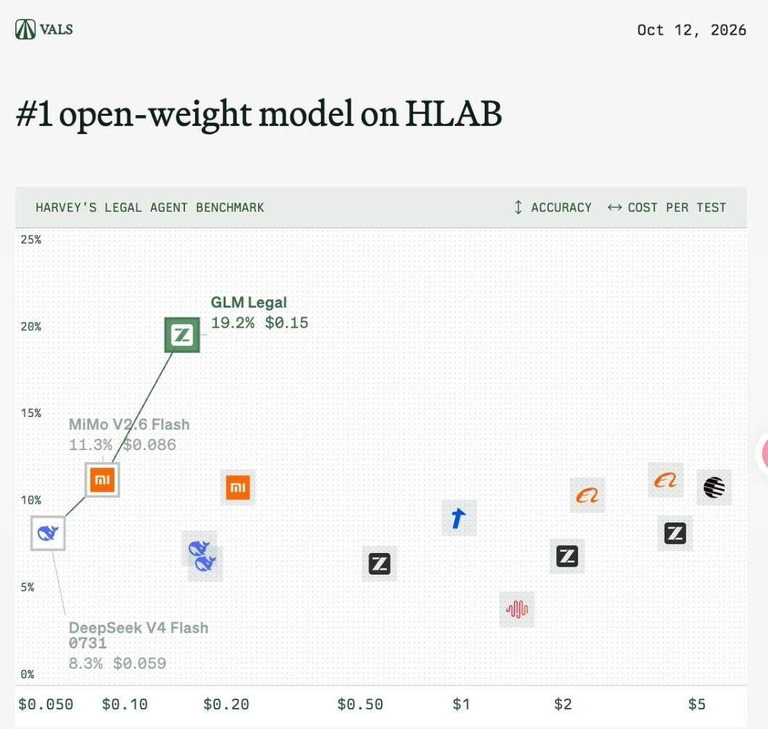
VALS 说它是开放权重第一
所以挑法律工作搭子,成绩要看,成本要看,时间也要看。
三样放一起,才有答案。
光看榜单会走偏。
表情包:挑选装备中
先上法学院,再去实习
那它是怎么训出来的。
智谱给的路径可以概括成一句。
先送进法学院,再带到模拟律所练手。
第一步是在上一代通用模型的底座上做法律语料的中期训练。
学法律概念,学法条,也学分析方法。
基础打牢了再往下走。
第二步是在数万个法律任务环境里做强化学习。
练读材料,练做分析,练推进任务,练交出成果。
同时团队还在改它的运行框架。
材料怎么组织,工具怎么连,反馈怎么走,都要一起磨。
模型和工作环境一起磨合,这一点很关键。
光有知识不够,得会在环境里干活。
这套办法其实不新鲜。
人也是这样练出来的。
不同的是,人练一遍要几年。
它练几万个环境,按天算。
效率差得不是一星半点。
但方向是一样的。
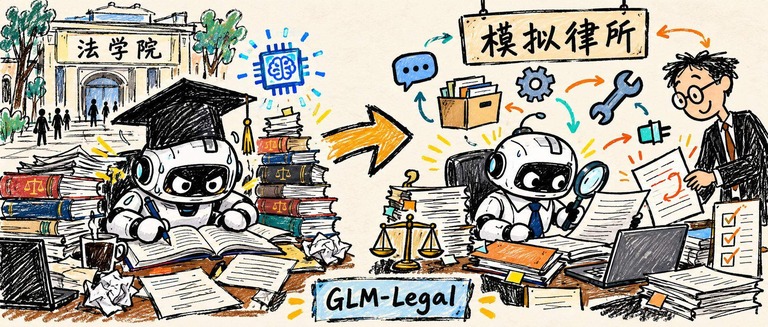
法学院到模拟律所这条路
眼熟就对了。
这不就是法学生走过的路。
先考进法学院啃书,再进律所实习,最后熬成能签字的律师。
它现在走的是同一条路。
只是还停在实习那一段。
实习生会干活,但还不能独立出庭。
这个比喻挺准确。
也提醒大家别把期待拉太满。
高估一个模型,比低估它更危险。
两个啊字
它现在还挺青涩。
19.2%的全通过率也说明,严格评分下多数任务还没全达标。
空间还很大。
智谱的动作也对应得上。
它在邀请律所,邀请法律科技公司,也邀请企业法务团队和独立执业的人来申请内测。
让真干活的人来试用,提意见,一起磨。
同时计划把这套能力接进AutoClaw。
从演示走向真实业务。
这个思路是对的。
模型的能力边界,一线的人最清楚。
律师说哪一步不敢用,比榜单更有用。
榜单衡量的是任务通过率。
律师衡量的是敢不敢签。
两个标准差得远。
先把前者做上去,再谈后者。
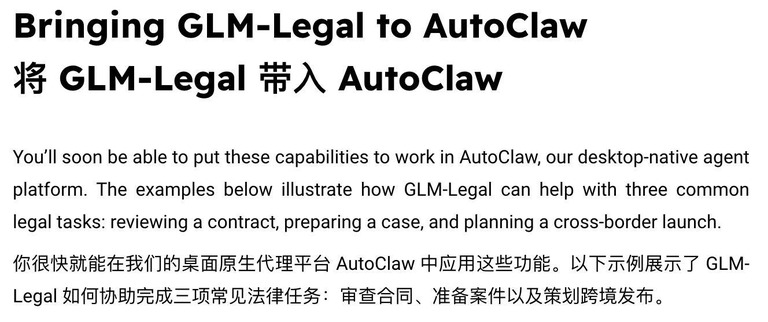
Plan 里写着 AutoClaw 与 Beta
这背后信号挺清楚。
它在拉一群最懂行的人一起打磨。
目标不复杂,让它成为律师手里顺手的一件工具。
顺手这两个字,比强大更难做到。
强大是跑分,顺手是习惯。
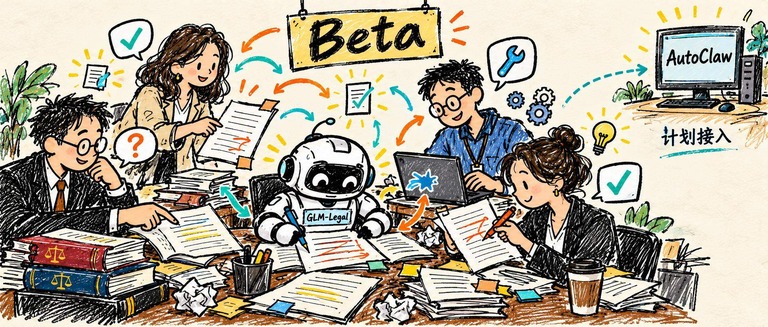
接入 AutoClaw 的计划页面
能不能做到,值得看一阵。
这类垂直模型的故事,才刚开始。
这条路还要走一段
这不是第一次
其实智谱做法律模型不是心血来潮。
早在2023年,它就跟法律科技公司幂律智能合作。
基于1300亿参数的底座,联合做了一款法律垂直模型。
场景是法律咨询,合同起草,合同审查。
后来它还以老股东身份,连续参与对方的战略融资。
最近一轮是近8000万元的Pre-B轮。
这条路它走了三年。
不是看到风口才进场的。
这解释了它为什么敢做开源。
开源是为了让行业一起把场景磨出来。
场景多了,模型才稳。
智谱与幂律智能的 PowerLawGLM
把通用模型送去读法律的,也不止它一家。
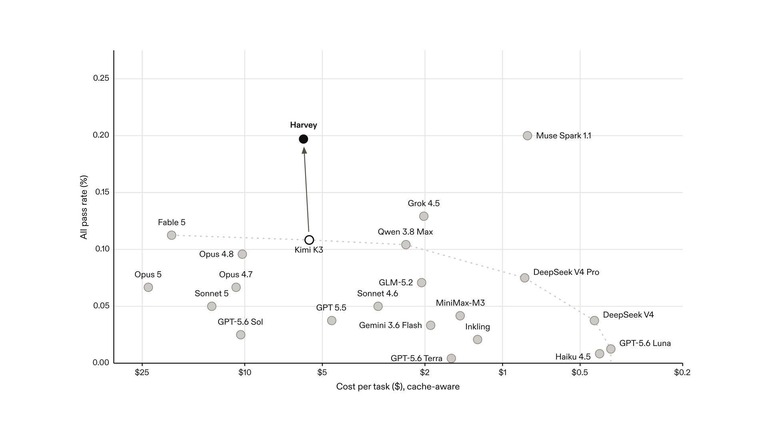
今年8月,Harvey联手Fireworks做了一款法律模型,叫Tenet。
底座是Kimi K3。
据对方介绍,专项训练之后,它完成的留出任务数量接近底座的两倍。
成本基本没变。
这个结果挺说明问题。
底座够强,后训练就能往上加。
不用从零造一个模型。
Harvey 那款模型的成绩对比
这些尝试给行业留了一个思路。
选好通用底座,再用专业任务、行业数据和工作环境继续训练。
能力还有机会往前推一步。
推一步,可能就是一个新场景。
往后谁能把专业课教得扎实,谁能把模拟律所搭得实用,谁就更容易被认。
被认,才有复购。
这一圈用户不多,但很挑。
挑的是细节,不是参数。
细节对了,才敢把活交出去。
只留一个 thinking
Gemini会员中转站 微信:douhanq
