

意图理解这条线,最近被一个模型搅热了。
Jev。
海外一家公司放出的专用小模型。
它证明了一件被忽略的事。
判断用户想干什么,不必劳驾千亿参数去硬想。
小模型也能又快又准。
于是决策层和生成层被拆开。这成了智能体落地的热门话题。
这不是把模型做小。
是把高频的那类活拆出来,交给专门的模型。
它只回答一件事,用户想干什么。
剩下的执行,交给后面的大模型。
分工的好处,是每层都能单独优化。
拆开之后,留下一个洞。
判断出用户要开灯,谁负责把灯号和亮度交代清楚。
举个真例子。
东侧那排灯调到八成,色温四千。
西侧那排调到三成,色温二千七。
入口那盏别动。
听出调灯两个字,只是第一步。
系统还得知道哪盏灯对应哪个数。哪盏必须原样留着。
真实场景里,这种话一天能撞见几十回。
一句里塞着对象和数值,还有不许动的东西。
听懂只是及格线,落地要的是准确。
智能体要接进手机、汽车和企业软件。
光听懂一句话,早就不够了。
翻开 Jev 的说明书。
它给了三种决策原语。
一种是布尔判断,回答是或否,给个零到一的概率。
一种是从互斥选项里挑一个。
一种是在有序量表上打分。
三种能并行,延迟低到七十毫秒。
它擅长在给定选项里快速拍板。遇到没预设过的字段,就卡住了。输出被候选框死,真实业务里的开放式参数它接不住。
把工单转给某个人,优先级设成高,另一张保持原样。
这类活要分类,要抽信息,还要把实体对上。两个工单,两种要求。
用户说得越自然,背后的参数越乱。数字对不上,后面全错。
十月十九日,中电信人工智能科技的星辰实验室放出了 Xing4.0-29B-Intent。
名字太长,记住它干的事。
它把意图理解从选择题,扩成选择题加填空题。
判断类别,同时把实体和数值抽出来,用一套统一结构返回。
省掉业务系统再拆一遍原文的功夫。
权重和语料一起开源,代码在 GitHub 和 Hugging Face 上都能拿到。
我们拿了接口,做了十一组实测。
覆盖智能空间和智能座舱,还有办公协同和个人助理。
十一组里有家居,有车窗,有工单,也有闹钟。
对做 AI工具 的人来说,这段更值得看。
看它在复杂指令下,能把参数提多准。
差别在哪,一张表能看清。
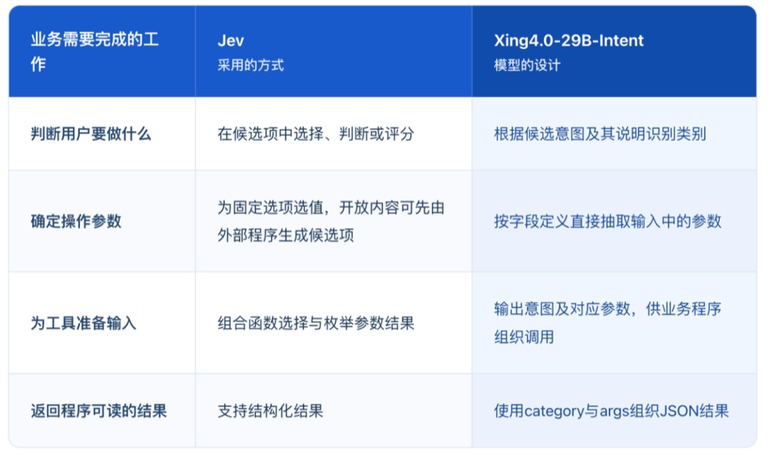
两类模型的分工对照表。
以展厅灯光为例。
一句话点了三处灯,还有背景音。
回来的结果分两类。
灯光两个对象,各自带亮度和色温。
音量一个对象,带位置和数值。
入口那盏没进列表。
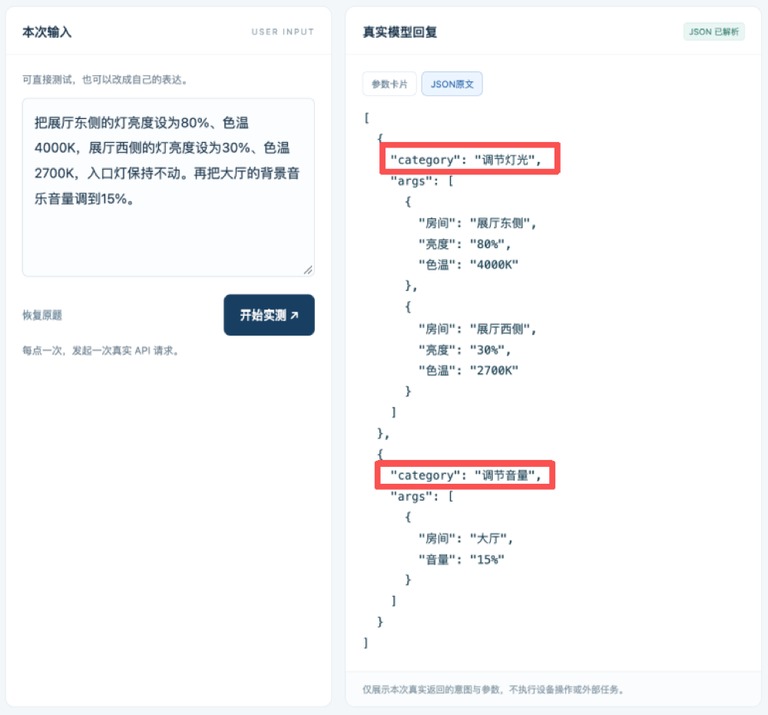
实测截图:输入一句指令,直接回结构化结果。
这组结果的价值,在于对应关系没乱。
对象和属性都被绑在一起。该不动的,确实没动。
这类指令在智能家居里很常见。一句自然语言,拆成几组准确参数,拆不准交互就废了。
展厅东侧调到八成,西侧调到三成。两个对象,四个参数,一次对齐。
换成人工配置,得点六下。换成通用大模型,多半会漏掉色温。
对做 AI对话 的产品,这个差别很实在。
判断决定方向,抽取决定能不能落地。
只想快速判断,走 Jev 那条更省。
要把结果直接灌进业务系统,别只看选择题那一层。
性能上也没因为填空变慢。
端到端延迟低于一百五十毫秒。
Jev 那套落在七十到五百毫秒之间。
它在区间之内。
输出被结构强约束,格式幻觉压得很低。
换成字符串自由生成,下游还得自己解析。
结构化返回省掉这一层,也省掉一次对账。
指令越长,这一步越不能错。
这也是专用模型值钱的地方。
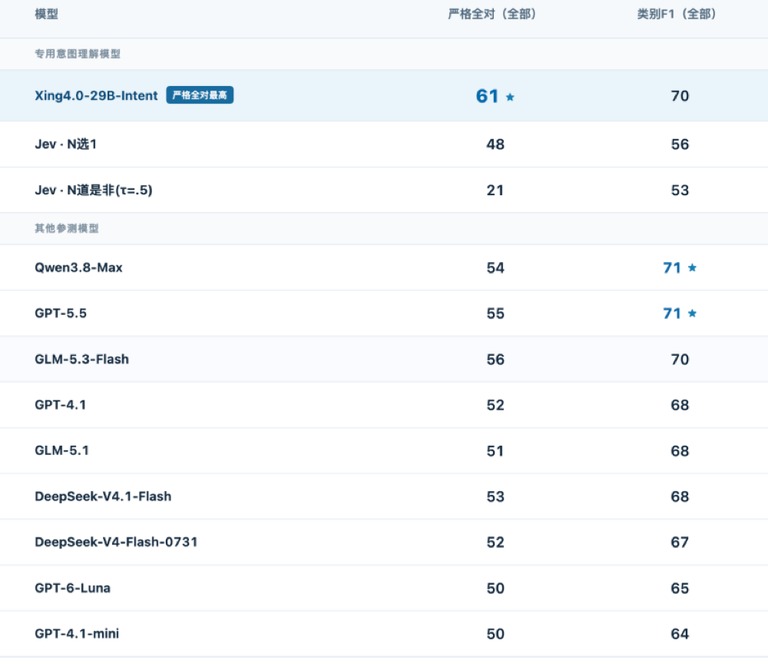
零样本冷启动的评测结果。
成绩部分更直接。
零样本意味着不给例子。
它的综合分是七十点二七。
比 Jev 最好的配置高十二点六二个点。
也压过了 GPT-4.1。
严格全对这项,它拿六十一。
那个指标要求每条都对,错一条不算。
Jev 两种配置在二十一和四十八之间。
差距就出在这里。
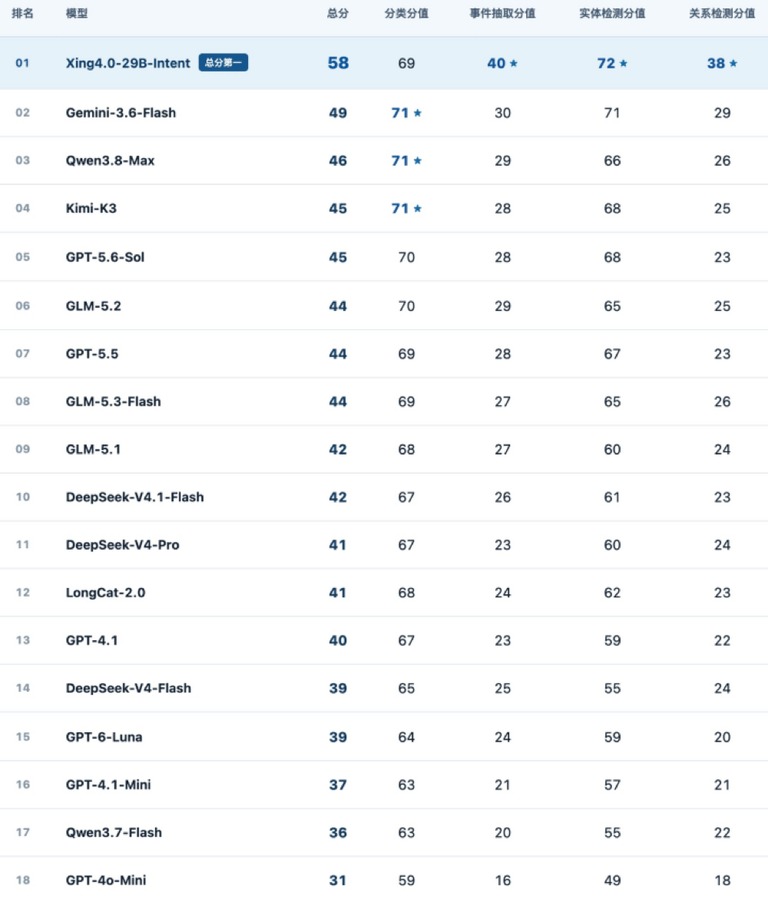
四十八个公开数据集的统一排名。
统一榜单上,它在四十八个数据集里拿到五十八分。
比第二名高九分。
那第二名是谷歌的一款轻量模型。
实体识别,关系抽取,事件抽取,意图理解,四类都领先。
人名的位置,地名的位置,组织的名字,这些是实体。
两个实体之间什么关系,是关系抽取。什么事发生了,谁参与了,是事件抽取。
听起来是三件事。落到业务里,都是同一件事,把信息放对格子。
一张报销单,要抽报销人,费用类型,金额,所属项目。
一张工单,要抽门店,设备,故障,联系人。
意图分类只回答这单属于哪一类。
剩下的位置,得靠抽取填。
先看智能空间。
一句话同时管四台设备。
投影仪,窗帘,主灯,空调。
区域和开关状态,逐个对上。
这类场景里,用户不会一台一台说。
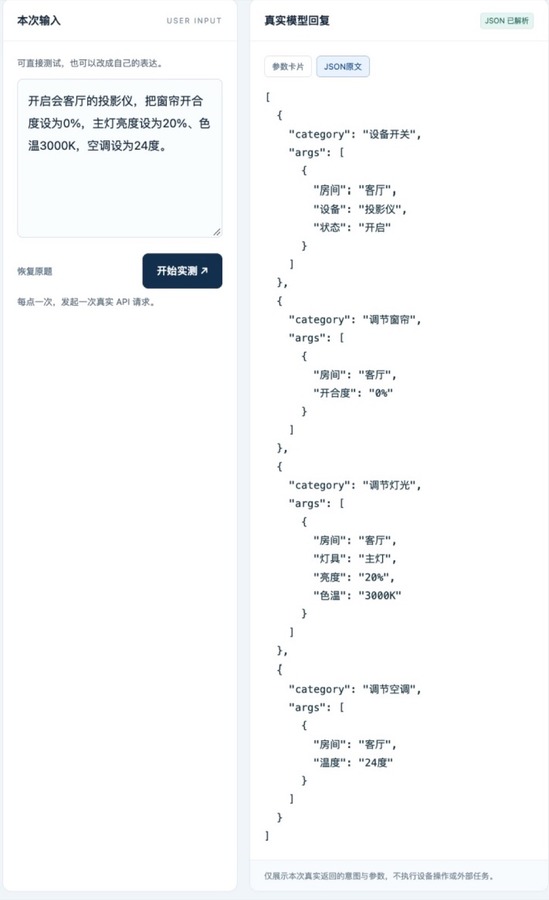
实测截图:四类设备一次拆开,区域和设备对得上。
座舱那组给出了一道难题。
多个车窗同时提要求。
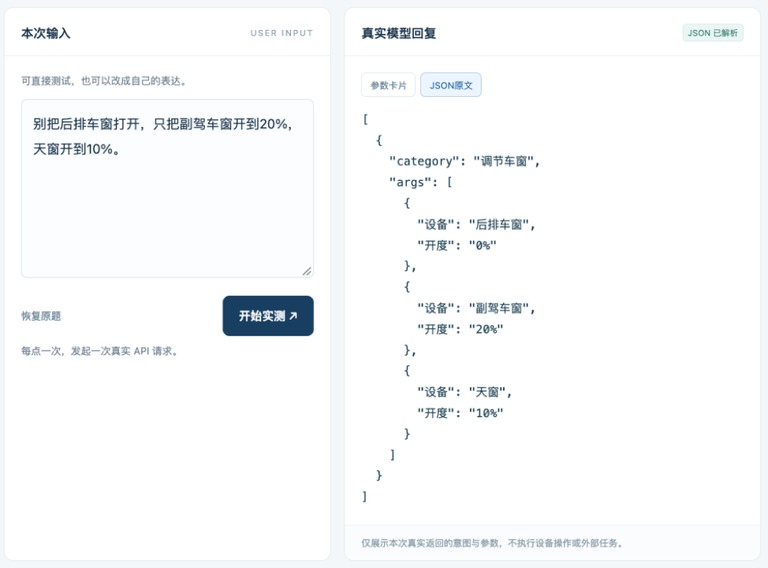
实测截图:禁止打开车窗,被理解成关闭车窗。
副驾和天窗的开度抽对了。
但后排原本开着一条缝,执行零点反而改了原状态。
物理设备上,听懂否定比听懂肯定更要紧。
企业业务是另一种考验。
信息多,字段杂,还不能张冠李戴。
两家门店,不同设备故障和联系人,它分得清。
两份项目记录,负责人预算和交付时间也没串线。
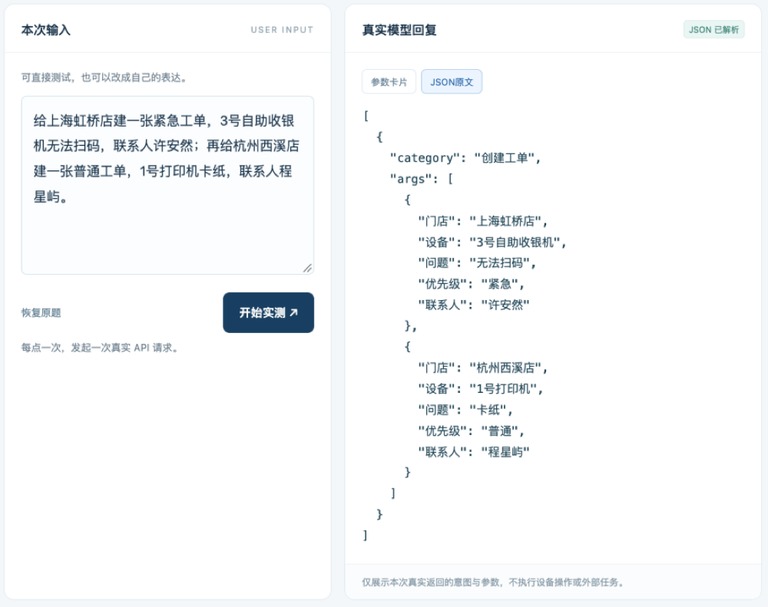
实测截图:两家门店的工单信息准确对应。
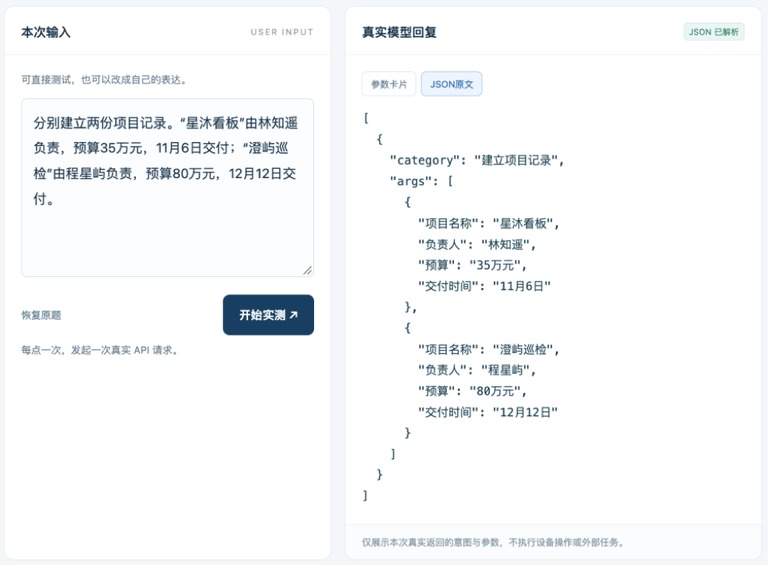
实测截图:预算和交付时间都没串线。
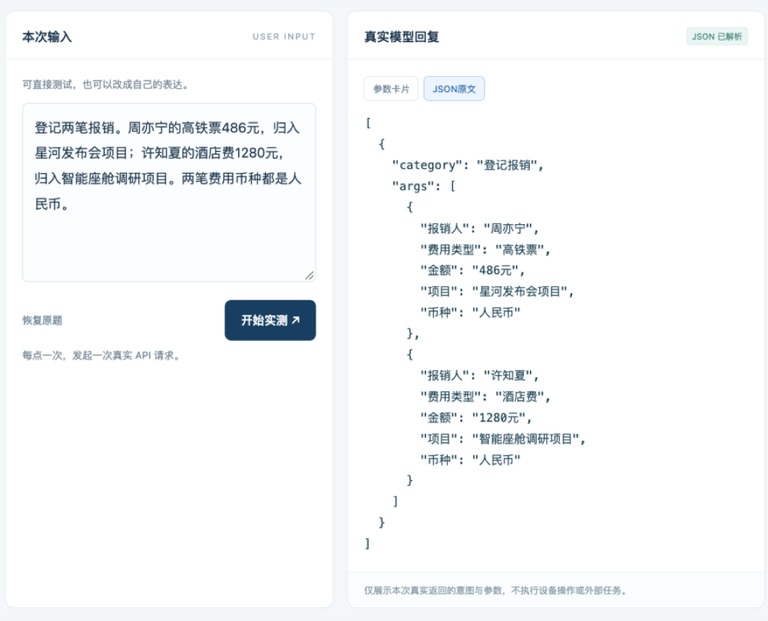
实测截图:两笔报销的金额和归属项目都对上了。
更进一步,更新工单和发通知被塞进同一句话。
它拆出两类意图,跳过了那张要保原样的单子。
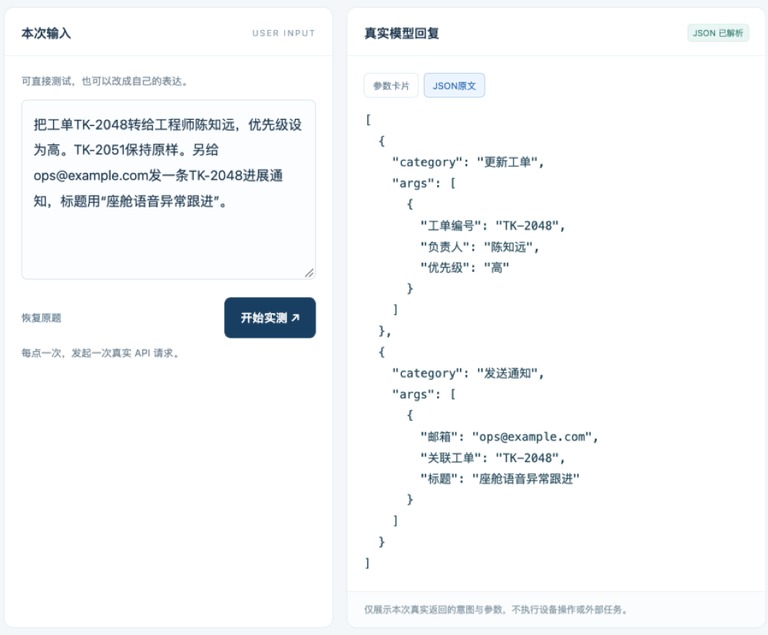
实测截图:更新工单和发消息分别提取参数。
这些字段看着琐碎,正是企业系统的命门。
一笔报销挂错项目,后面全乱。
回到日常办公,复杂安排也没难倒它。
一次交代会议和任务。地点归地点,参会人归参会人。负责人和截止时间也没混。
接入系统的基础,就到这一步。
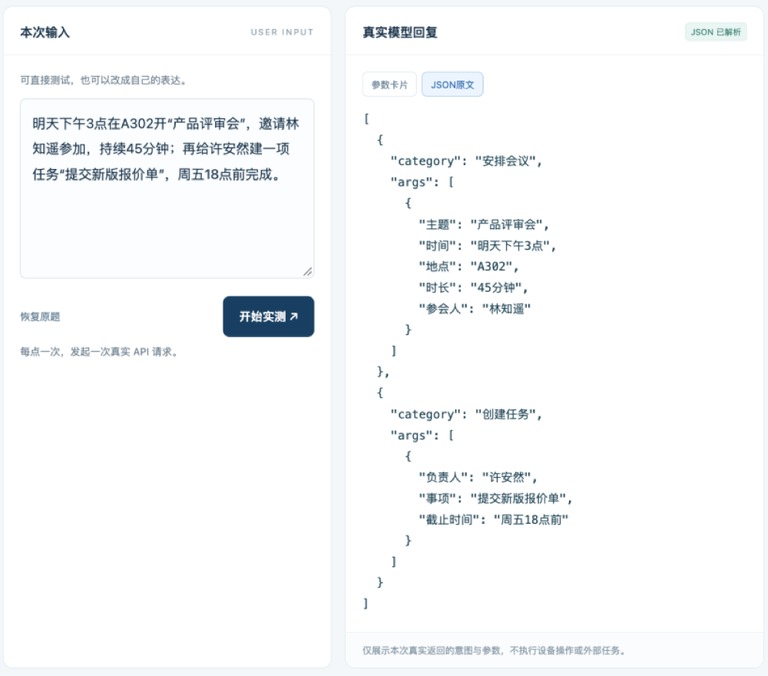
实测截图:会议和任务一次拆开。
更有意思的是多轮修改。
时间改了,地点改了,参会人也换了。
原先约好的三十分钟,它没丢。
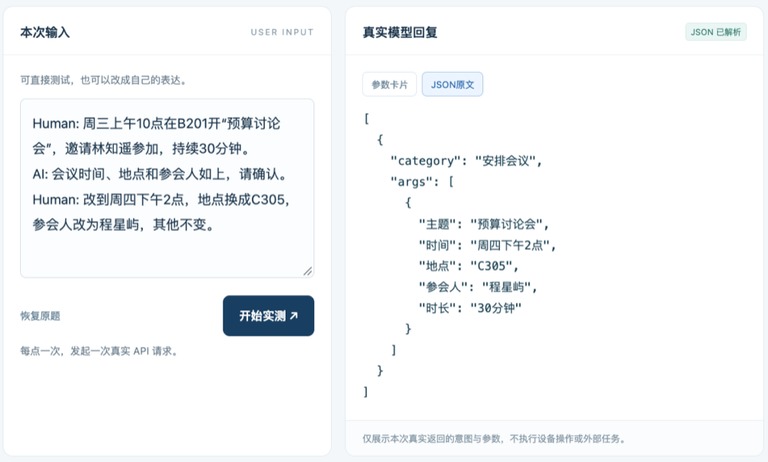
实测截图:改了会议信息,时长还在。
这种能力很贴近日常。
人常说时间改一下,别的照旧。
个人助理场景里,它也有戏。
一口气设闹钟,建一个提醒,再记条备忘。
三项任务分别整理。
给两个联系人发消息,两段内容没串。
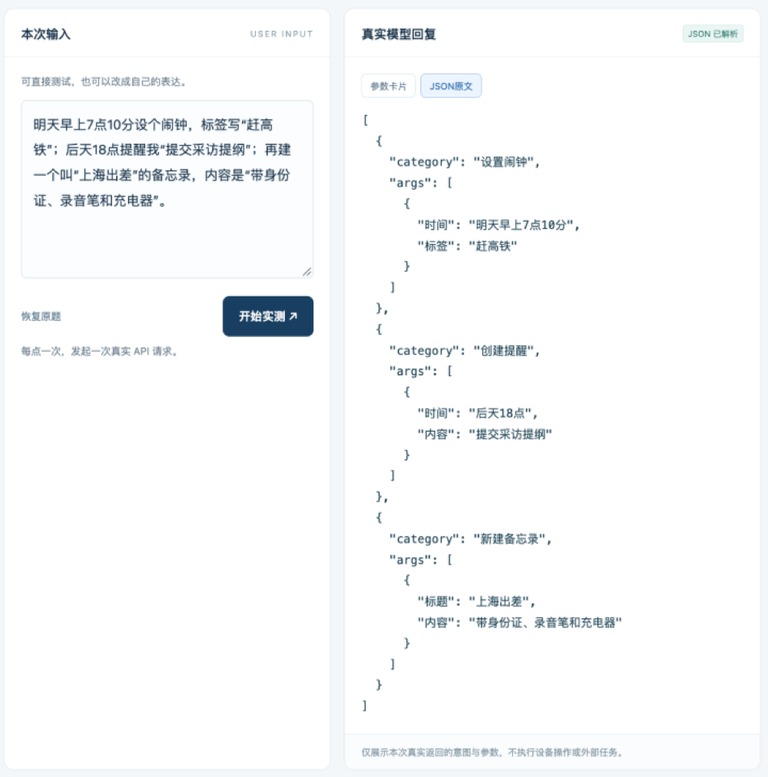
实测截图:闹钟和提醒和备忘同时认出。
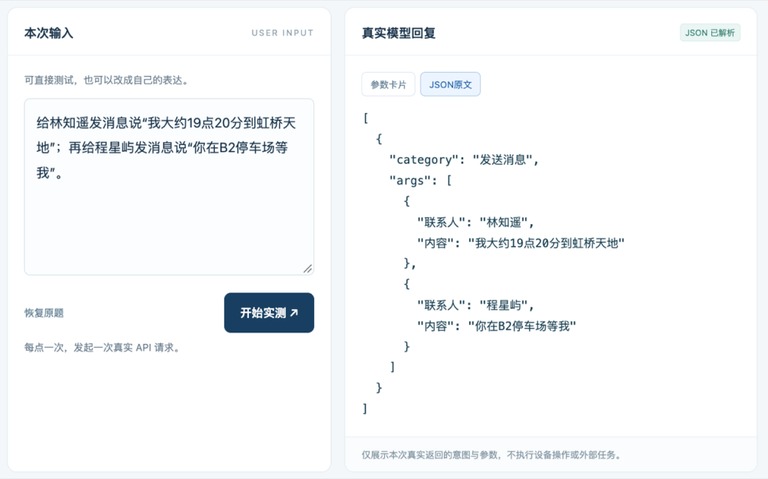
实测截图:两个联系人的消息没有串。
我们还埋了个容易翻车的场景。
备忘录正文里写着取消会议,再给人发消息。
它没有把正文当成新任务。
原话录进去了,一个动作没多做。
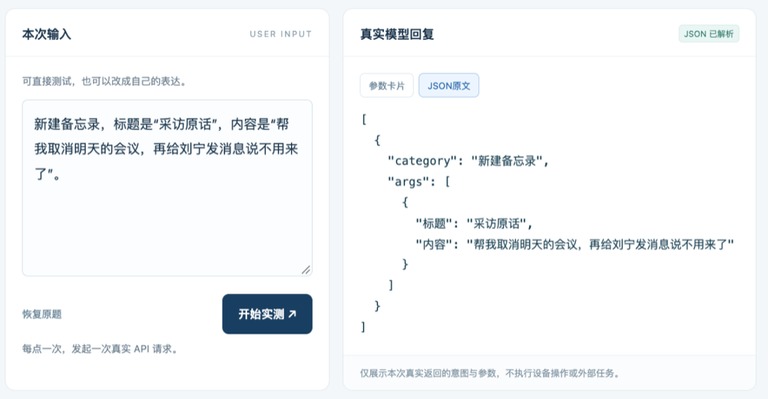
实测截图:正文是记录,没有被当成指令。
综合十一组,几个能力站住了。
多对象的参数绑定,多任务拆解,还有上下文理解。
共同点很清楚。
真要能用,得认准对象,抽对参数,守住边界。
支撑这些的是一套统一框架。
这套框架把四类任务放进同一个输出结构。
核心就两层,一个装类别,一个装参数。
工单场景里,参数装的是设备、故障,还有优先级和联系人。
项目场景里,装的是负责人和预算,再加上交付时间。
座舱场景里,装的是设备名和开度。
场景不同,结构是一个。
这就是它能从灯光跳到报销,再跳到会议的原因。
底层要解决的是同一件事。
把人话里的信息,映射到事先定好的字段上。
统一结构的意义在此。
模型输出和下游接口之间的格式差,被抹平了。
开源不只给了权重。
二百七十五万条语料,重构自六十一个公开数据集。
覆盖十九个领域,五十二种语言。
按规模算,这是眼下最大的开源意图理解语料库。
还有一份面向手机等终端交互的语料。
相关工作被 EMNLP 2026 收下了。
骨架是星辰 29B 底座,重点优化语义解析和结构化输出。
推理工具包和官方镜像也给齐了。
开发者能复现,能部署,能继续调。
急着上线的话,先挑一个场景试,别一次全铺开。
对做 AI编程 的人来说,这套东西省的是适配。
手机语音助手和座舱开发者,要把口语映射到设备参数。
客服和企业办公系统,要认意图,抽人和项目。
这些场景看着差得远。
对意图理解的要求却很像。
既要知道用户想干什么,也要把干这件事需要的信息交出去。
它选择把这块能力连同语料一起放开。
代码用宽松协议开源,镜像同步上架。
智能体的竞争越来越热闹。
比谁能干更多活,接更多应用。
但能力越丰富,底层语义理解的担子越重。
终端和企业应用里,每天产生海量简单却高频的交互。
每次都端上通用大模型,成本高,速度也慢。
成本这件事,在大规模部署里比分数更要紧。
一次判断花几分钱,一天跑一亿次就是另一回事。
把便宜任务挪给便宜模型,账才算得过来。
这给专用模型留了位置。
Jev 的走红,和这次开源,指向同一条路线。
高频明确的任务交给专用模型。
通用大模型把算力留给复杂的推理和规划。
对产业来说,这意味着更低的运行成本和更稳的交互。
往后智能体的竞争力,可能就藏在这些看不见的底层能力里。
