

循环架构最早只在语言上试。
参数不增加。
靠反复调用同一批层,把计算做深。这条路在纯文本上已经跑通。
现在它要开始看图。
图像里有文字,有物体,还有位置关系。
同一批参数被再次调用。
注意力会留在原处。
也会转到第一遍忽略的地方。
四家机构给了完整答案。
他们还顺手抓到一个反常现象。对做 AI工具 的人来说,这更值钱。
这事值得说清。
论文题图,四家机构联合署名。
论文已经公开。
代码和权重都放出来了。
模型名叫 LoopVL。
语言主干只有约 1B。
训练数据只要 0.14T 词元。
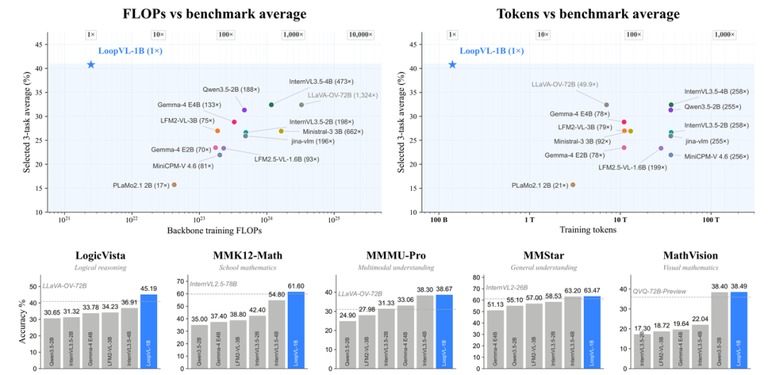
两条曲线,横轴是训练词元。
这个数字很反常。
同级别的模型用了 36T。
相差接近 260 倍。
数据少这么多,分数却没掉。在多项评测上还更高一点。数据效率这一项,它先站住了。
每一份数据都被用得更狠。横轴是词元,纵轴是评测均值。
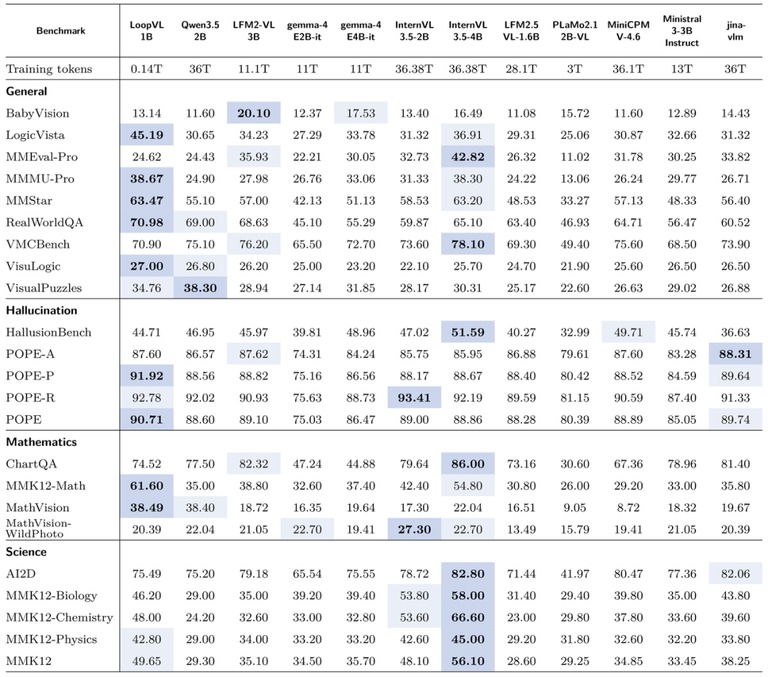
三个公开模型的横向对比。首行写着各自的训练词元。
只看榜单还不够。
不同来源的模型,配方各不相同。团队自己搭了三个非循环基线。
同样是 32 层。
一个往深处加,一个往宽处加。预算也是 0.14T 词元。
这样比才算公平。
八项受控评测,它赢下五项。
其中两项差距明显。
真实场景问答拿到 70.98。两个基线是 66.54 和 66.01。数学视觉拿到 38.49。
基线是 35.92 和 33.55。对做 AI对话 的产品,这条路有意义。分数放在那里,方向也就清楚了。
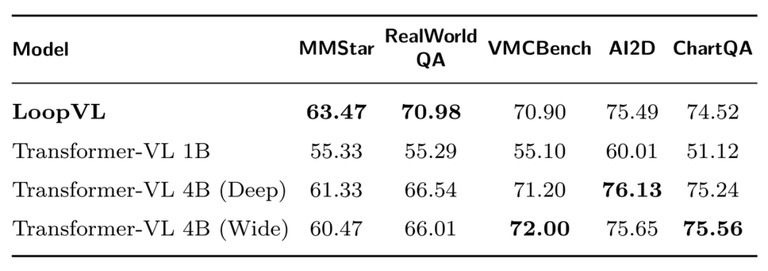
受控比较的截图,只截了几项。
有件事得先说清楚。
参数复用不等于省算力。
它和基线都是 32 套独立的层。层调用次数是 128 对 32。这不是同等开销下的较量。
它是拿更多计算换更多深度。
加深是把层数往上堆。
循环是同一批层反复用。
前者参数涨,后者不涨。
代价落在延迟上。
用户感受到的是等得更久。
划算不划算,得看任务。
短问答用不上 128 次调用。图省事就直接调闭源,别绕这条路。
长链条推理才吃这一套。
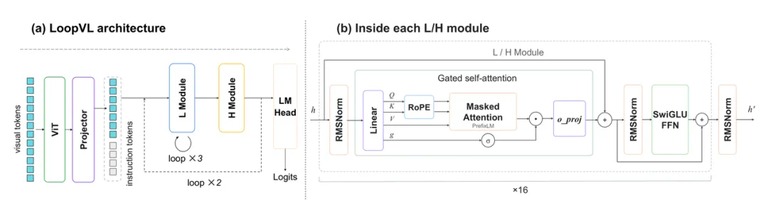
架构图,两段模块各管一段。
具体怎么排。
语言主干被切成两段。
L 段 16 层,H 段 16 层。默认配置下,L 连着跑三次。
然后跑一次 H。
整个过程重复两轮。
三连 L 加一次 H,再来一轮。32 套层,展开成 128 次调用。
图像只编码一次。
之后的循环都在更新同一个联合状态。前一轮的隐状态传给下一轮。最后由 H 的状态出结果。
AI编程 这类长链条任务,更需要反复计算。循环之间还分了两种层级。
一种是模块内部反复。
一种是整个周期再来一遍。两种叠起来,深度就上去了。
换调度就是换深度。
多跑一轮,深度多一层。
这个顺序训练时就定死了。
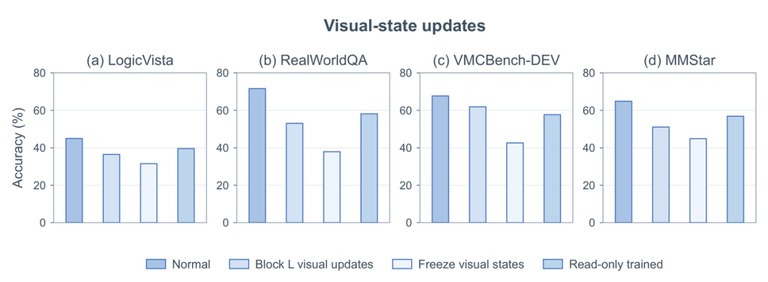
正常模型与三种视觉状态控制。那视觉状态改不改,重要吗。
团队做了两组干预。
第二轮直接掐断视觉更新的传递。或者把视觉状态整体冻住。
两种做法都掉分。
但推理时突然改规则,本身就不公平。所以他们又单独训了一个只读版本。第一轮允许更新,第二轮只读。
训练和推理用同一套规则。
视觉词元仍然能读。
非视觉状态照常更新。
结果正常版在四项评测里还是最高。
这个结论就硬了。
视觉状态不是固定的特征。
它跟着循环一起变。
改它,分数就掉。
不改它,循环等于白跑。
这组实验把话说死了。
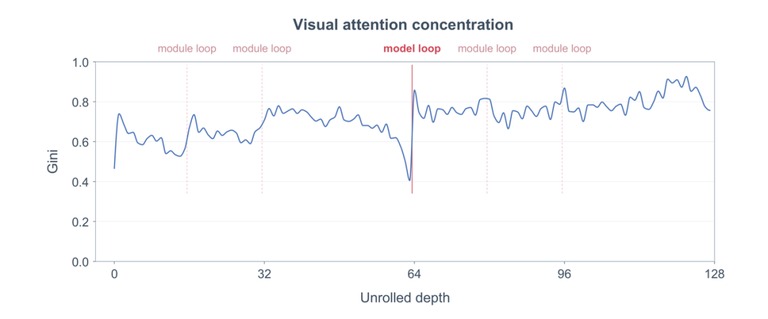
平均基尼系数轨迹,交界处陡升。
更反常的现象在这里。
团队在 128 次调用上记录注意力走向。
用两个指标看。
空间熵看注意力散不散。
基尼系数看权重偏不偏。
第 63 次到第 64 次之间。系数从 0.405 跳到 0.858。这一步正好是两轮循环的交界。
第一轮看得散。
第二轮开始盯着少数几块。换掉反向传播的设置,跳变还在。把视觉锚点和门控拆掉,它也在。
说明它不是实现细节的副产品。注意力变集中,只是换地方看。还不能说明找到了新证据。
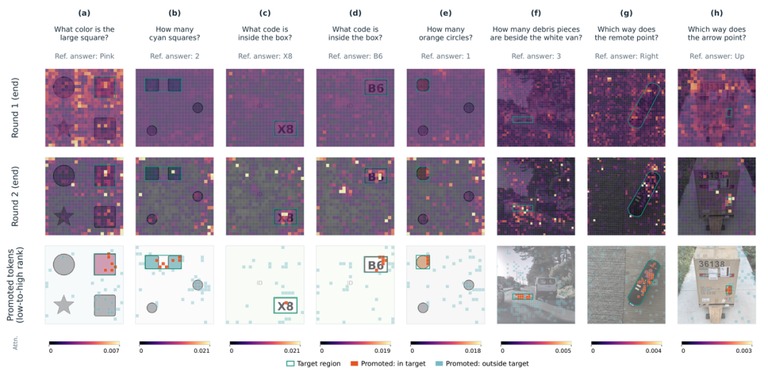
同一共享层的注意力重排。
更细的证据在后面。
团队比了两轮末端同一个共享层的分布。一些第一轮没被理会的词元。第二轮直接冲进前 25%。
颜色判断里有。
计数任务里有。
文字识别和方向判断里也有。
参数一个没换。
看的地方变了。
团队给它起了名字,叫视觉顿悟时刻。这句话可能是整篇最值钱的。不过循环也不是越多越好。
权重固定不动,只改推理调度。
把两轮改成三轮。
分数从 63.47 掉到 58.20。再加一轮,直接掉到 24.00。训练和推理的调度得对得上。
这也解释了为什么很多循环模型一加就崩。把这几组实验放在一起看。
线索指向同一个方向。
扩展能力不只取决于参数多少。
也取决于计算怎么组织。
更取决于前一轮的信息怎么用。对多模态智能体来说,这还有别的意味。
复杂任务里,它得一边看一边改对环境的理解。
先扫全局,再聚焦关键。
这种从粗到细的走法,正好是循环擅长的。所以方向可能不是把参数堆大。而是让模型自己决定看几遍。
哪一块值得再看。
什么时候够了该动手。
这三件事眼下都还没有答案。但至少有人把窗口打开了。过去调循环模型,多半靠试。
现在有了能看的指标。
空间熵和基尼系数,都能直接读。这比多跑几个榜单更接近机制。一项评测的分数,解释不了第二轮在看哪。
这项研究由人大高瓴人工智能学院牵头。百度、上海交大和清华也参与其中。还有一家 TierFlow 团队。
方向都是智能体效率,还有推理优化。代码和权重都已经放出来。
想复现的人不用等。
