

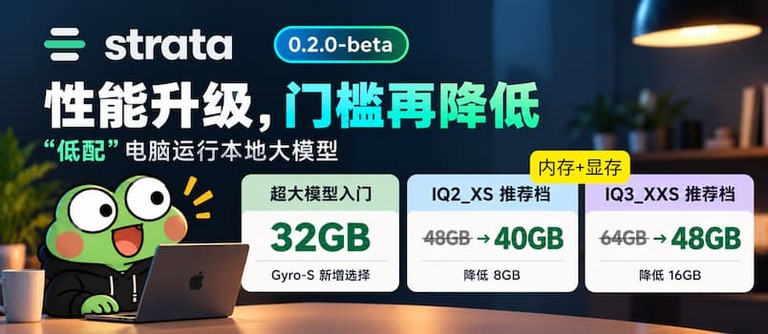
0.2.0 测试版的标题图,性能和门槛一起改了
Strata 是个开源项目
做的事很朴素
让家里的普通电脑跑得动本地大模型
它手里有几张现成的牌
Qwen3.8-Flash-Next
Qwen3.6-35B-A3B
速度据说还算顺畅
昨天它放出 0.2.0 测试版
改的方向只有一个
把门槛再压一档
官方给的最低配
内存加显存合计 27.6GB
就能把模型转起来
上一版的数字要难看些
32GB 只够 35B-A3B 的四位量化
48GB 才轮到更省内存的那档
64GB 才敢碰高压缩那档
同样的机器
这回能往上跳一档
另一个变化更直接
它终于有了独立图形界面
Windows 能装
macOS 和 Linux 也能装
下完点开就行
不用再敲命令行编译
装的时候带着向导
模型也由它先替你挑
以前卡在第一步的人
这次大概能过去
这类 AI工具 最怕卡在安装
它把这一步做掉了
Setup 界面,一分钟装完不用管理员
推理速度也动过
英伟达 30 系显卡
文本生成最高快 13%
3060 实测 10.2%
A4000 到 13%
AMD 的 RX 9000 系列
提示词处理接近翻倍
A750 的提示词处理快约 42%
首次启动的欢迎页,先挑一个模型
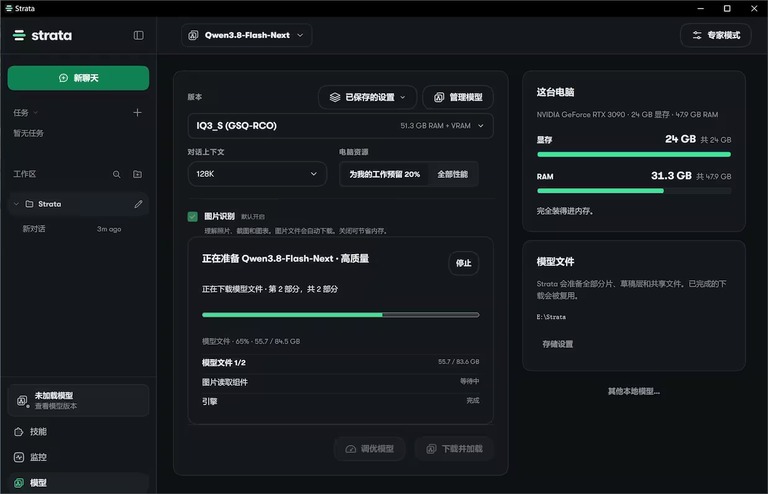
模型管理页,24GB 显存配 479GB 内存
它的口径是内存加显存
这点得说清楚
如果你手上是 12GB 显存的卡
内存再给 20GB 就够
27.6GB 这个下限也是这么算出来的
显存大的机器
内存可以省一点
反过来也一样
官网那张推荐表整个换了一版
改动的意思很直白
同样的卡
能跑更重的量化
32GB 这档
多了 Flash-Next 的 Gyro-S
这是个新面孔
40GB 这档
原本只能跑矮一档的量化
现在能上两比特那档
48GB 这档
原本要到 64GB 才给的档位
现在 48GB 就开了
64GB 这档
能跑 IQ3_S
96GB 以上那档
推荐还是 UD-IQ4_XS
四比特精度,基本没变
具体到模型上
35B-A3B 有三档
32GB 跑四比特那支
44GB 跑六比特那支
52GB 跑八比特那支
越往上精度越高
显卡够就往上挑一档
内存紧就守住原位
Flash-Next 的花样更多
32GB 是 Gyro-S
超低内存入门
质量会让一点
40GB 有三条路
Q2_0 偏重速度
Swift 1.5 的 IQ2_XS 是官方推荐
Gyro-M 省内存,跑起来可能慢
48GB 是 IQ3_XXS
64GB 能上 IQ3_S
还有一版省思考开销的
96GB 以上那档最接近原版
写这篇的青小蛙也在升级
他原来跑的是两比特那档
这回官方把推荐提了一级
结果卡在下载上
一句话,下不动
平时拿它做 AI对话
这类活儿现在本地就能干
不用联网,也不用付费
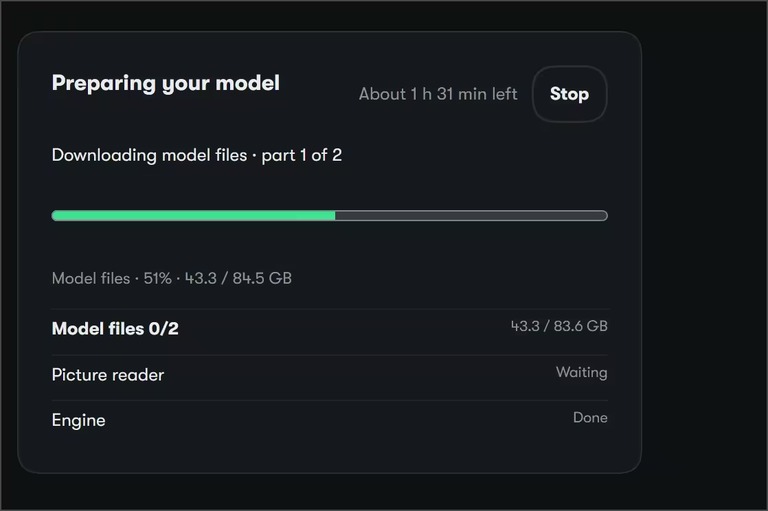
下载卡在 51%,还剩一小时半
所以速度这回没测成
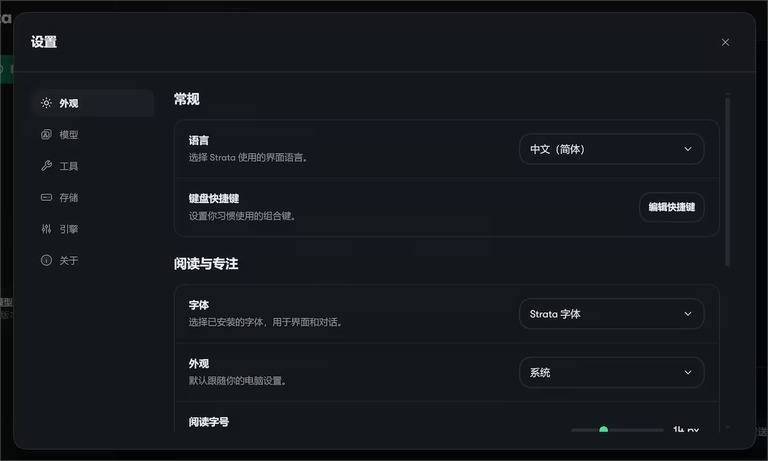
设置里已经能选中文简体
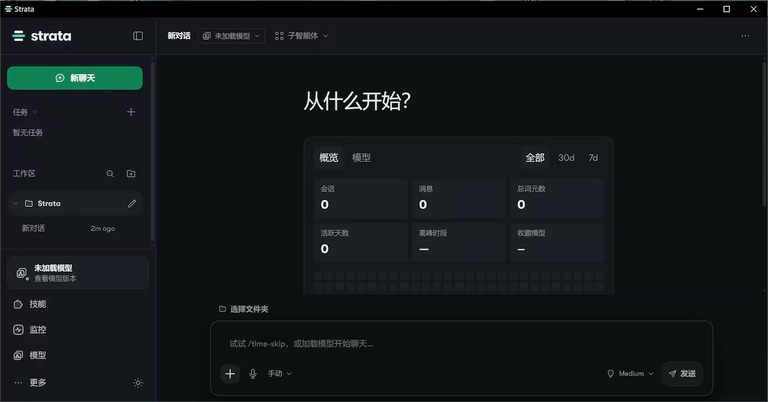
新对话页,可以直接挂上本地模型
其他升级还有几处
图形界面里塞了个 AI编程 助手
能读文件
能改文件
也能新建文件
还会联网找资料
任务可以交给它自己跑
两家主流显卡
现在默认支持图片理解
模型库更新也跟得上
新模型出来几天就能下
下载器也重写了
多连接并发
断点续传
下完还校验文件完整性
不过该慢还是慢
第一次跑要等模型解开
别急着关窗口
获取方式没变
还是去 GitHub 下
新装的人要注意
它默认装到 C 盘
这个不让改
数据盘倒是可以挪
老用户升级
体验上跟重装差不多
可以留着原来的模型
也可以趁这次换个更好的
最后补一句量化
大模型之所以大
是因为参数真的多
量化就是给它瘦身
用更少的空间存那些数字
两比特那档压得最狠
内存最省
质量也最将就
三比特那档松一点
质量好一截
同样是三比特
另一档保留的精度更多
这套格式按重要性分权重
名字里的数字
大致是每个权重占几位
后缀则是不同的配置
可以照图片压缩去理解
压得越狠
文件越小
细节丢得越多
普通人只记一条
在你内存撑得住的范围里
选最大的那个量化档
