大模型有个反直觉的地方。
它没有记忆。
这一轮说的话,下一轮就当没发生过。
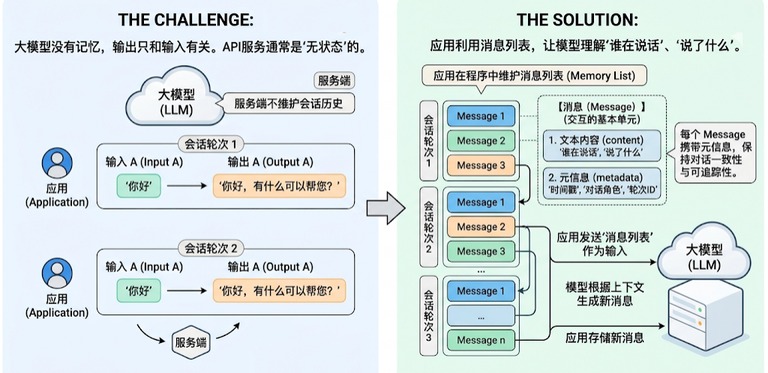
原因是它没有状态,输出只看这一次喂进去的内容。
很多接口也不在服务端替你保存会话历史。
想让它记住,只能在程序里自己维护一份消息列表。
消息是这套东西里最小的单元。
它既代表模型收到的输入,也代表模型给出的输出。
一轮对话,就是一条或多条消息拼出来的。
每条消息不只有文字,还带着一小包元信息。
这包信息记着谁在说话,也记着这话出在第几轮。
这套框架给了一套跨模型统一的消息标准。
换来换去,无论用哪家的模型,写法都不用大改。
格式自动对齐,换模型不用重写一遍。
加多模态内容或者自定义字段,都留了口子。
再往里拆,一条消息就三个字段。
角色,标明它是哪一类。
内容,也就是文字本身。
元数据,可选,装着编号和时间这些零碎。
按角色分,常用的消息有四种。
系统消息,开场就设定角色和行为边界。
用户消息,就是用户的一次输入。
助手消息,是模型给出的回复。
它可能只是文字。
也可能带着一串工具调用。
工具消息,专门用来回填工具跑出来的结果。
四种,各有各的用处。
自己动手做的AI工具,多半绕不开这一层。
写法上有两种。
先看字典那种。
系统消息写成一段带角色的内容。
用户和助手同理,只把角色字段换个值。
工具消息要多挂一个调用编号。
整份写成列表直接喂进去,就能拿到回复。
另一种写法用对象。
大项目里更常见。
系统消息换成对应类的构造。
用户和助手各有自己的类,工具也有。
差别只在括号里的参数,语义和字典完全一样。
好处是字段有约束,写错在编辑阶段就能看见。
工具消息这里有一条硬要求。
它的调用编号,必须和上一条助手消息里的对得上。
对不上,模型就接不住这条结果。
把两种写法摆在一起,配对关系就清楚了。
四个角色各配一对写法,一个也不落。
用途也分明,有的设定行为,有的装用户输入,有的装模型回复,还有一个装工具结果。
接下来逐个说字段。
系统消息最省事,内容只有一个参数。
参数名可以直接省掉,只写内容那一段。
用户消息也一样,内容字段名可以省。
它多出来的是元数据那一块。
比如给消息加个名字,或者加个编号。
同一种消息出现多条时,就靠这些字段区分。
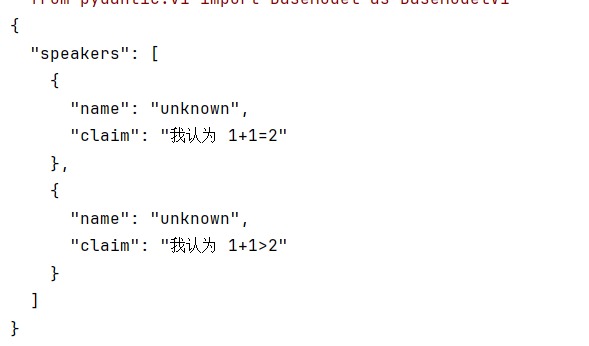
但不是所有模型都认这套。
支不支持,要看模型供应商怎么讲。
有的接口写着支持名字字段,实测却读不出来。
换另一家中转服务试,名字直接变成了未知。
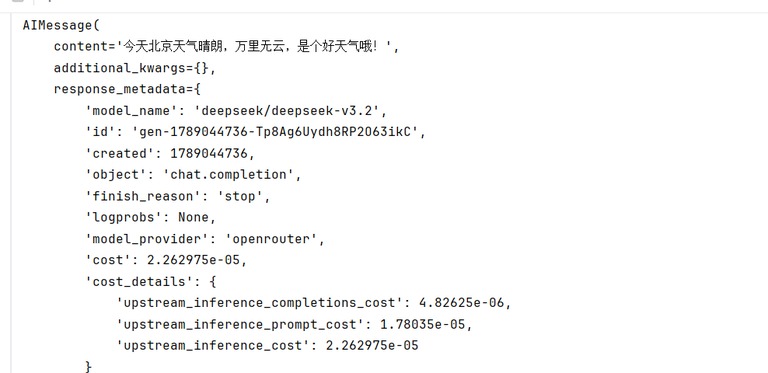
助手消息身上的东西最多。
内容之外,它的响应里还挂着一包元数据。
不同模型给的东西不一样,常带这一次任务的用量。
还有一个工具调用字段。
模型决定调工具时,这个字段里就会排出一串调用。
没调工具,它就是空的。
每一笔调用是一个小字典,三个关键字段。
工具名,说明要调哪一个。
参数,把这一次要用到的输入装进去。
示例里那个查天气的工具,参数写的就是城市名。
编号,这笔记调用的唯一标识。
一条助手消息里可以同时排好几笔。
既要查天气,又要拉新闻,就排两条。
编号就是那把钥匙,结果回来得早或晚,都靠它对上号。
还有一点容易忽略。
模型决定调用工具时,文字内容往往是空的。
真正有事的那部分,全挤在调用字段里。
供应商返回的元数据也不一样,有的给模型名和结束原因,有的连调用费用都替你算好。
用量那一块通常有三个数。
输入和输出各用了多少词元,加起来又是多少。
三个数摆在一起,成本就能直接算。
偶尔还会冒出一个不合规调用的字段。
那说明模型拼出来的参数有问题,得回头改工具的描述。
工具消息这边,核心参数也是三个。
内容装工具的输出,名字写工具名。
调用编号必须和助手消息里那笔完全一致。
顺序上也有讲究。
工具消息要紧挨着匹配它的那条助手消息。
模型是按顺序往下读的,一个结果落在它的调用之前,模型会当成没发生过。
四个角色里,只有这一对是靠编号绑在一起的。
其余三个各说各话,互不依赖。
日常AI编程里,这几行几乎是标配。
回到最开始那个问题。
做AI对话应用,多轮上文怎么记住是一道必答题。
最笨也最直接的办法,是每一轮都把完整历史传一遍。
第一轮,前面只有系统消息和用户那一句。
第二轮,前面三条都留着,再加一轮新的问答。
第三轮再往上摞,越摞越长。
这里有一条容易踩的线。
每次都要往原来那份列表里追加,不能新建。
别图省事每轮重建列表,上文会当场断掉。
有人第二轮直接开了个新列表。
结果模型当场失忆,连上一句问过什么都答不上来。
还有一种错,是忘了把模型的回复存回去。
下一轮再问,模型自然接不上自己刚说过的话。
历史越摞越长,开销也跟着涨。
词元按量计费,长对话的成本会肉眼可见地爬。
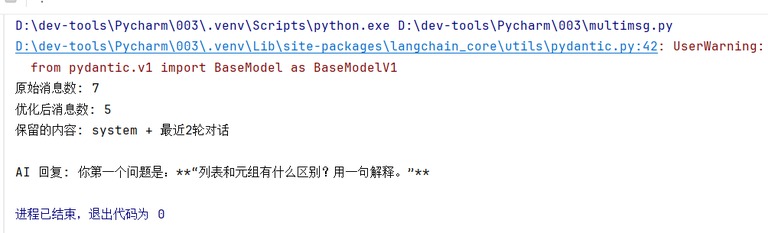
一个实用的收口办法,是只留最近几轮。
系统消息永远留着,它定义角色,不能丢。
更早的对话直接扔掉,只保留最近若干轮。
写成一个函数,之后按需调用。
这样每轮带上去的历史都是短而新的。
模型既知道当前在聊什么,也不会把账算爆。
保留几轮没有标准答案。
三五轮是常见的起点。
宁愿多留一轮,也别让模型接不上话。
任务复杂就再往上加。
还有一种做法是把旧历史压成摘要。
摘要省地方。
代价是细节会丢,取舍要看场景。
有些框架已经把这段逻辑封装好了。
也可以自己写。
几十行就够。
内容字段本身还有一层讲究。
它是弱类型的,字符串和列表都能装。
列表里每一项通常还是一段小字典。
图片和文字可以混在同一条消息里。
纯文字直接给字符串,参数名可以省。
要多模态,就把内容写成一段段字典。
两种形态,按需要挑一种。
四种消息摆在一起,多轮对话的骨架就清楚了。