大模型有个反直觉的地方。
它没有记忆。
这一轮说的话,下一轮就当没发生过。
原因是它没有状态,输出只看这一次喂进去的内容。
很多接口也不在服务端替你保存会话历史。
想让它记住,只能在程序里自己维护一份消息列表。
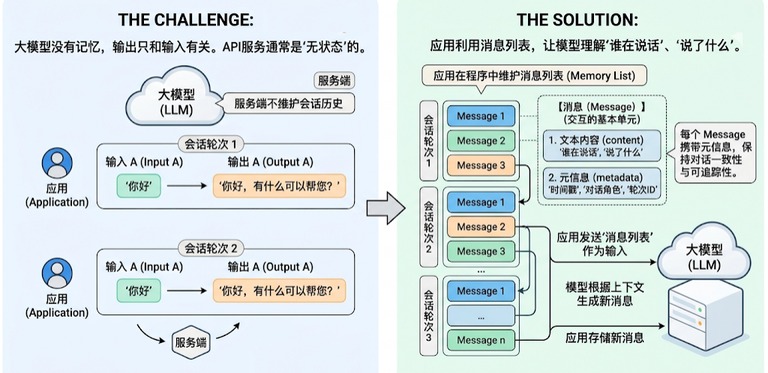
消息是这套东西里最小的单元。
它既代表模型收到的输入,也代表模型给出的输出。
一轮对话[……]
Cursor 登录助手 · 一键汉化 · Cursor账号批发 · 一站式服务商
大模型有个反直觉的地方。
它没有记忆。
这一轮说的话,下一轮就当没发生过。
原因是它没有状态,输出只看这一次喂进去的内容。
很多接口也不在服务端替你保存会话历史。
想让它记住,只能在程序里自己维护一份消息列表。
消息是这套东西里最小的单元。
它既代表模型收到的输入,也代表模型给出的输出。
一轮对话[……]
一九一八年夏天,奥地利炮兵军官维特根斯坦在意大利前线的炮火间隙里写完一部小书。手稿塞进背包,跟着他转移阵地。那年冬天他被俘,关进战俘营。多亏英国经济学家凯恩斯的斡旋,手稿才寄到罗素手里。
他留下一句话。这些问题,已在一切本质方面获得解决。
书名叫《逻辑哲学论》。写完它,他放弃了一大笔遗产,跑到奥地利[……]
这两天 AI 圈最扎眼的不是又发了什么新模型,是几家头部公司一块儿踩了刹车。OpenAI 的奥尔特曼、Anthropic 的达里奥,还有马斯克,先后出来讲话。意思都差不多,AI 的研发节奏,得管一管了。我正琢磨这事的时候刷到一条视频,晓辉博士讲的,十几分钟,把来龙去脉捋了一遍。我把它拆成几件事,一件[……]
DeepSeek 的 flash 系列把价目表换了,官方用量页面已经挂出通知。
改动不复杂,就是把一天切成两段计价,空闲时段一个价,高峰时段是空闲时段的两倍。
对按量付费的项目来说,同样的活现在有了两种成本。以前一次批量任务在什么时间发出去,影响的只是什么时候拿到结果,现在还要影响花掉多少钱。接口调[……]
Anthropic 的新旗舰 Claude Fable 5.1 在9月初发布,一同出来的还有受限版 Mythos 5.1。官方说明里两个版本是同一个模型,差别只在安全防护级别。Fable 5.1 全平台开放,Claude.ai、Claude Code、API 和各家云上都能用。Mythos 5.1[……]
Gemini Flash 系列的更新比之前密了不少。3.8 这版是 9 月 2 日发的,跟上一版 3.7 Flash 只隔三周,六周里已经是第三个版本。同一天还多了一个网络安全版,叫 3.8 Flash Cyber。
主版本的能力定位在推理和编码上,接的活偏长周期软件工程和自主智能体。长程软件工程[……]
8 月底,韩国科学技术信息通信部把“全民人工智能”方案正式敲定,向全国国民免费提供生成式 AI,不设次数上限,也不设 Token 限制。
消息传出来的时候,我第一反应是“公共服务”这个词的边界又被往外推了一步。水电之后,AI 也要变成国家基础设施了。
按照方案,9 月开启公测,年底前实现全民覆盖。牵[……]