

10 月 17 日这天,DeepSeek 的智能体栈三层各挪了一格。
底下是模型。
中间是那层官方壳。
上面是搜索接口。
三处同一天改完。账单的样子也跟着变了。
没有发布会。也没有预热。
改动都写在仓库和文档里。
一、三层各动了一格
模型层动得最早。
北京时间上午十点四十,开源仓库里多了一个新仓库。
名字很长,DeepSeek-V4.1-Flash-1017。
协议用的是 MIT。权重直接放出来,谁都能拉。
调用方一行代码不用改,模型名还是原来那个。
旧名字也还认。只是背后那个模型已经退役。
请求落到新仓库上。按 Flash 的价格收钱。
壳层在同一天连发两个候选版。
下午一点二十二一个,四点十六一个。
第二个版本的更新说明只有两条。
一条是适配新模型。
另一条是接上搜索与抓取接口,在网页搜索设置里打开就行。
检索层最实在。直接公布了价格。
搜索和抓取两个接口,各按每一千次成功请求 0.75 美元。
眼下走壳和 Claude Code 的服务端调用还免费。
北京时间 11 月 1 日零点起开始收。
严格说这不是一次新模型发布。
架构早就在。1017 只是刷新档。
但三层放在同一条时间线上看,形状就出来了。
权重和价目表一起动,壳也跟着换,这在它的历史里不多见。
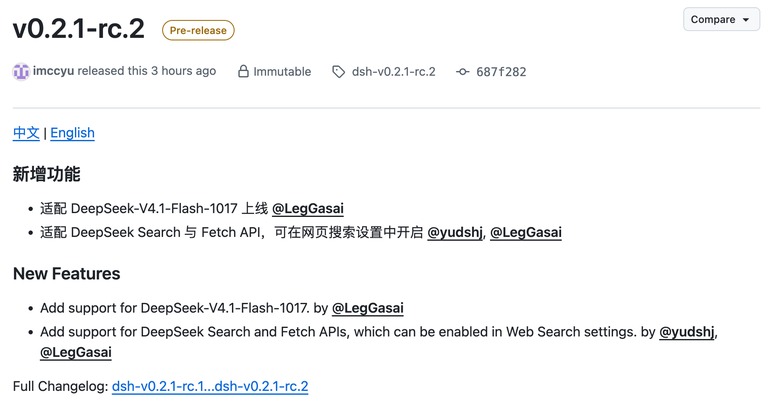
0.2.1-rc.2 的更新说明里,新增一行 Search and Fetch 适配。
二、跑分:涨得最狠的是智能体任务
官方模型卡给了十一项基准的新旧对照,另加四个对照模型。
看数字之前,先看清结构。
四个对照模型来自另外三家。
表是模型卡自己发的,口径按官方注释。
终端任务那项从 31.2 到 42.3,多了 11.1。
程序基准从 20.3 到 29.1,多了 8.8。
最难的那套考题从 64.6 到 72.1,多了 7.5。
三处都在智能体和AI编程上。
这也解释了官方为什么只承诺更快和更便宜。
但换个对手看,它并不是全面领先。
人类最后考试那项 42.6 对 56.3,落后一大截。
终端任务 42.3 对 51.8,也没追上。
程序基准 29.1 对 37.0,差得更明显。
代码仓库那项 68.2 对 75.3,同样在后面。
两项带工具的视觉基准,也都差一个身位。
真正反超的是四张牌。
软件工程基准 77.0 对 74.0。
自动化基准 60.5 对 50.3。
智能体长考题 35.4 对 28.6。
前面那套最难考题 72.1 对 65.8。
有件事得记住。
表里的数字都是「模型 + 壳」的组合成绩。
同一个模型换个壳跑。数字会动。
终端任务用的是别人家的壳,软件工程基准用的是轻量壳。
所以看这种榜单,得连壳一起看。
官方注释特意标出壳,就是这个道理。
它的强项也集中在长流程任务上。
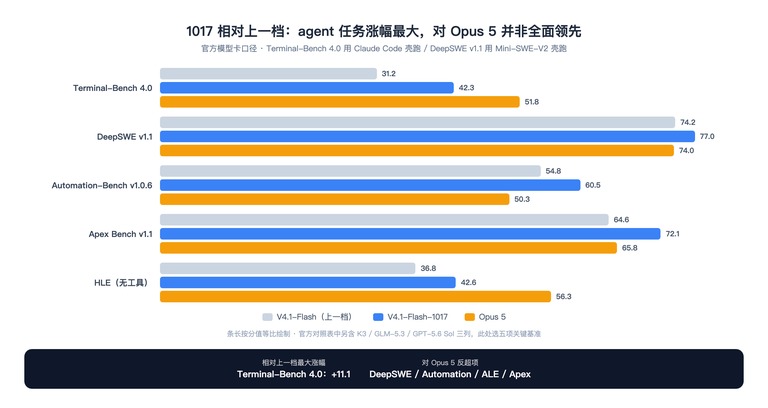
模型卡配图,Terminal-Bench 4.0 从 31.2 起跳,agent 任务涨幅最显眼。
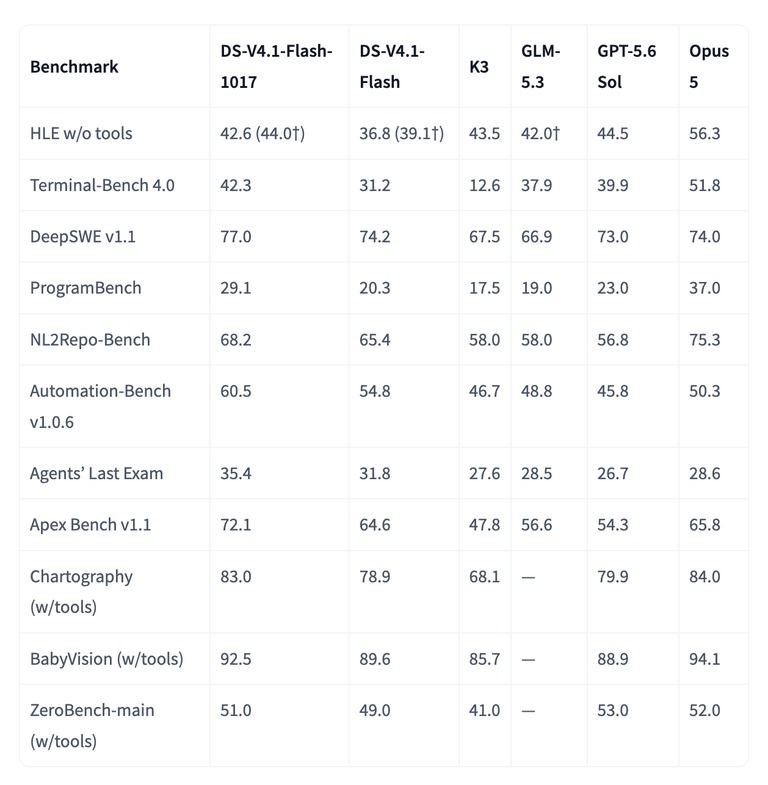
官方模型卡的全表,HLE 与 DeepSWE v1.1 都在列。
三、缓存压到 890 字节一个词元
技术报告同天挂在模型仓库里,五十一页。
标题把主线挑明了。就是要把缓存压到极限。
模型本体是 552B 主干加 196B 的混合专家部分。
上下文给到一百万词元。
最有意思的是激活量的不对称。
读入每个词元只激活 8B,生成时激活 16B。
这个不对称是照着智能体的负载形状设计的。
一个任务跑下来。词元大头花在读网页和读文件上。
输出反而短。
读入便宜。生成正常。长上下文才划得来。
靠四件事叠乘。
第一件是因果编码器与解码器。
下半层照常逐层算,上半层的缓存不再层层生成。
直接从中间那层投影出来,读入的计算量几乎砍半。
代价是滑窗缓存还得逐层留,第四件事专门处理它。
第二件是压缩稀疏注意力。
它把层间复用做成三种静态模式。
有的层自己生成缓存和索引。
有的层复用上一层的缓存,只重算索引。
多数层干脆连索引一起复用。
读入只用十五个算子,生成用十一个。
第三件是四位量化。
主缓存用标准的四位浮点格式,每个通道配一个缩放系数。
旋转位置编码之后再量化,比上一代的八位又省近一半。
滑窗那部分敏感,仍然留在八位。
第四件最巧。
上一代部署里,滑窗缓存占了持久缓存近一半容量。
但复用只发生在会话活跃的那几分钟,之后就是死数据。
这一代干脆不再持久化滑窗缓存。
改放进每台机器划出的一成主存组成的池子,存活时间只留几分钟。
真缺了只重放窗口里那几段。
结果是串数字。
常驻显存的那部分,压到每个词元 890 字节。
是上一代的约四分之一。
跟第一代比。差出四百多倍。
加上持久缓存不再存滑窗部分,持久足迹降到上一代的约八分之一。
按这个数折算。一百万词元上下文的常驻缓存只要 0.89 GB。
预训练用了 45T 词元的多模态语料。
稀疏注意力从六万四千的序列长度起就从头训练。
另外还带一个专门的投机解码模块。
三个变压器块,滑窗一百二十八,一次出五个草稿位。
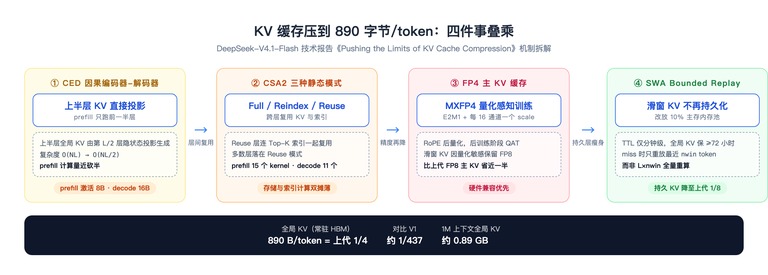
机制图里写着 890 字节/token,四件事叠乘,CED 与 CSA2 排在最前。
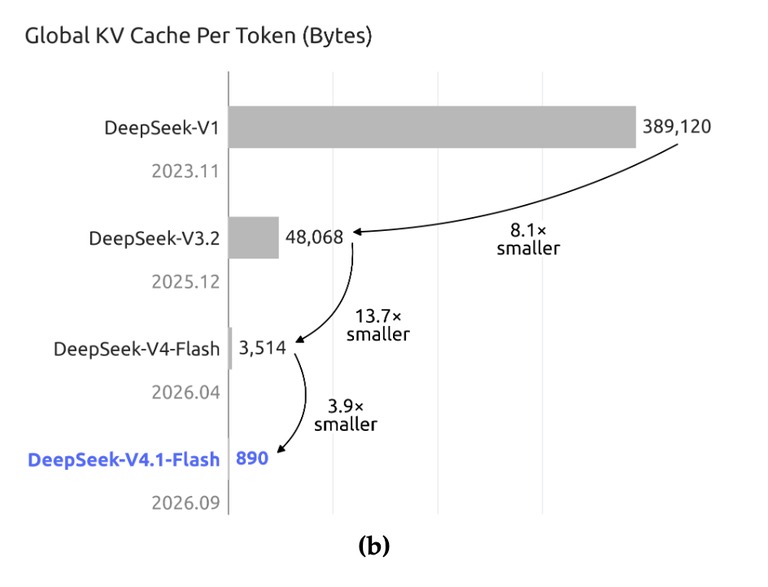
同一张图的纵轴是每 token 字节数,从 389,120 降到 890。
四、另一篇论文提醒:搬远可能比重算还慢
10 月 15 日还有一篇论文,值得并排读。
它测的是另一条路。
缓存不压缩,放进远端共享层,让多个推理引擎集中复用。
配置是 GLM-5.3 在八张 B300 上做前缀并行。
那是八位浮点的混合专家,用的是多头潜在注意力。
这条路的诱惑很直接,一份缓存多处复用,谁也不必重复算。
测试的场景是多个请求共享同一段上下文。
远端层只对长提示有意义。
短提示搬一趟,光固定开销就不划算。
结果是一盆冷水。
开了远端层。中位首字延迟没变。
但一万六千词元的请求,长尾延迟从 3.96 秒涨到 17.3 秒。
在缓存命中密集的流量上做同步加载,长尾直接飙到 83.32 秒。
所谓同步加载,就是请求先停下等缓存回传,然后才开算。
而显卡忙碌率只有百分之七。
瓶颈根本不在算力,在等缓存从远端搬回来。
论文还给了一笔能算的账。
它把命中拆成两笔成本,一笔是带宽,一笔是每次都要付的固定开销。
远端命中要划算,缓存的带宽必须过一道门槛,这套配置下约 2.53 GB/s。
再加上每次命中约 0.33 秒的固定开销。
结论很清楚,约一万七千词元以下的提示,带宽再高都不如就地重算。
作者随后做了按秩分片和异步加载,把带宽又抬了一档。
但门槛还在那儿。
两条路线摆在一起。正好构成对照。
一边是把缓存压小,小到不值得搬。
另一边是把缓存搬远,集中换复用。
同一个问题。两个答案。
一个动模型架构。一个动部署架构。
一个管显存里能放多少,一个管多台机器之间怎么借。
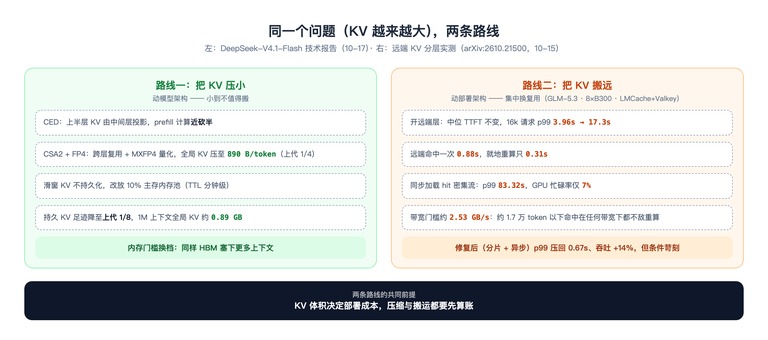
左右分栏图,路线一压小,路线二搬远,右边挂着 GLM-5.3 与 LMCache。
五、计费对象换了:从词元到「次」
模型的价目表结构没变,还是按词元。
错峰时段每个百万输入,缓存命中 0.003 美元,未命中 0.15 美元。
输出 0.6 美元。
高峰时段翻倍。
而高峰只有工作日两个窗口,上午九点到十二点,下午两点到六点。
周末和节假日全天错峰。
新东西在检索接口。
搜索和抓取从工具调用里独立出来,单独立价。
各按每一千次成功请求 0.75 美元,摊到单次约人民币半分钱。
生效节奏是先给一段免费过渡期。
官方的壳也在名单里。没有例外。
这件事的分量不在钱数,在计费对象。
过去模型公司只卖词元,检索要么白送,要么藏进词元价格里。
现在检索被拆成独立的一项,按调用次数计价。
智能体栈的每一层。第一次都有了明码标价。
一个动辄跑成百上千步的任务,成本模型里从此多一项步数乘以检索单价。
平时开着的AI对话窗口,背后其实是这两本账在同时走。
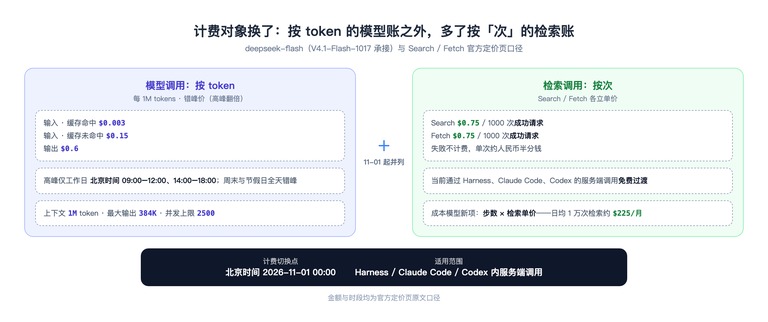
计费对照图,模型调用按 token,检索调用按次,两本账分开记。
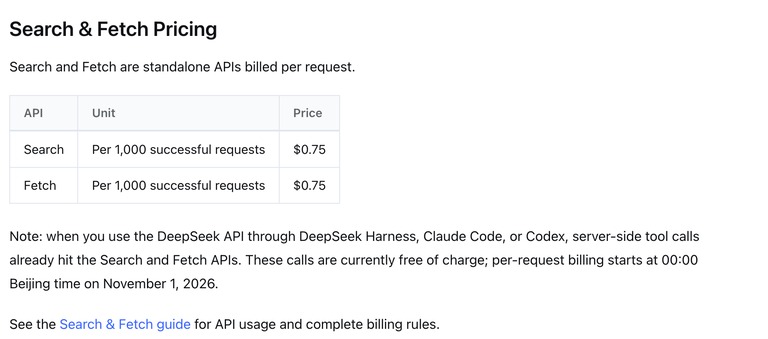
定价页原文,Search and Fetch 按每 1000 次成功请求计费,11 月 1 日生效。
六、落到用这些工具的人身上
第一,11 月 1 日前查一遍自己的链路。
只要智能体走它的接口又开了服务端搜索,账单下个月就多一项。
高频任务先估步数。别等账单到了再看。
第二,权重已经能自己拉。
890 字节的缓存足迹,意味着长上下文服务的内存门槛换了一档。
第三,把缓存和计费两条线一起盯。
同一天里,一篇论文证明缓存搬远有门槛,一家厂商压到 890 字节还开始按次收费。
做AI工具的人最容易忽略这一点。
长上下文的成本构成正在被重新划分。
模型架构吃一块。服务接口吃另一块。
Claude Code会员中转站 微信:douhanq
