一个智能体干一件事很在行。
干好几件事,它就吃力了。
不是模型不够聪明。
是任务本身就不适合塞进一个脑子。
先看一个真实场景。
你要做一套竞品技术报告的自动生成系统。
用户丢进一个产品名,系统要吐出一份完整调研。
里面有功能拆解,有技术栈推断,还有定价对比和优劣势分析。
如果全交给一个智能体,它会犯糊涂。
调研网络资料留下的噪声,会污染写报告的判断。
它还得同时扮演技术侦查员、定价分析师和报告写手。
角色一开始就打架。
系统提示词越写越长,越写越互相矛盾。
更麻烦的是定位失败。
一个三分钟的任务中途报错,你分不清是检索挂了,还是分析错了,还是输出格式不对。
同一套技术栈推断的逻辑,下次别的产品也要用,却抽不出来单独复用。
多智能体协作要解决的,就是这件事。
让每个智能体只做它最擅长的一环,再用一层编排把它们串起来。
那什么时候才该上多智能体。
有几个信号可以对照。
一是单个提示词开始互相牵制,加一句就顶掉另一句。
二是某一环的工具越挂越多,模型开始选错。
三是你想单独重跑某一环,却发现整条链子绑死了。
四是不同环节其实更适合不同的模型。
中了两条以上,就该考虑拆了。
市面上的协作范式大致四类。
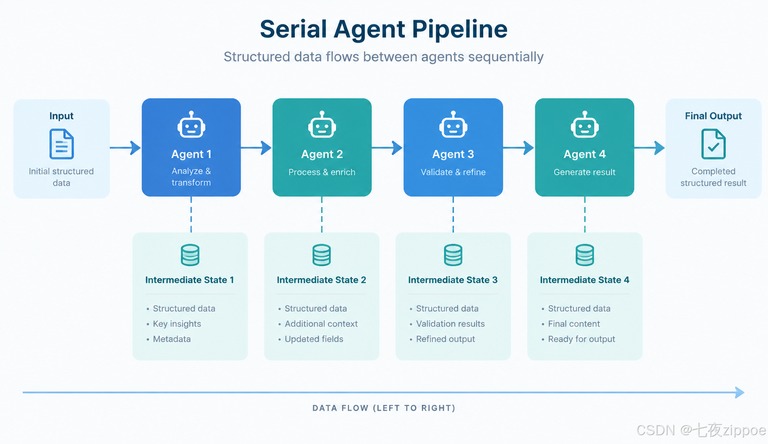
第一类串行流水线,前一环的输出正好是后一环的输入,适合有先后依赖的线性流程。
第二类并行扇出,任务拆给多个智能体同时做,最后再汇总。
第三类主管调度,由一个主管智能体决定把活派给谁。
第四类共享黑板,所有智能体读写同一块公共区域。
后面三类,本质上都是在串行之上加并行、加调度。
把串行吃透,等于拿到了理解多智能体协作的钥匙。
这里有个反直觉的点。
把任务拆细、拆多,反而更快更稳。
流水线在工业界统治了一百多年,靠的就是把复杂过程切成一道道工序。
每一道都有人专管,也都能单独优化。
智能体的流水线,是一个道理。
要落地,先记住三个核心件。
任务分解,串行编排,还有中间态传递。
三件事里,任务分解最容易被想歪。
有人分得太粗,一句分析报告就完事。
有人分得太细,连调一次接口都单列成一个环节。
宁可先拆细一点,也别让一个提示词同时管三件事。
一个实用的判据是,这一环需不需要独立的角色设定,或者独立的工具集。
把候选环节的系统提示词分别写出来。
如果两环的提示词高度雷同,工具集也一模一样,它们大概率该合并。
反过来,某一环的提示词明显膨胀,就说明它还该继续拆。
经验上,单环的系统提示词控制在 100 到 300 字,工具集 2 到 5 个,是比较健康的区间。
分解还有一层容易漏的事,输入输出要对齐。
上一环产出的结构,必须和下一环期望的输入结构对得上。
这就是中间态这份契约要解决的问题。
第二件是串行编排。
它管的是环节之间怎么驱动,怎么把异常分流。
编排层是流水线的骨架。
好的编排层,让业务逻辑和流程控制彻底分开。
智能体内部怎么想,它不关心。
它只关心调用顺序,数据流转,还有异常走向。
它通常要支持三种基本动作。
顺序执行,前序没做完,后续不许启动。
条件分支,按中间态的值决定往哪走。
循环重试,环节失败或者质检没过,就再来一遍。
不管用现成的图编排框架,还是自己写,这三样都缺不得。
第三件是中间态传递。
中间态,是前一个智能体交给下一个的结构化数据。
很多人偷懒,把整段 AI对话 历史原样传下去。
这会白白烧词元,也没法校验。
换成结构化中间态,只传提炼后的结论,好处立刻显现。
一是省,每一环只带必要字段,上下文窗口不用被塞满。
二是稳,中间态有明确的字段结构,可以校验,可以回看,可以回滚。
还有一条纪律,中间态最好做成不可修改的快照。
每一环产出一份新的,而不是就地改旧的。
这样你才追得到,到底是谁改坏了哪一段。
概念讲完,动手搭一遍。
我们做一条三环节的流水线。
把采集和分析还有写报告串起来。
第一环去把原始资料抓回来。
第二环负责去重清洗和要点提炼。
第三环把要点写成一份报告。
这套思路在 AI编程 场景里尤其常见。
很多团队用它把几个 AI工具 串成一条线。
第一步,先把中间态定义成带校验的数据类。
字段名和类型都写清楚,谁也不能乱塞。
第二步,把每一环各写成一个函数。
输入上一环的中间态,再输出下一环要的中间态。
第三步,用一张图把三环连起来,再给它加上失败重试。
跑起来之后,每一步的中间态都能单独打出来看。
哪一环掉链子,一眼就能看出来。
搭流水线不止一条路,常见的有三种做法。
图编排框架,适合环节多、要条件分支和回滚的复杂流程,代价是学习成本。
自研轻量编排,控制力最强,但要不要自研,得看流程复杂度够不够。
还有一种更省事的做法,用管道符把几环直接串起来。

这种写法语法极简,一行就能串起一条简单链路。
代价是它撑不起复杂的条件分支,环节一多就容易失控。
所以选型没有标准答案,只看你的流程长什么样。
流水线能跑只是开始。
要上生产,还得补几块拼图。
第一块是校验。
在关键环节之间插一个校验器,用规则或者一个轻量模型,检查中间态的成色。
要点太少,缺证据,置信度太低,都直接拦下来。
拦下之后走条件分支,退回上一环重跑。
重试超过上限,就转降级兜底。
校验的价值,是把质量问题从隐性腐烂变成显性可拦截。
第二块是测试。
用假的模型跑逻辑测试,用真的模型跑集成测试。
编排逻辑不用每次都烧钱去调真模型。
第三块是观测。
每一步的输入输出都留一份记录。
出了事,能顺着记录回放,而不是靠猜。
第四块是解耦。
把调用模型的那一层单独抽出来。
哪天想换个模型,只改一处,编排代码一行不动。
还有三个典型陷阱,几乎人人都踩。
一是中间态污染下游。
上一环带着噪声往下传,下一环就被带偏。
二是错误像多米诺骨牌一样传播。
某一环的细微差错,到最后一环会被放大成完全跑偏的结论。
三是词元开销失控。
每一跳都重放全部历史,成本会跟着环数线性膨胀。
解法都指向同一件事,坚持显式中间态,把噪声挡在源头。
最后划一下适用范围。
天然线性、有先后依赖的流程,最适合流水线。
环节职责清晰、彼此不用来回协商的,也适合。
需要反复回环协商,或者子任务本来就能并行的,就别硬套。
一个环节就能搞定的短任务,硬拆只会变成过度设计。
说到底,多智能体协作难的不在模型,而在编排。
把任务拆干净,把中间态管住,再把异常接住。
一条流水线,就能稳稳跑起来。