辛顿发了新论文。
这次他不谈模型分数。
谈的是一个更老、也更吓人的话题。
AI 开始参与造下一代 AI。
一轮一轮滚下去,会不会滚出一条智能爆炸曲线。
论文的名字很长。
大意是,如果 AI 研发全自动化,会不会触发智能爆炸。
作者名单分量很足。
二十二位作者里,两位教父级人物都在。
还有强化学习的老前辈,和一家头部实验室的首席科学家。


论文先把几条判断摆了出来。
一旦 AI 能完整参与造下一代 AI,递归自我改进就可能真的闭环。
越过某个临界点,几年才能完成的进步,可能被压到几个月。
实验室的研发队伍,理论上能从几千人跳到几百万人。
今天一年走完的路,极端情况下,未来大概只要五周。
结论听着像科幻。
但论文说,苗头已经露出来了。
这类 AI工具 早就不再是实验室里的玩具。
智能爆炸这个词不算新。
1965 年,数学家古德就设想过一台超智能机器。
如果机器比人更会设计机器。
它就能接着设计出更聪明的版本。
新版本再参与下一轮改进,一圈一圈转下去。
古德的判断很简单。
只要改进机器这件事本身能被机器越做越好。
能力增长就会反过来给能力增长加速。
这套设想,就是智能爆炸最早的理论源头。
到了今天,讨论的重点变了。
大家不再只问,AI 能不能自己改代码、调参数。
更现实的问题是。
它能不能进入研发下一代 AI 的整套流程。
并且让这套流程自己越来越快。
辛顿这些人在论文里给了一个判断。
AI 已经真正走进研发流水线。
而且速度快得有点反常。

支撑这个判断的,是几家头部实验室的内部数据。
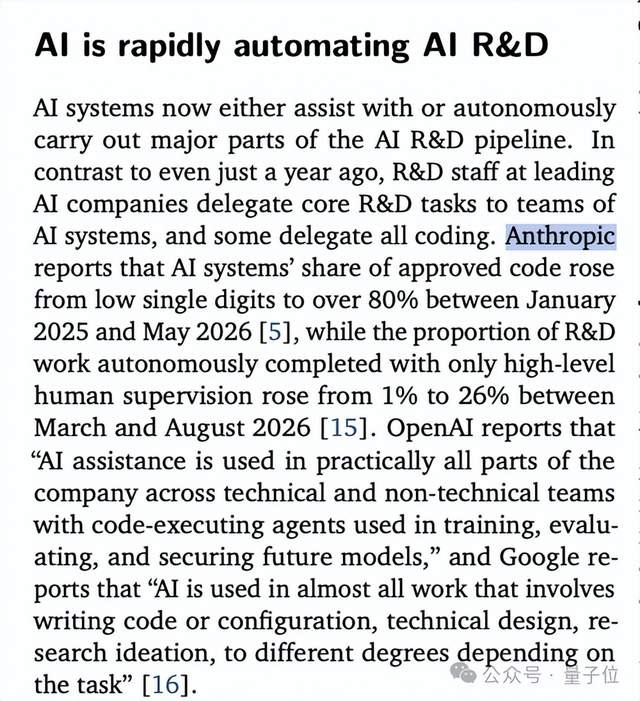
2025 年 1 月,AI 写出来的获批代码还只占低个位数。
过了一年多,到 2026 年 5 月,这个比例已经超过 80%。
变化更大的是自主完成研发的比例。
2026 年 3 月,有头部实验室的模型能自己完成约 1% 的研发工作。
到当年 8 月,这个数字升到了 26%。
半年左右,翻了二十多倍。
这个数字不能读成,模型已经替实验室干完四分之一的活。
它量的是另一回事。
在高层次人类监督下,AI 能自己扛下多少内部研发。
AI编程 就是最直观的一个切面。
论文也补了一句。
那家实验室说,目前还没有哪一类被测工作能做到完全无人监督。
但趋势已经很明显。
还有一条被论文点到的变化。
AI 能独立处理的任务,长度一直在涨。
决定它能不能像研究员那样干活的,不只是某个基准分数。
更要看它能不能把几十个步骤串起来。
在几个小时、几天,甚至更长时间里,盯着同一个研究目标不放。
单轮 AI对话 只是最浅的一层。
写代码只是研发里的一小块。
完整的研发还包括提假设,设计实验,实现实验,分析结果。
还得定位失败原因,调整路线,再从头来过。
这些环节单独被自动化,只能算 AI 在帮忙。
真正敏感的节点,是它们被串成一条长链。
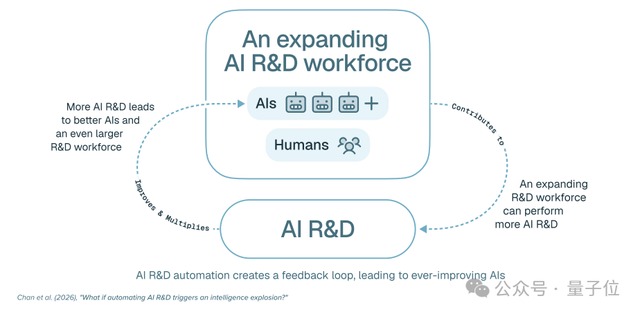
巧的是,AI 研发特别适合这种自动化。
它大多发生在数字环境里。
代码能直接跑,实验结果能很快回来。
模型行不行,用几个指标就能立刻验。
比起化学、生物和制造,它少了很多等现实世界反馈的环节。
古德当年那个遥远的循环,今天第一次有了具体的工程路径。
论文把这条路叫软件驱动的智能爆炸。
它和造出更快的芯片是两回事。
芯片设计和流片,还有建厂,都要长周期。
算法和训练方法,智能体流程和合成数据策略,一旦验过就能很快进下一轮。
作者真正关心的,是进步周期会不会越来越短。
与其追一句结论,不如先看那几道墙。
论文里最抓人的一段,说的是人和 AI 研究员的差别。
关键差别只有一个字,复制。
假设一家实验室今天有一千名顶尖研究员。
未来它做出一个达到同样水平的智能体。
从这一刻起,扩张团队这件事的规则就变了。
培养一个顶尖人类研究员,要读五年博士,再攒多年经验。
复制一个 AI 研究员,只要再开一个实例。
它能全天候干活,成千上万个实例一起跑。
底层模型一更新,整支队伍跟着升级。
人类科研最硬的一道限制,是人才培养速度。
这道墙被绕开了。
论文为此造了个词。
叫有效研发劳动力。
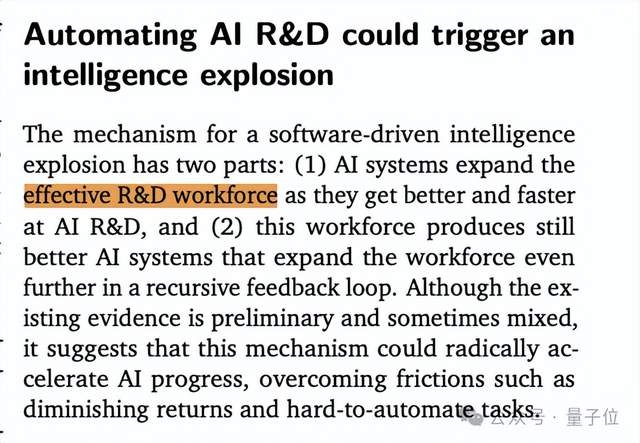
作者估算,如果 AI 到了顶尖研究员水平。
推理成本又和今天的前沿模型差不多。
那么一家领先公司现有的算力,理论上能撑起几百万人当量的研发队伍。
今天一家前沿实验室,也就几千人。
中间差了好几个数量级。
这里有个容易误会的地方。
一百万 AI 研究员,不等于一千倍研发速度。
科研有边际递减。
十个人研究一个问题,可能比一个人快很多。
一百万人挤同一个问题,很可能重复劳动,抢实验资源。
好点子还会越来越难找。
宁可把扩张速度想慢一点,也别当它会自动翻倍。
于是论文搬出了最关键的变量。
研究投入回报,记作 r。
意思是投入加码之后,技术进步能跟着涨多少。
r 偏低时,投得再多,收益也很快见底。
r 够高时,新能力会造出更强的研究员,反馈环才开始加速。
论文引用了一项历史数据研究。
覆盖三个 AI 研究子领域。
r 的中心估计落在 1.2 到 1.9 之间。
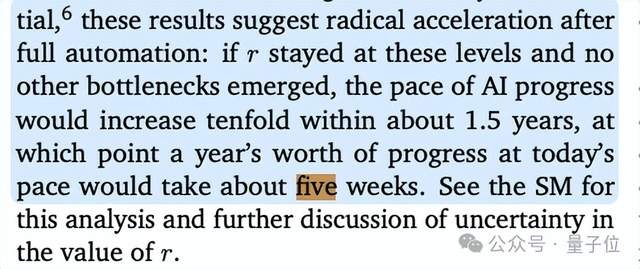
作者做了个假设推演。
如果研发全面自动化,研究回报还能维持。
短期也没有算力、数据这类瓶颈突然卡死。
那么技术进步速度可能在大约一年半里提高十倍。
今天要一年才走完的路,那时只要大约五周。
论文还算了另一笔账。
如果只维持现在的效率改进趋势。
自动化的研发队伍,在几个月到几年里就可能扩大一百倍。
而且增长可能从两条线一起走。
一边是研究员变多,一边是单个研究员变强。
这才是真正反常识的地方。
过去科技增长卡在人才培养。
培养一个优秀研究员,要十几年教育。
AI 研究员没有这道限制。
到了足够能力,培养就变成复制模型、分配算力。
研究能力本身,第一次变成了软件。
数量和能力这两个变量,第一次能被同一股力量同时推高。
论文说,这才是危险的地方。
加速的来源,自己也在被加速。
不过论文的基调并不只是刺激。
它反复提醒,现在的证据远远不够。
还证明不了智能爆炸已经发生。
眼下的生产率提升,也没明确越过那道门槛。
作者甚至列了一串前置条件。
AI 得足够可靠,能长时间自己干活。
还得真的提高研发产出。
新成果又得反过来,明显增强 AI 自己的研发能力。
就算未来真有几百万个 AI 研究员。
它们面前也横着几道很现实的墙。
第一道是算力。
AI 研究员能复制。
显卡不能凭空变出来。
大量关键实验都要跑大模型,再多智能体也得排队等卡。
训练一次前沿模型本身就要几个月。
一百万个研究员坐在电脑前,也没法把三个月的训练压成五分钟。
软件迭代能极快,底层算力的扩张还受物理世界约束。
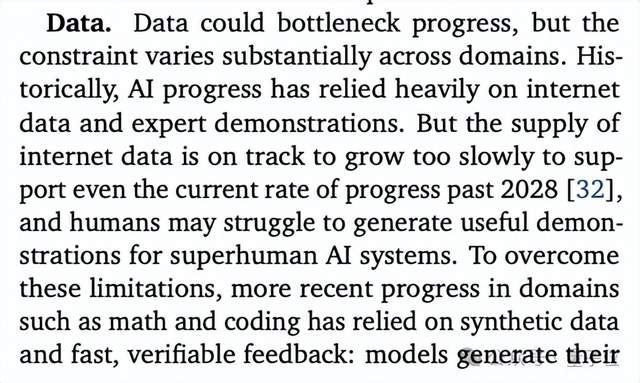
第二道是数据。
互联网上的自然数据不会跟着研究员数量一起涨。
论文讨论的趋势是,高质量自然数据会越来越难满足训练需求。
未来能不能靠合成数据,可验证任务,环境交互顶上。
现在还没有定论。
第三道是实验时间。
有些事本身就难并行。
训练要时间,造芯片要时间,建数据中心也要时间。
哪怕一百万个智能体同时提方案。
最后还是共享有限的显卡、集群和训练窗口。
还有一道更根本的墙。
科研会越来越难。
容易找的算法改进会先被找光。
往后每提高一点,都要更大的投入。
论文把这一点叫收益递减。
如果科研变难的速度,比 AI 变强的速度还快。
智能爆炸自然起不来。
所以论文没有下那个刺激的结论。
它说的是另一件事。
证据已经足够让这件事从科幻,变成一个要提前准备的现实问题。
甚至回头看,2026 年值得记住的节点,未必是哪个模型又多了几分。
而是人类第一次认真意识到。
AI 最猛的一次规模扩张,可能就发生在研究 AI 这件事上。