

一张几万块买回来的加速卡,可能只跑得出两成的算力。
剩下的部分,卡在“算子”这两个字上。
算子,说白了就是把矩阵乘法这类计算,写成芯片能直接执行的底层代码。
写得糙,芯片就一直在等数据。
写得细,同一张卡能把利用率从两成拉到九成以上。
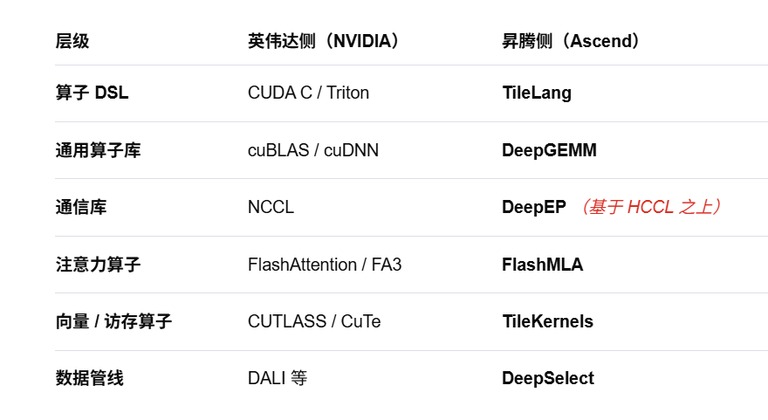
图注:英伟达侧与昇腾侧的算子工具栈对照。两边解决的是同一件事,各自有一套底层库。
最近,DeepSeek 做了一件不少人等了好几年的事。
它把自家整套算子工具链,原封不动铺到了国产加速卡上。
最核心的算子开发语言 TileLang,宣布原生支持华为昇腾 950。
一起搬过去的,还有五个核心计算与通信库。
国产算力第一次在算子这一层,做到了和英伟达生态对标。
做过 AI编程 的人都清楚,这一层最难啃。
在此之前,全球做芯片的人都苦于同一件事,软件生态绑着硬件,换一家就得从头再来。
新模型按月迭代,官方算子库却常常要等上几个月。
两边的节奏从来对不齐。
难就难在这。
一、写算子的作坊时代该结束了
想榨干一张芯片,开发者要手动管三级缓存。
还要调度线程,预取数据,拆分寄存器。
优化上千行底层代码,资深工程师磨上几周是常态。
这个行当里有个老说法,算法跑得快,是因为有人替你把苦活干了。
过去有三条路。
自己写,性能最高,可开发效率极低,还会被单一生态锁死。
用厂商预制的库,开箱即用,可你改不动里面的逻辑。
用高层编译器,门槛是低了,可上限又被编译器自己的优化策略按住。
TileLang 走的是第四条路。
它把资深工程师手工调优的思路,抽象成了标准化的编程原语。
开发者只声明“每块数据在哪里算”。
搬运、同步这些活,编译器自己完成。
性能直逼手写底层代码的上限。
图注:TileLang 的标识图,紧接在原文交代“第四条路”的那一段之后。
二、它站在另一个开源编译器肩膀上
TileLang 没有从零写一套编译器。
它复用了那个知名开源编译器框架现成的能力。
那套框架由华人团队发起,如今是国际顶级开源项目。
它的角色,像翻译官,也像优化师。
不管上层用什么框架,底层是什么芯片,它都能编译出适配的机器码。
TileLang 在它之上包了一层简洁语法。
开发者不用碰硬件细节。
几十行代码,就能把算力推到接近上限。
这套语言最早由北京大学的一个团队孵化,后来被 DeepSeek 接手推到生产环境,再回捐给开源社区。
截至目前,它的仓库已经攒下七千多颗星。
官方给的基准数据很直接。
在旗舰卡上跑核心算子,它的速度超过了主流深度学习框架的原生实现。
也超过了 OpenAI 那套被广泛使用的加速工具。
它甚至追平了英伟达官方调校的算子库。
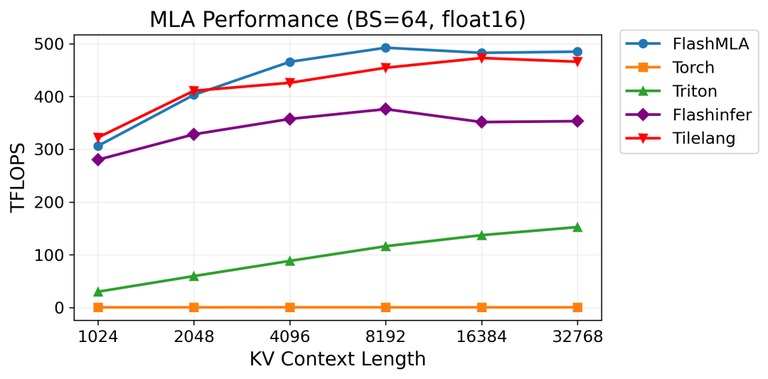
图注:旗舰卡上各底层框架的注意力算子解码性能对比。横轴是延迟,越靠左越快。
更关键的一点在后面。
英伟达的官方工具只认自家芯片。
它却能在 AMD 的顶级加速卡上跑出接近硬件极限的成绩。
差别很大。
这就是跨平台的价值。
三、一套代码,为什么能跑遍所有芯片
秘诀藏在一句话里,前后端解耦。
传统编译器把“为哪款芯片生成指令”和“怎么编译运行”绑死在一起。
换一款芯片,整套逻辑推倒重来。
它把这两件事彻底拆开。
目标后端只定义这款硬件的指令与优化规则。
执行后端只负责通用的编译和加载启动。
新芯片来了,执行后端一行都不用改。
只补一个对应的目标后端就行。
每个后端都走同一条四层流水线。
第一层,把代码翻译成各家芯片听得懂的方言。
第二层,统一硬件规格,记录编译状态。
第三层,做优化,把高层逻辑压成底层代码。
第四层,把代码拆成两份。
一份管调度,一份管计算。
四层之外,它还把三样控制权交回开发者手里。
数据放在哪一层存储,自己定。
几万个计算单元怎么分工,一句代码就能划分。
搬运和计算怎么并行,同样一句话开启。
用这三样写出的矩阵乘法算子,传统写法要五百多行。
换成它的语法,三十多行就够。
都是苦活。
对做 AI工具 的人来说,底下的算子快不快,直接决定产品好不好用。
那份性能对比图,几乎就是一张底层框架的排行榜。
跑分之外,还得有人愿意用。
四、押注国产芯片,最难的三关
真正的赌注不在代码里,在供应链上。
有报道说,在投资人的闭门会上,这家公司的负责人把“用国产芯片训练模型”称作眼下最大的赌注之一。
他已经下了一笔约 25.6 亿美元的订单,采购至少十六万颗国产加速卡。
这批货最快今年第四季度开始交付。
第一关是软件栈重写。
原先为英伟达架构写的训练代码,每一处底层调用都要换掉。
自研的几个核心算子,也要逐个在新硬件上重新验证性能。
第二关是通信。
上万颗加速卡之间同步梯度,靠的是一套通信库。
新旧两套库的接口不同,性能曲线不同,容错模型也不同。
任何一个环节对不上,整轮训练都可能静默失效。
第三关是产能。
推动这次转向的原因之一,是出口管制。
而同一套管制,也卡着国产芯片扩产的手脚。
订单能不能按期交付,谁也不敢打包票。
这家公司目前正在训练一款两万亿参数的模型。
再往后的规划,是八万亿参数。
模型越大,算力需求涨得越快。
按负责人的估算,训练一个同级别的大模型,大约需要二十万颗国产加速卡。
这条路还没有定论。
但有一点已经清楚,开源把“国产算力生态怎么建”,从一个工程问题变成了生态问题。
未来一年,至少四个变量会决定胜负。
交付率决定时间表。
后端追平的速度决定开发效率。
同行是否跟进决定生态规模。
管制是否升级决定下限。
剩下的,只能边跑边看。
