

每天上班,总有一段时间是耗在表格上的。
复制。
筛选。
拆列。
对账。
一份数据来回倒腾,半天就过去了。
有人换了个做法。
把原始文件直接交给一个AI工具,只说清楚要什么结果。
剩下的它自己想办法。
这不是演示视频里的桥段。
下面这些都是真实的操作记录。
既有表格,也有文档和数据库。
一、它不只是一个聊天框
先弄清用的到底是什么。
Codex 是 OpenAI 推出的一款编程智能体。
它和普通的AI对话产品不是一回事。
聊天助手只回你一段文字。
它能读你的文件,也能在自己的终端里跑命令。
跑错了还会回头改代码,再跑一遍。
它的起点是AI编程。
但现在早就不止于此。
意外的是它的用户结构。
官方数据显示,它每周有超过三百万人在用。
其中接近一半的用法,跟写代码没有关系。
写周报,整理文档,做表格分析。
这些都能交给它。
还有一个变化。
它开始记得住你的使用偏好。
纠正过一次的地方,下次不用再说第二遍。
有人形容得很准确。
这不是一个更聪明的搜索框。
它更像一个能自己动手的实习生。
二、表格活:从拆分到出图
第一份数据是一张电商订单表。
一万两千条记录,字段有几十个。
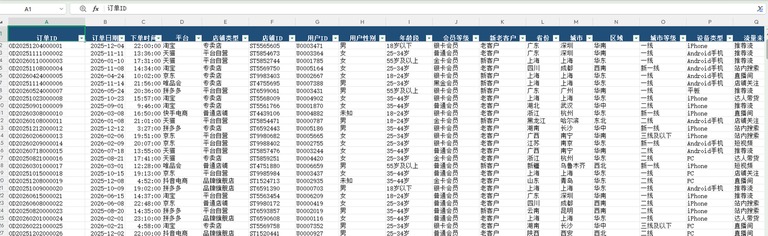
拿到原始数据,第一件事往往是按维度拆开。
不同岗位关心的列不一样。
运营盯销售,财务盯单据。
这一步过去要靠函数或者透视表。
现在只需要一句话。
先别急着自己写函数。
把这个表按店铺类型拆开,文件名用店铺名做前缀。
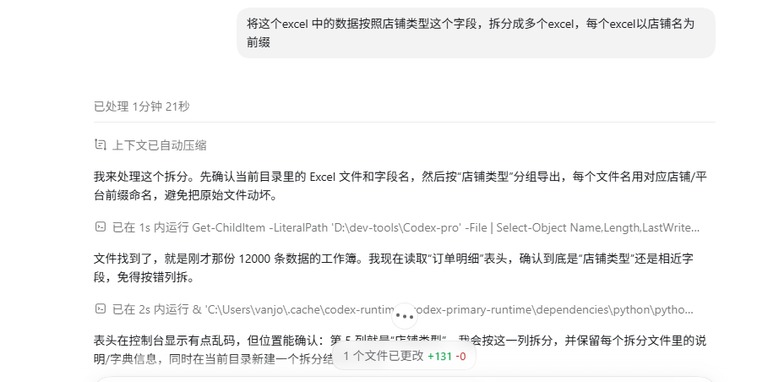
它会先确认字段名,再动手。
中途顺手把原始文件盯住,避免误改。
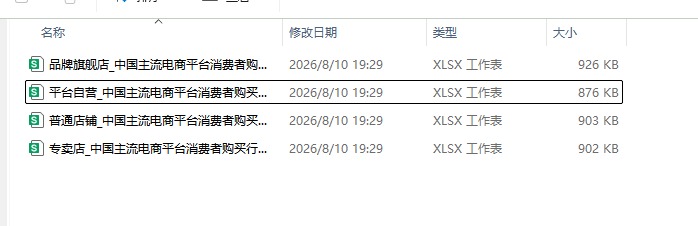
等一会儿,一批表格就分好了。
拆分只是热身。
真正麻烦的是脏数据。
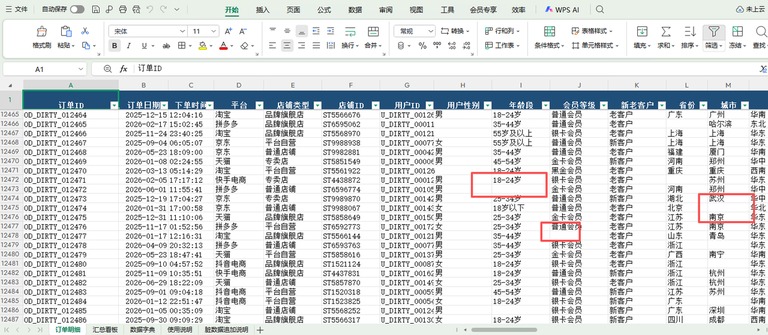
这份表里有几列是空的。
空字段会拖累后面的统计。
于是又补了一句话。
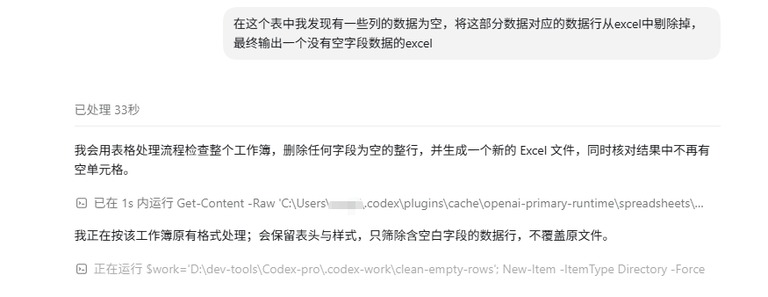
把空字段所在的行剔掉,输出一份干净的新表。
它没有直接删。
先用表格流程把整表扫了一遍。
结果剔掉一万一千多条,留下六百多条完整记录。
很干净。
顺带还更新了那张汇总看板。
有个细节值得留意。
它保住了原来的表头和样式。
只动数据行,不覆盖原文件。
接下来是统计。
拿到一份数据,不同的人关注点不同。
有人看地区,有人看渠道,有人只要一张图。
先按地区看消费。
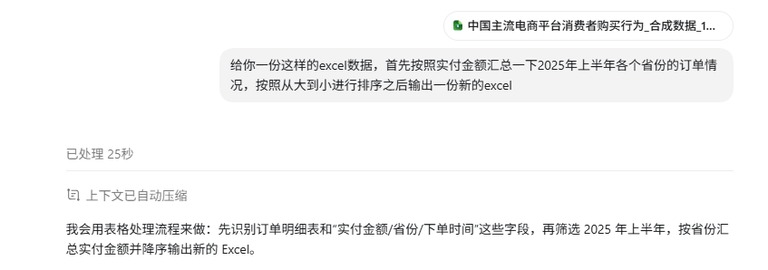
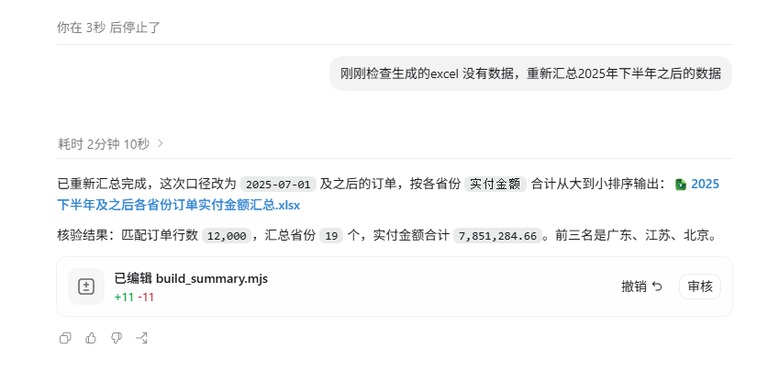
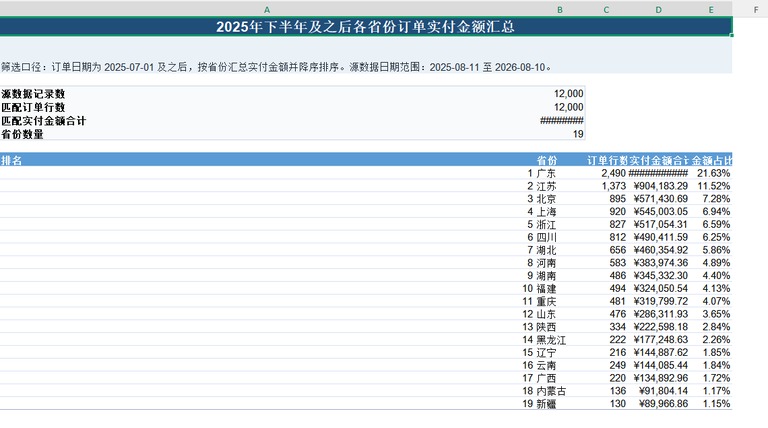
给你这份数据,按实付金额汇总各省订单,从大到小排序。
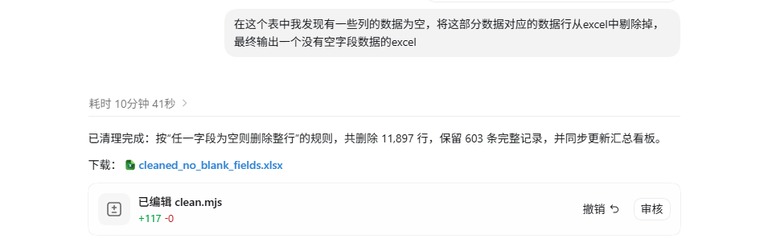
第一次汇总它自己发现上半年数据缺失,于是重新调整口径,最后按省份把实付金额从大到小排好了序。
第二次输出正确,还附上了校验数字。
再换一个维度。
这张表里每笔订单都来自不同入口。
推荐流有,直播间有,站内搜索也有。
于是问题换成了流量来源。
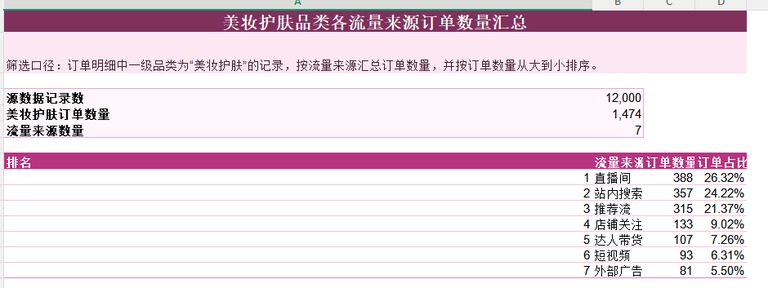
汇总美妆护肤这个品类各个流量来源的订单数。
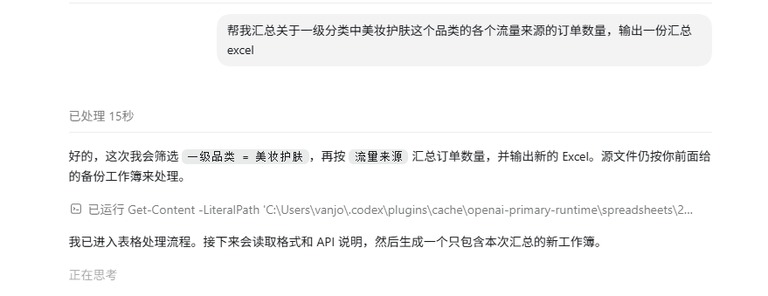
它先筛品类,再按来源归组。
输出前还核对了一遍总数。

结果里直播间排第一,站内搜索排第二。
拿到这张表,接下来的投放就有据可依。
还可以直接要图。
管理层更习惯看图,而不是看数字。
所以最后一句要求是可视化。
不限形式,柱状图饼图都行,能组合更好。
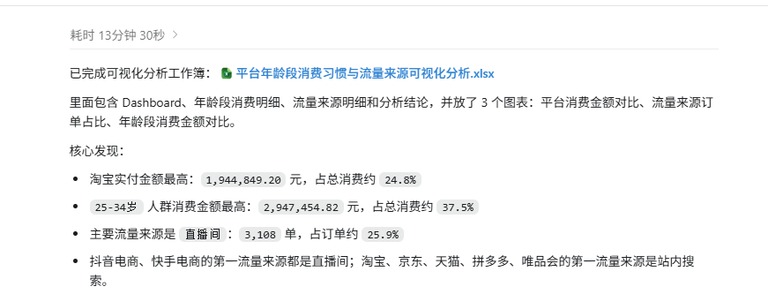
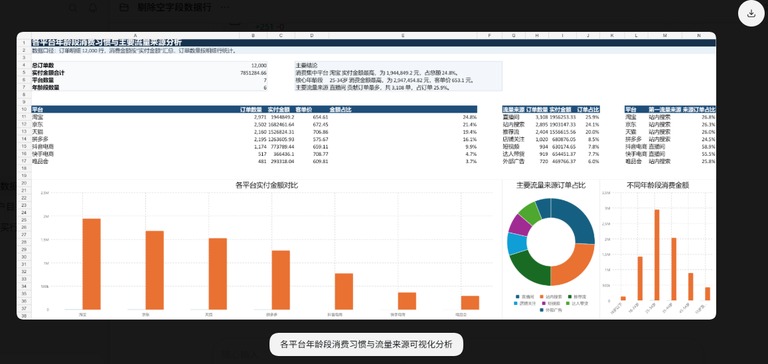
它建了一个分析工作簿,里面放了三个图表。
平台消费金额对比,流量来源占比,年龄段消费对比。
还顺手写了几句核心发现。
25 到 34 岁的人消费金额最高。
三、文档活:从提取到合并
表格之外,PDF 是另一大块。
业务数据传到后来,常常变成 PDF。
它比表格能装更多东西。
先看提取。
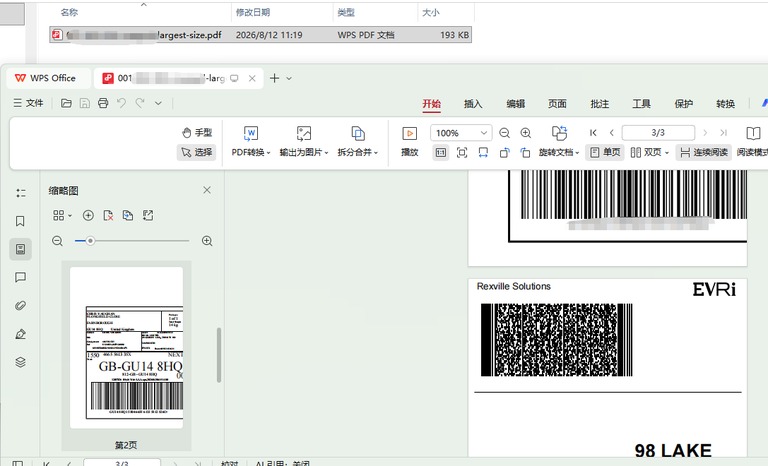
这份 PDF 里有几段数据要单独拿出来。
为了说明白,作者提前用红线框住了要的那几段。
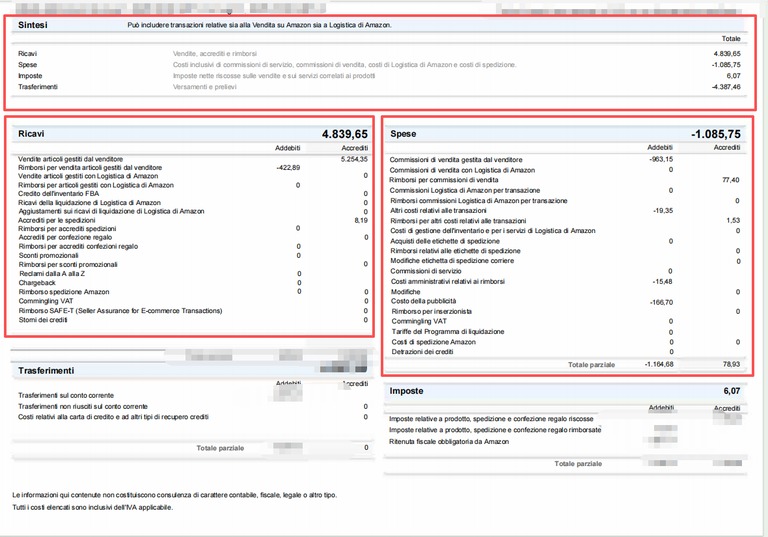
然后把文件连同参考图一起给它。
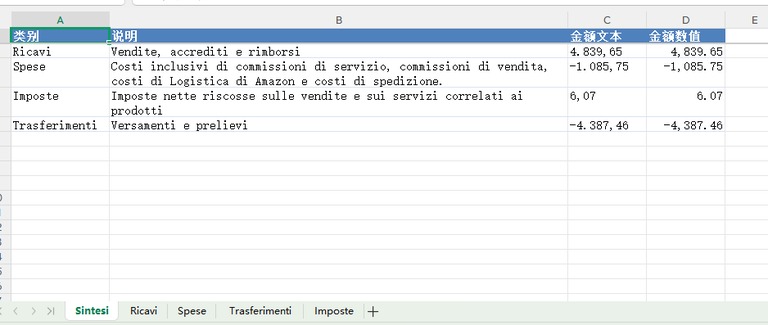
把红框里的数据提取出来,放进当前目录的表格,分成不同 sheet。
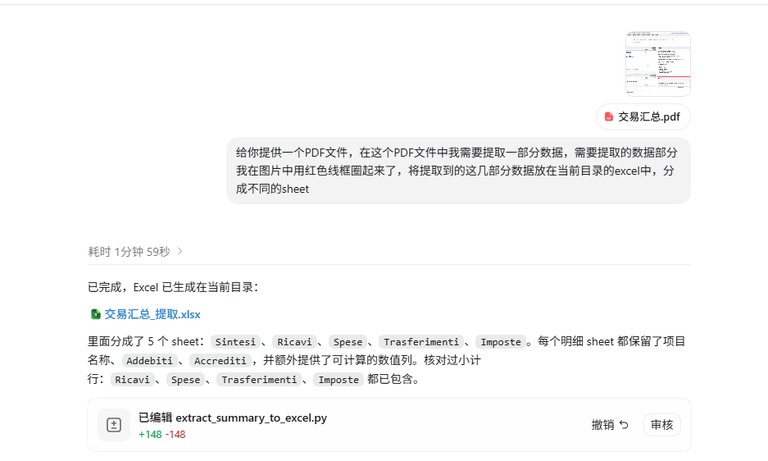
打开检查,跟原始 PDF 逐项对得上。
数据完全准确。
如果 PDF 是网上的链接,还能更省事。
不用先下载,直接把地址给它。
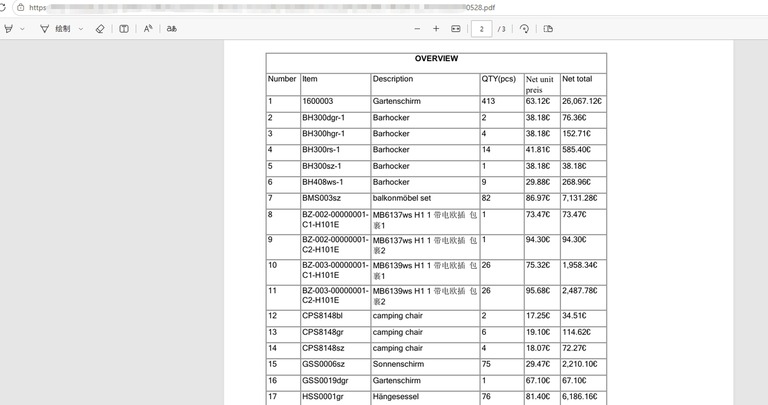
让它读第二页和第三页的表格,写进本地表格。
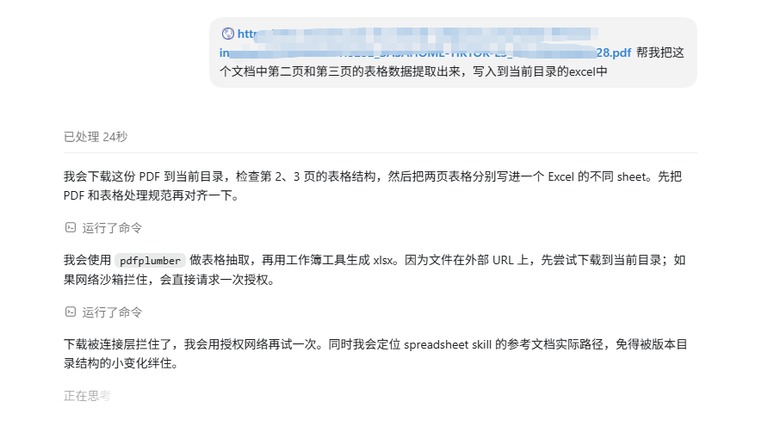
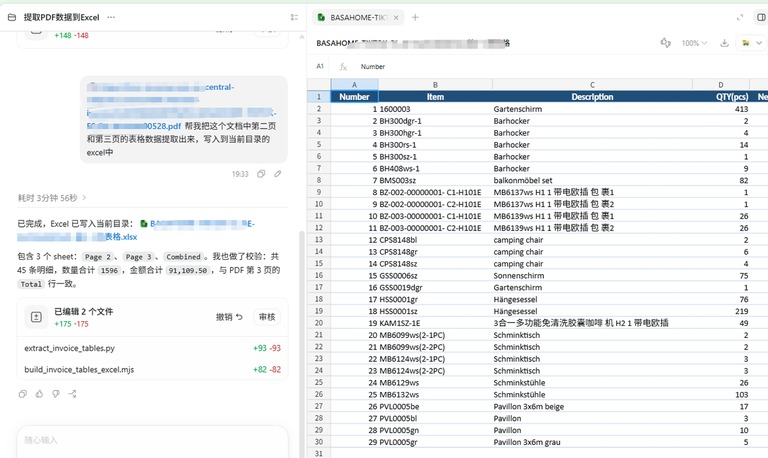
它会先下载,再用专门的库抽表格。
遇到编码问题还会自己绕过去。

最后按页码分成两个 sheet 存好。
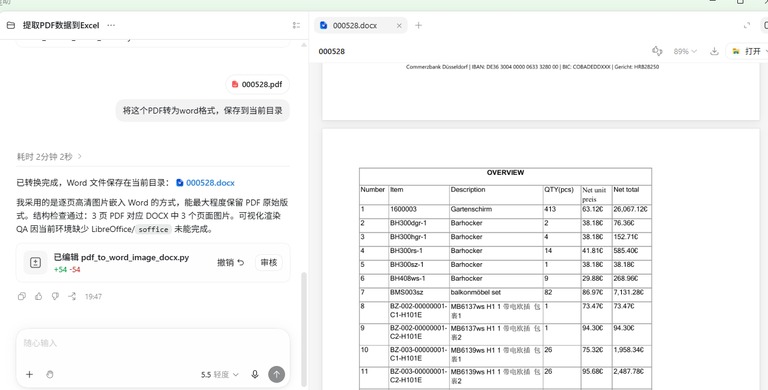
转格式也是高频需求。
过去这类活要么用三方工具,要么花钱买软件。
效果还未必达标。
现在一句话就够了。
把这个 PDF 转成 word,存到当前目录。
还有合并。
手里散着一堆 PDF,分开处理很费事。
先合成一份再动。
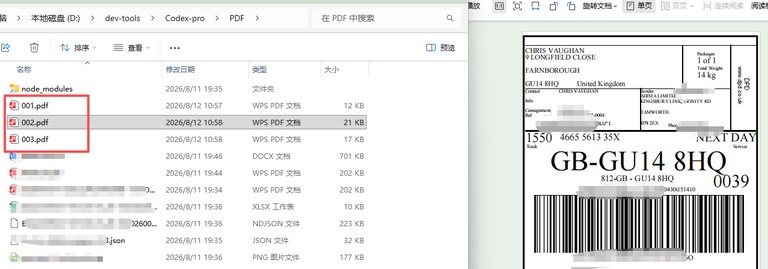
比如本地有三份文件要并成一份。
尺寸以最大的那份为准,原始文件不要改动。
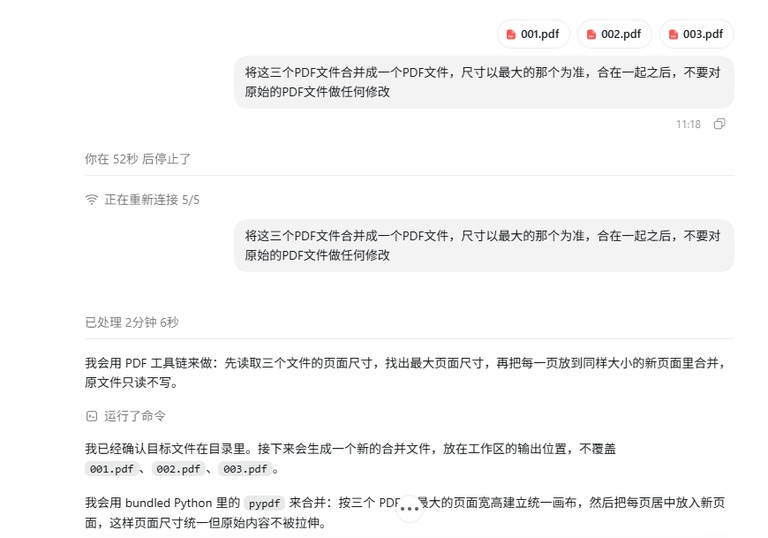
它会临时写一个小脚本辅助执行。
这种事它做得很自然。
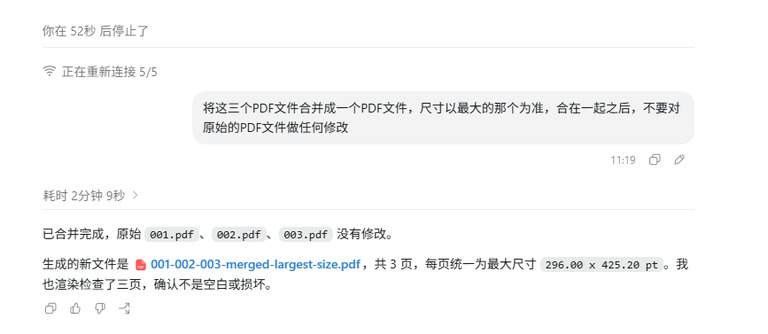
结果出来了,原始三份文件一个没动。
四、系统与数据库:跨系统搬数
前两类活都在本地文件里。
真正费时的是跨系统搬数据。
很多岗位每天要从不同平台拉数。
自己公司的业务系统一份,外部平台又一份。
凑到一起才能分析。
这个过程容易出错。
把它改成一句话编排,效率就完全不同了。
先看抓取。
要在某个系统里取几个字段,落到本地表格。
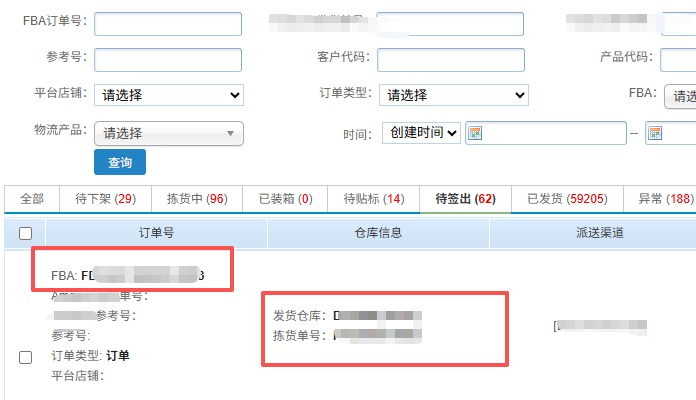
难点在于那个系统没有现成接口,它先读了提供的文档和截图,确认了登录地址和要取的字段位置。
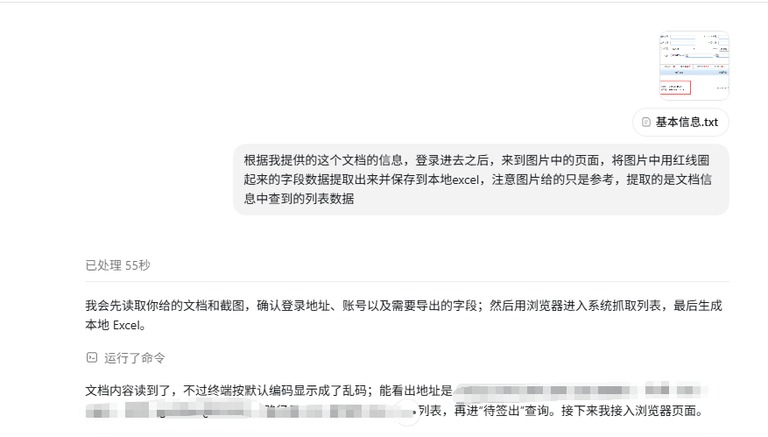
然后自己打开浏览器,登录进页面。
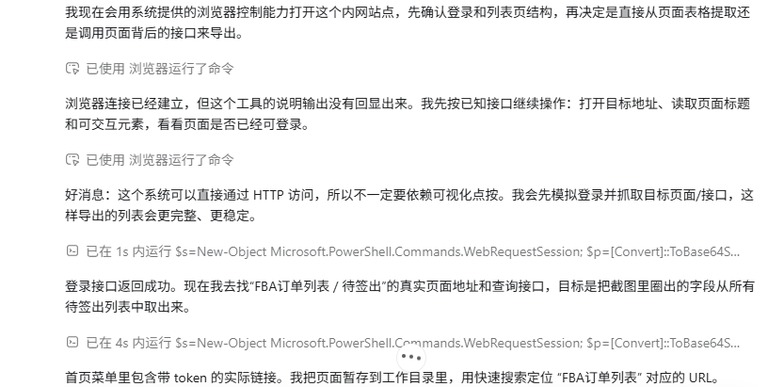
发现页面背后的接口能直接用,就改走接口。
一次拿到六十二条记录。
比手工点一遍快得多。
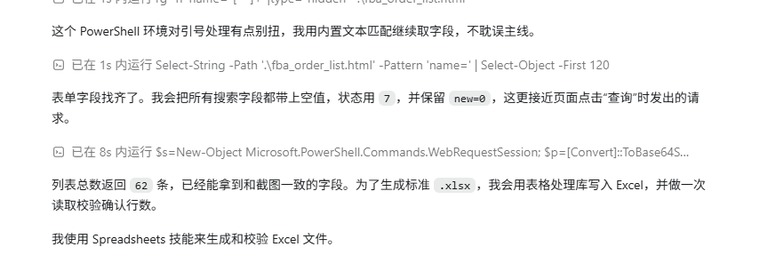
最后写成标准表格,还做了行数校验。
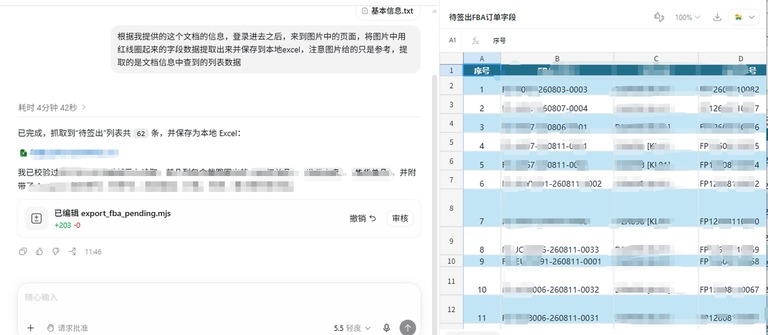
下一步是把数据送进飞书多维表。
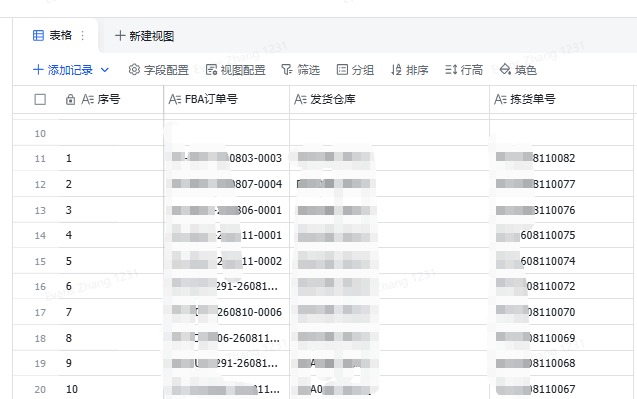
先准备一张表。
表头尽量跟导出表格对齐,省得它反复解析。

第一次尝试就撞上了权限。
它老老实实停下来,把问题讲清楚。
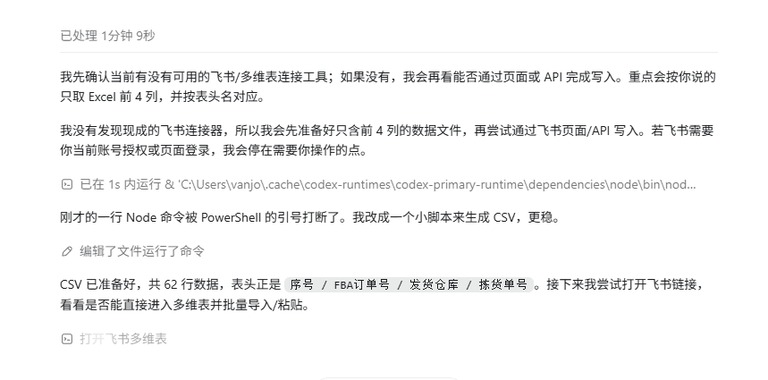
它要的是登录,或者一份开放平台的应用凭证。
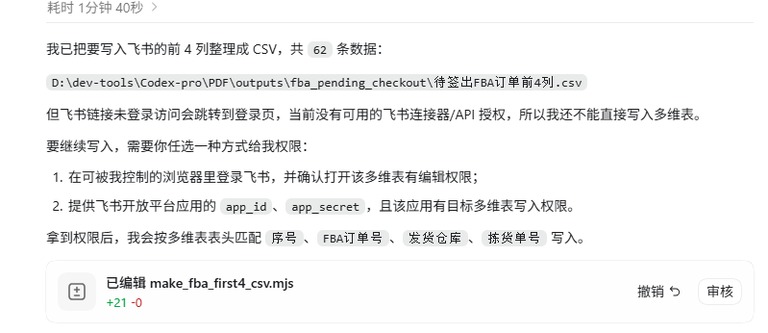
给了凭证之后,它换了一套走法。
先用接口换令牌,再解析出表格的标识。
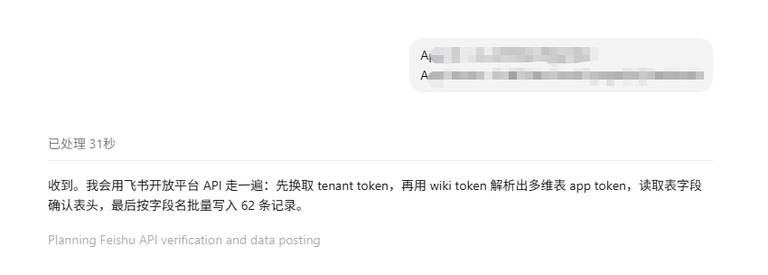
六十二条数据全部写入成功。
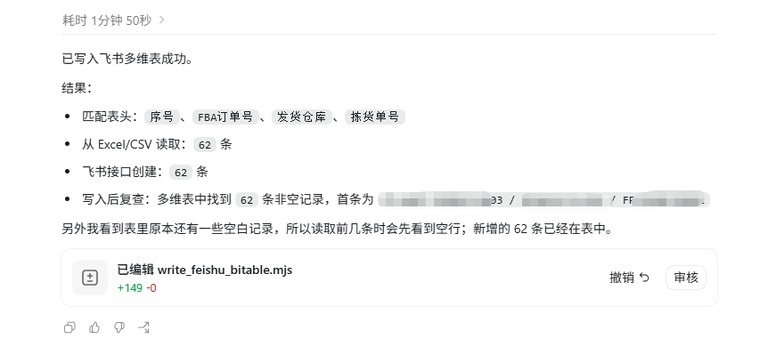
写完还回读了一遍,确认没有空记录。
顺带提一句,这类流程还能做成定时任务。
每天自动拉数并汇总入库。
人只需要偶尔看一眼。
最后是数据库。
有些一手数据就躺在系统库里。
在账号安全、不涉敏感数据的前提下,可以直接查。
比如这张物流运单表。
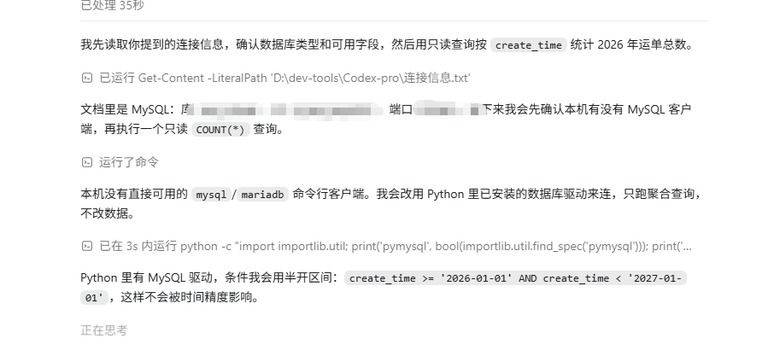
问一句 2026 年产生的运单总数。
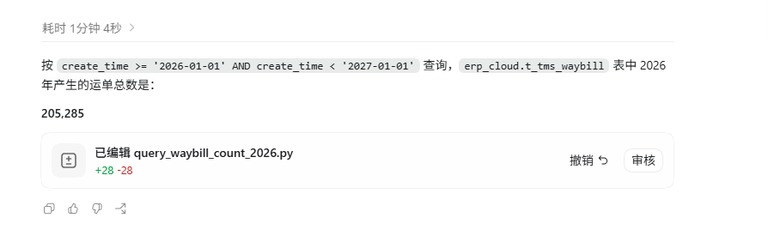
它发现本机没有现成的命令行客户端,于是改用驱动连库,只跑了一个只读的汇总查询。
按创建时间统计,答案是二十万零五千二百八十五条。
换个维度也很顺。
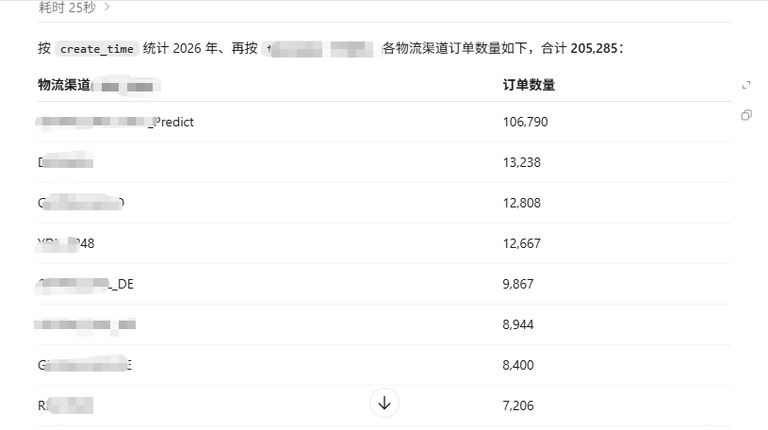
按物流渠道统计 2026 年的订单数量。
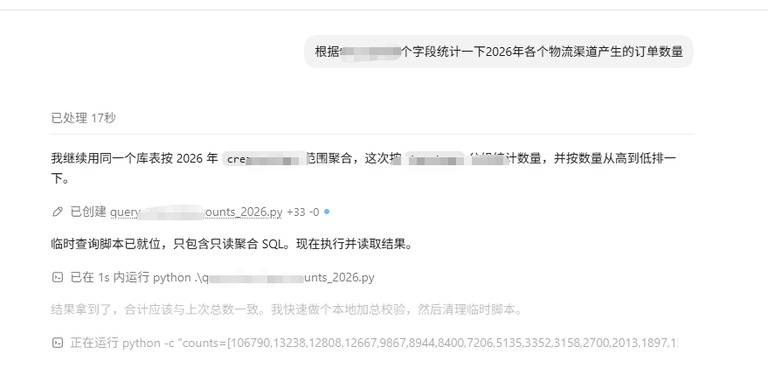
结果从高到低排好,总数跟上一问对得上。
没出错。
这里要提醒一句。
这套操作本质是把自然语言翻成查询语句。
背景信息给得越清楚,结果越可靠。
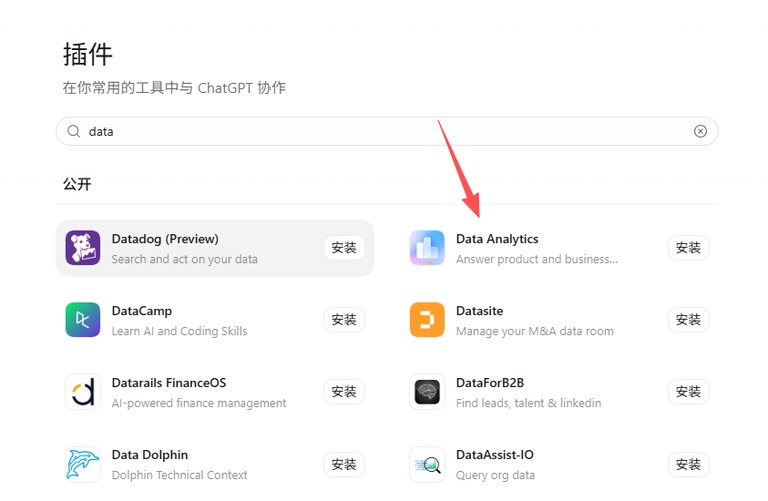
最后一条路是现成的插件。
这个工具里内置了一些数据分析插件。
表格处理是一个,数据分析是另一个。
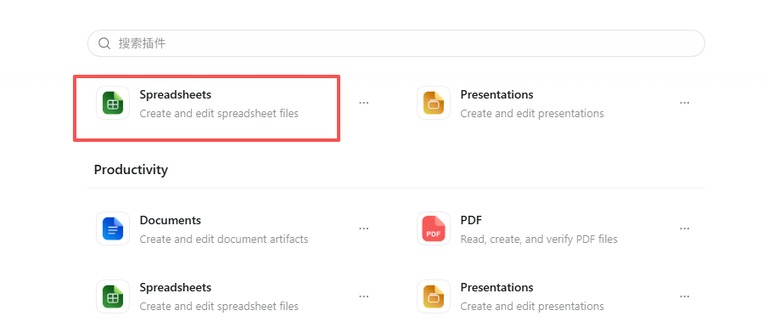
装上就能用,不用自己搭环境。
如果需求特别个性,还能把整套流程封装成技能。
下次遇到同类场景直接复用。
回头看这几个场景,会发现一条共同的线。
人负责说清楚要什么结果。
工具负责把中间的步骤跑完。
值得留意的是它的边界。
它没有直接删数据,也没有覆盖原始文件。
遇到权限问题会停下来问,而不是硬闯。
这几点决定了它能不能被放心交派。
数据活的门槛,正在从会不会写函数,变成会不会提问题。
Codex安装汉化 中转站 微信:douhanq
