

2018 年,谷歌放出过一个叫 BERT 的模型。
它不聊天,也不写文章。
只干一件事,把一段话读懂。
八年过去,对话模型换了好几代。
可你今天用的搜索和审核,里面还有它的影子。
很多 AI工具 的排序和过滤,背后跑的就是这类模型。
一个不会聊天的模型,凭什么活这么久。
答案藏在它的训练方式里。
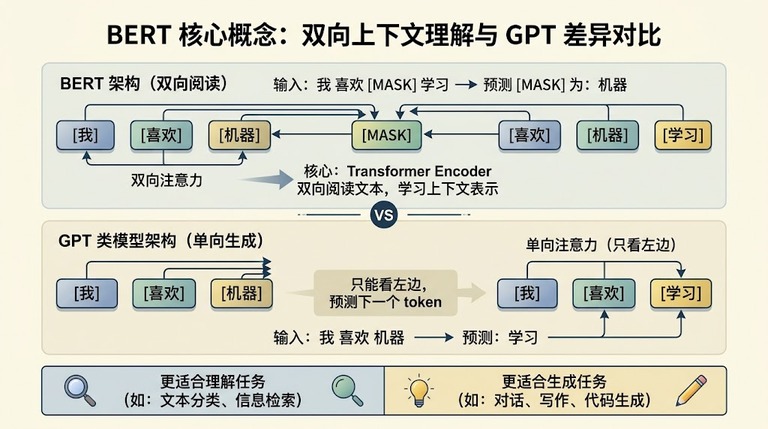
核心只有一句话。
用编码器双向读完整段文本。
再把一部分词遮住,让它自己猜。
猜的过程里,它学会了上下文。
一、它出现之前,每个任务都要单独做一套
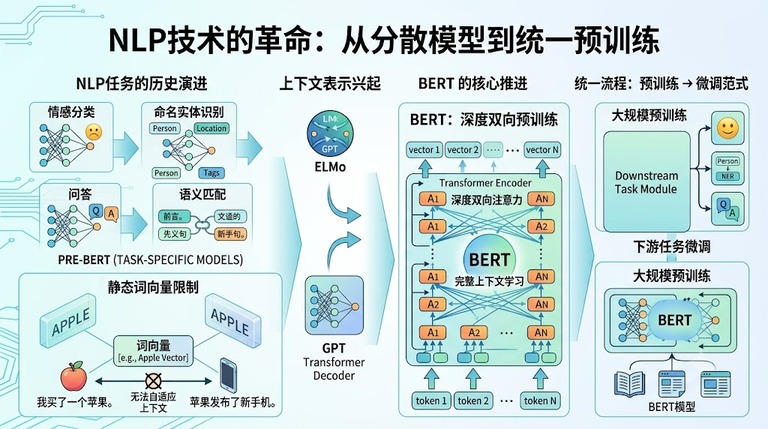
在它之前,文本任务基本是各做各的。
情感分类一套模型。
命名实体识别一套模型。
问答又是一套。
语义匹配还得再来一套。
更麻烦的是词向量。
那时候一个词只有一个固定向量。
同一个词换个意思,向量还是那个。
我买了一个苹果。
苹果发布了新手机。
两句话里的苹果,指的根本不是一回事。
模型分不出来。
后来有人补上了上下文化的表示。
可模型还是各训练各的。
BERT 换了个思路。
先在海量文本上预训练,再拿到具体任务上微调。
一套底座,接很多下游活。
这个路子后来成了主流。
二、它的骨架决定了它只会理解
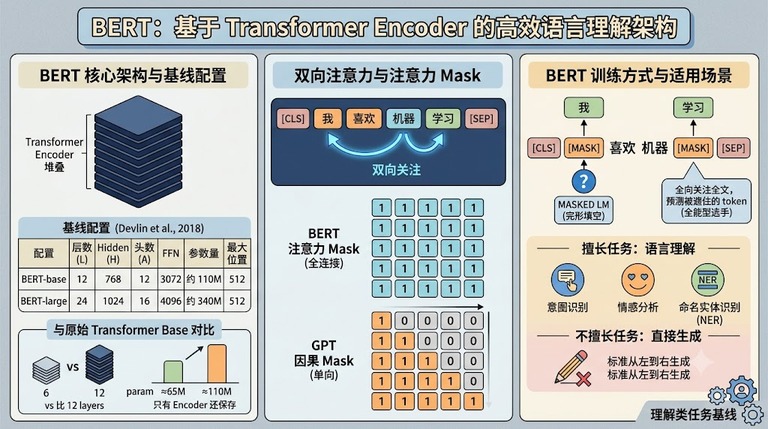
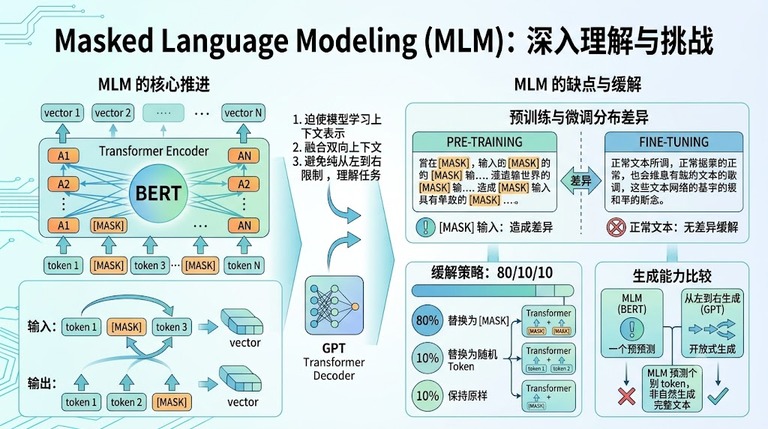
BERT 的骨架是编码器一层层堆起来的。
编码器的特点是每个词都能看到全句。
左边看,右边也看。
注意力之间没有遮罩。
每个位置都是通的。
对话模型正好反过来。
它只看左边,然后猜下一个词。
右边的信息被挡住。
一个负责理解,一个负责生成。
这也解释了它的短板。
它写不出连续的段落。
因为训练时它看的是带遮挡的整段文本。
不是给定前文猜后文。
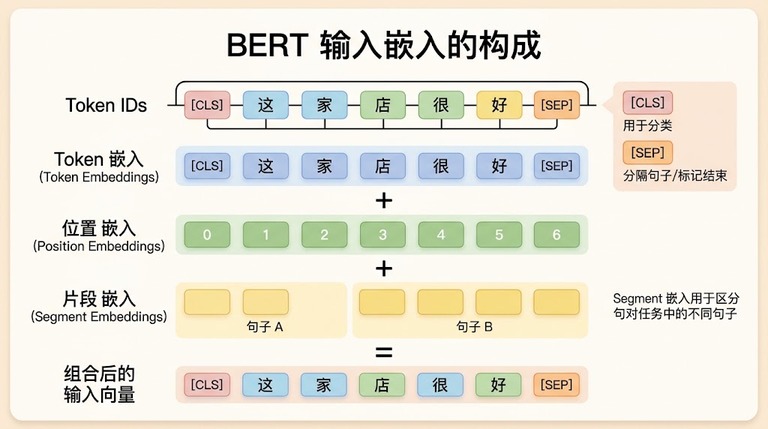
送进模型之前,输入还得先拼三样东西。
词本身的向量。
每个位置的顺序信息。
再加上句子段的标记。
三样相加,才是一条完整输入。
句首有个专用符号。
它的输出常被拿出来代表整句。
句子之间还有分隔符。
判断两句话关系的任务,就靠这个分段标记。
这些符号不起眼。
少了它们,模型分不清谁是谁。
三、遮住一批词,让它自己猜
训练方法叫遮词预测。
随机挑一部分词盖住。
再让模型根据上下文猜原文。
关键在于它是双向读的。
猜的时候,左右两边都用得上。
被挑中的词不是一律盖住。
八成换成遮挡符。
一成换成随机词。
剩下一成保持原样。
这么做是为了缩小训练和使用的落差。
真实文本里没有遮挡符。
但它不只是完形填空。
要猜对,模型得先吃透上下文。
每个词的表示里就带上了前后文。
这套表示后来能直接复用。
分类能用,抽取能用,匹配也能用。
早期的做法里还配了另一个任务。
判断两句话是不是前后相邻。
后来有人把它去掉了。
用更多数据,更大的批量,更长的训练,效果反而更好。
说明它不是必需品。
但预训练任务选什么,决定模型擅长什么。
方向选错了,后面的微调会很吃力。
四、今天它藏在检索和排序里
在今天的系统里,这类模型还在大量干活。
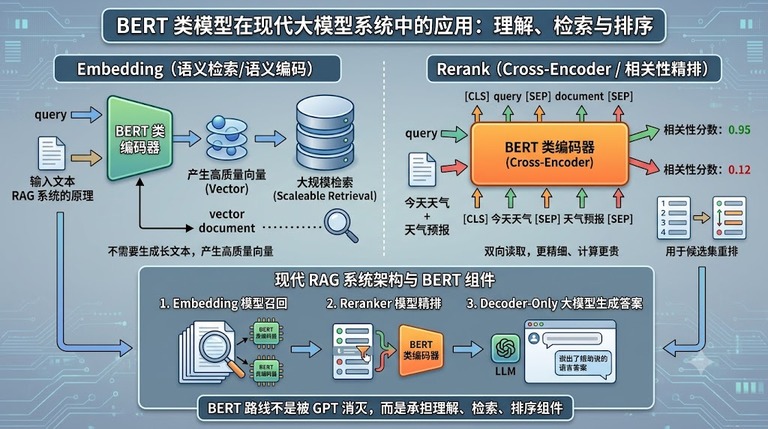
检索要先把文本变成向量。
很多嵌入模型就是这条路线的延续。
精排更直接。
把问题和文档拼在一起,双向读一遍。
然后输出一个相关度分数。
这比单纯算向量相似度准得多。
代价是慢一些。
所以它一般只拿来给候选集重排。
常见的组合分三步。
先召回一批候选。
再做精排。
最后交给生成模型组织答案。
它没有被取代。
它变成了流水线里的一段。
什么时候还值得用它,有两个判断。
如果任务的输出是一个标签或者一个分数,它常常更划算。
如果并发高,延迟紧,成本敏感,小模型更经济。
它做不了 AI对话 那种多轮生成。
那本来也不是它的活。
AI编程 里的代码检索和补全排序,同样在用这类模型。
企业系统里现在还留着大量编码器模型。
原因不复杂。
便宜,稳,够用。
它常被当成对话模型的旧版本。
这个说法不对。
两者是两条不同的路线。
也有人说它能双向看,所以更强。
强不强要看任务。
生成这件事上,它确实不如对话模型。
但高并发的分类和检索,是它的地盘。
回头看这八年,它赢在定位清楚。
不跟生成模型抢对话。
只做理解、检索和排序这些苦活。
也留下几个提醒。
模型大小不是唯一标准。
任务和架构要匹配。
老架构也不等于废架构。
如果手上有一堆分类和检索的活,先别急着上大模型。
先量一量成本,再决定用哪一档。
工具换不换,看的是能不能跑通,不是新不新。
跑得顺的那套,别轻易掀掉。
