

一篇数学论文里的猜想,被人推翻了。
推翻它的不是同行。
是一个程序。
写下这个程序的人,最初并不相信模型能做研究。
他本来只想试试,模型到底能走多远。
模型没有顺着论文往下证。
它构造了一个反例。
猜想的根基当场松动。
他把推导整理成一封信,寄给原论文的作者。
回信很短。
反例成立。
从那天起,他把整套研究搬给了机器。
过去两年,AI工具 的能力一直按答题来考。
出一道难题,看它会不会做。
现在有人把考题本身也交了出去。
一、仓库里躺着 453 份手稿
这件事的规模,看数字更直接。
项目公开仓库里存着 453 份数学研究手稿,加起来 2312 页。
不算少。
有 6 篇被单独归到一类。
那一类的名字,叫模型自己提出的猜想。
但 453 这个数字容易被误读。
它指的是手稿数量。
不是 453 个开放问题被解决了。
里面既有完整证明,也有反例和局部结论。
项目自己提醒过一句。
机器审自己,不等于外部同行评审。
二、失败被当成下一轮输入
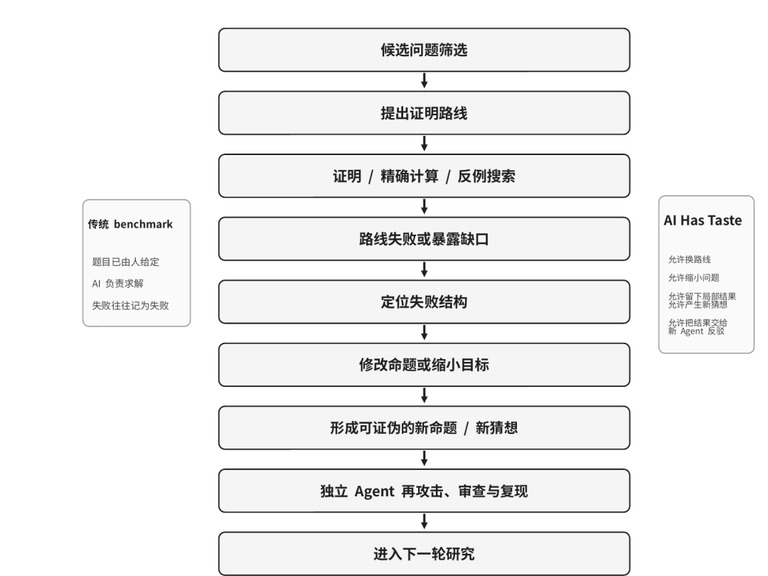
整套设计里最值得看的部分,是一个失败的例子。
研究者原本走单调性那条路。
算到一半,反例不停冒出来。
常规做法到这里就停了。
图省事的话,就在这一页标成失败,换下一个题。
这套流程没有停。
它接着追问,反例到底破坏了什么。
问得很细。
失败有没有稳定的形状。
最后注意力被收到一个固定的缺陷上。
补出一组修正结构,提出一条新的有界性猜想。
新猜想没有被放过。
另一轮计算和独立审查反过来找它的漏洞。
到今天它还站着。
还没倒。
公开归档已经扫到第 1004 条。
那条统一界仍然没有证明出来。
这套做法和 AI编程 里的思路有点像。
价值在于原问题没解决,路却变清楚了。
失败被压成一个更精确、更容易被推翻的新命题,这条路一旦走通,就能重新连回原来那道题。
研究没有停在失败那里。
它在失败里长出了下一道题。
三、四个角色,各管一段
这件事跟常见的 AI对话 体验不一样。
它不是让一个模型自己问自己。
真的做法是把角色拆开。
一个人负责挑候选问题,比较几条路的成本。
这一层最费判断。
一个人负责证明、反例和大量计算。
还有一个人专门挑错。
他换一个干净的上下文,只盯着冻结之后的命题,专门去攻最脆的那一处,不看任何解释。
最后一个人负责写清范围,核对引用和材料。
口径要写死。
批评被写进了发动机,不是论文写完之后的补充。
这句话印在仓库首页。
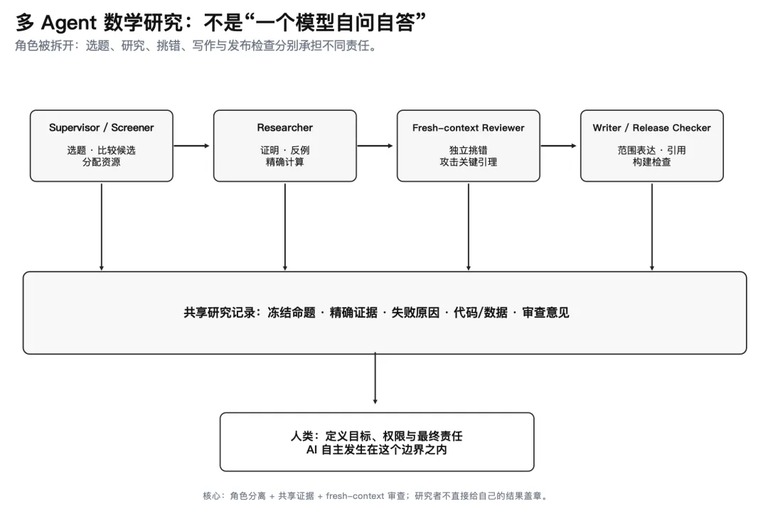
机器自己审自己,不算审完。
项目后来请了外面的学者参与。
有马来西亚科学院的两位院士。
也有中国地质大学(武汉)的一位教授。
他们没有给 453 份手稿逐篇签字。
只对一部分结果做过验证和讨论。
这种搭配比让同一套系统自查更靠得住。
机器把速度推到极限。
人在关键节点踩一脚刹车。
四、品味指的是什么
项目名字里的品味两个字,容易被想歪。
仓库特意划了边界。
它说的不是意识,也不是主观感受。
指的是研究决策里那种数学判断。
比如两个问题都能做,先动哪个。
一条路已经有进展,但收益越来越低,要不要停。
一个反例是把命题判死,还是说明定理该换个说法。
这些判断过去藏在研究者的经验里。
标准测试很难把它量出来。
现在它们留下了痕迹。
项目自己也写了局限。
手稿不是通过同行评审的期刊论文。
内部审查不等于学术共同体的独立审稿。
宁可按慢的来,也不让没验证的结论先跑出去。
有限计算的覆盖,不能自动推到无限。
但这些限制不影响位置的变化。
模型正在从执行任务,挪到参与设计任务。
如果只把它当成一台会算题的机器,很容易看轻它。
真正稀缺的从来不只是算力和推理长度。
是什么问题值得花时间,什么失败值得留下,什么时候该收手。
一位研究者现在更像课题负责人。
定边界,挑问题,决定什么时候停。
AI 会做题之后,下一关可能是 AI 会不会选题。
