

43 分钟,11138 个推理 token,6 批指令。作战单位 0 个。
这是 Grok 4.6 在《星际争霸:母巢之战》里交出的一张成绩单。
数字很直白。
从开局苦思到游戏结束,它连一个能上场打仗的兵都没造出来。
同一张榜单的另一头,站的是 Codex 家族的 GPT-6 Astra。它火力全开,18 战 18 胜,胜率 100%。
一冷一热,都在同一张表上。
这两天,一份星际大模型榜单火了。它叫 Brood War Bench,先火的阵地是 Hacker News。硅谷程序员扎堆的地方,讨论量一路往上走。

如今已是 OpenAI 员工的 Peter Steinberger,也是 OpenClaw 之父。他特意转发为自家模型造势,只留了一句话。新榜单来了。

可这份榜单的作者,开篇就甩出一个画风完全相反的判断。
就连全胜冠军,也打不过一个人类新手。
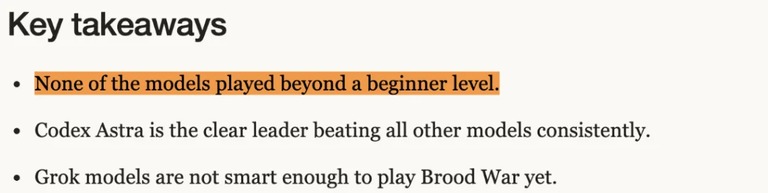
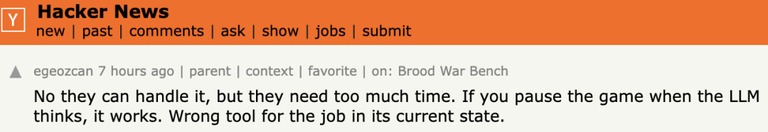
评论区里有人一句话点破了要害。它们不是玩不了,只是需要太多时间。你要是在模型思考的时候把游戏暂停,它就能玩。
还有人直接开嘲。搞得好像这些模型不是通用智能一样。
全网最聪明的模型,为什么会在星际里被自己的思考拖死。
一、游戏永远不会停下来等你
这个榜单的诞生,本身有点戏剧性。
起初,开发者 Ben 只是做了个全靠智能体操作的星际版本,拉上几个朋友一起玩。
这帮人几乎没碰过星际,打起来却一点不输玩了好多年的老玩家。
秘诀简单到离谱。只管打字喊一句进攻。造兵,集结,开打,全交给模型。
他于是好奇。如果人类彻底闭嘴,让模型自己玩,它们能活多久。
于是 GPT 与 Claude、Grok 三家凑出 19 名选手。一场 171 局的乱斗就此开打。
比赛跑在 Freestyle 的云端虚拟机上。每局单开一台机器,同时开打。游戏数据和每一步思考记录,全都留了底。
做数学题,写代码,大模型可以发呆 5 分钟再一次性交卷。
但打星际不行。
这里没有模型习惯的回合制,只有一刻不停的实时战场。
你思考的每一秒,对面的农民都在狂挖矿。兵营在爆兵,大部队已经朝你家高地冲过来。
老一代模型还拿回合制的路数打这种即时战略,结果脑子还在转,家已经被推平了。
这个差别,跟日常挑 AI工具 是同一件事。回合制的活儿可以慢慢想。实时的活儿想完就凉了。
Steinberger 的帖子下,有网友一语道破。有意思,难怪模型做游戏的时候,总爱做回合制的。

二、Grok 苦想 43 分钟,一个兵也没上场
把回合制思维演绎到极致的,正是 Grok。
在编号 G043 的对局里,它堪称思想上的巨人,行动上的矮子。
它疯狂输出大段大段的战略推理。可 43 分钟的游戏里,总共只发出 6 批指令。平均 7 分多钟才动一次手。
这不是偶然。
G003 里,它造了 3 个机枪兵,始终没走到敌人基地。G002 里,它造了 2 个狂热者,同样没能穿过地图。
兵是造出来了。就是打不到对面。
最高推理档位下,它 2 胜 15 负。
数据曲线很直观。比赛打到 11 分半,冠军早就兵强马壮。Grok 场上平均只有不到 7 个农民和几个兵。
搞笑的是,它的国库里躺着远超冠军的巨额存款。
钱在兜里,大脑在运转,就是死活不动手。

在星际这种残酷的战场上,想得久不叫深思熟虑,叫挂机等死。
三、Astra 的必杀技,是让对手想到死
如果说 Grok 是被自己想太多拖死的,那冠军就是专门逼别人想太多。
GPT-6 Astra 所在的 Codex 家族,最绝的一招是骚扰。
它经常只派一个最基础的采矿农民,横穿整张地图跑到敌人家门口溜达。在人类玩家眼里,这种战斗力为零的农民,随手拉两个工兵就能赶走。
但在模型对局里,这招是降维打击。
对面的模型只要一看到这个农民,瞬间陷入沉思。花上几十秒去计算该怎么处理它。
在这宝贵的几十秒里,它什么都不干。基地彻底停摆。

在即时战略游戏里,骚扰对方是为了破坏经济。到了机器对机器,骚扰的最大杀伤力,是把对手直接拖到宕机。
当然,冠军也有弱点。
它的内部像是一个不和睦的草台班子。管经济的,管造兵的,管打仗的,各干各的。
新兵刚造出来就被管打仗的拉去前线白给,完全不懂什么叫集结部队。
不过作者发现,只要他亲自下场当总指挥。把几个子智能体串起来,它就懂得攒兵、挑时机。
Codex 家族还有一股顽强劲儿。
有一局,冠军的兄弟 GPT-5.6 Terra 部队全军覆没。主基地也被拆了。它把仅剩的一个指挥中心拉上天,一路飘到地图另一头的角落,硬是又撑了 6 分钟。
四、最像在打星际的是 Fable
全场好几局都想让作者替它使劲儿的,是游戏优等生 Fable。
它的打法最正。老老实实搞经济,踏踏实实发展科技树,很少投机取巧。
有一局它憋出了飞龙。另一局,它把神族一整排高级建筑挨个盖齐,连高阶圣堂武士要用的圣堂档案馆都造好了。
比赛打到 11 分半,Fable 的农民和兵力都压着冠军。建筑和科技也一样。
可好学生未必能拿第一。
它的胜率有 83.3%,排在第三,却依然追不上冠军。
有一局它科技摆满了一桌子,还没等转化成战斗力,就被 Claude Opus 5 乱拳打死。

节奏上也差得很远。冠军对局的时长中位数只有 8 分 10 秒。爱慢慢种田的它,被拖到 10 分 37 秒。
三个模型,三种脾气。
Codex 像个满肚子坏招儿的街痞。Grok 像考场上死磕第一题的轴学霸。Fable 则是那个翻着攻略逐字照做的老实人。
五、想得越久,不一定打得越好
既然想太多会死,那是不是脑子越空越好。
也不全是。
GPT-5.6 Sol 推理开到最高档,胜率反而垫底,还不如中档。
可到了冠军这里,想得越深赢面越大,最高档直接拿下 100% 胜率。
更有趣的是账单。
它开到最高推理档,每分钟只操作 12.6 次。平均一局只花 10.54 美元。换成最低档,操作频率翻倍到每分钟 25.7 次。一局反而要烧掉 21.07 美元。
最高档位,出手少一半,花钱少一半,赢得最多。
放到真实场景里也一样。宁可先动手再修正,也别把整段时间耗在思考上。
这说明新一代模型显然已经进化了。它们懂得了思考是有成本的。也知道什么时候该停下脑子去动手。
六、7 年前赢过职业选手,今天为何打不过新手
有人肯定会想起一段旧战绩。7 年前,DeepMind 的 AlphaStar 不是早就击败过职业选手吗。
没错。2019 年初,这家实验室公布了 AlphaStar 的战绩。两个 5 比 0,横扫职业选手 TLO 和 MaNa。

10 局比赛,职业选手一局没赢。
后来,它被加上了和人类一样的限制。只能通过屏幕镜头看局部地图。每秒能做的操作次数也被压低。
就这样,它又匿名混进欧洲天梯,一路打上宗师段位,超过了 99.8% 的人类玩家。
一边是天梯前 0.2%。一边连会光炮快攻的新手都打不过。
难道是模型的技术倒退了。其实不是。
两者比的根本是两码事。
它打的是《星际争霸 II》,更像一台纯粹的应试机器。靠吃海量录像和疯狂自我对战,堆成了星际特长生。这辈子只学了这一件事。
而今天这些在初代《母巢之战》里对战的大模型,是没有任何星际基础的通才。
它们全靠临场读题,调用工具,现学现卖。每一步都得先想完才能出手。
专才打败职业选手并不稀奇。通才想跨界通关,还要再等等。
文章最后,作者抛出了自己的结论。
冠军再无敌,也防不住人类新手最爱用的光炮快攻。它们组织不起复杂的阵型,也执行不了长远的战术。
过去几年,我们给 AI 出的都是回合制考题。问来问去只有一句。你算得对不对。
可星际不一样。它和自动驾驶、具身机器人一样,身处一个不会暂停的世界。对手随时都在动。
这场测试也暴露了模型走向自主行动时最要命的短板。烧掉更多思考 token,未必换来更强的智能体。
下一阶段的 Agent 之争,比的或许不再是深度。而是谁能在有限时间里,把观察和决策连起来。然后让执行一起跟上。
星际里的翻车,或许就是模型进入真实世界前的一次预演。
Grok会员中转站 微信:douhanq
