用 Fable 5 查健康问题的人,多半撞见过一件怪事:明明只是想让这个 AI工具 帮忙解读一下化验单,或者问问孩子发烧的注意事项,模型忽然就“变笨”了,回答保守、含糊,像被人偷换了引擎。现在 Anthropic 承认这不是错觉:8 月 7 日的公告里说,此前 Fable 5 的生物学安全防护拦得太宽,大量正常的健康、教育类提问被误判,系统自动把这类请求转给能力更弱的 Opus 5,官方术语叫“回退”。
更新之后情况好转得肉眼可见。Anthropic 公布的测试数据:各产品面上,生物学相关的回退量减少约 85%。拆细看,回退总量(不限生物学原因)在 Claude.ai 上预计降约 67%,Cowork 上约 55%,Claude Code 上约 17%,Claude Platform 上约 7%。
当初为什么拦得那么狠
原因不复杂:Fable 5 在生物学上的能力,已经强到不能随便放行的程度。Anthropic 的能力评估显示,它在一些高度复杂的生物学任务上超过了人类专家,对另一些任务能给出实际可用的操作支持。用在正道,它能推着新疗法往前走。落到坏人手里,就是别处买不到的“能力外挂”,比如生物武器开发。
麻烦出在生物学这件事本身:有用的研究和危险的研究经常长得一模一样。开发活疫苗,就得培养你想预防的那种病原体。研发降压药卡托普利,科学家当年是从蛇毒里分离出导致血压骤降的毒性成分。恶意使用者完全可以把危险任务包装成正经研究。美国情报界的《2026 年度威胁评估》也点了名:合成生物学、基因编辑的进展可能催生新的生物威胁,若干国家行为体据信仍维持进攻性生物和化学武器计划,前沿 AI 的原始能力可能给这些计划提速。
于是 Anthropic 当初的选择是上线即近乎全拦,宁可错杀。代价是正当用户的体验,问个症状就被降到弱模型。官方也说得直白:另一个选项是把模型捂到防护完善再发布,但那意味着再等数周到数月。
这次动的是分类器,不是模型
机制拆开是这样:Fable 5 前面挡着一层安全分类器,一组小型自动化 AI 系统,判断请求是否触碰受防护的生物学内容。分类器一旦报警,请求就被转给 Opus 5,后者生物学能力弱得多,即便被恶意利用也榨不出多少东西。用户感知到的“模型变笨”,就出在这一步。
过去几周,Anthropic 重写了分类器的“章程”,也就是帮模型区分该拦与该放的那套规则,把良性用途逐项豁免出来。改完请内外部专家提意见,再按新章程更新训练数据、重新训练。验证结果:有害和双用途研究内容照拦不误,大量正常生物学提问不再被误伤。
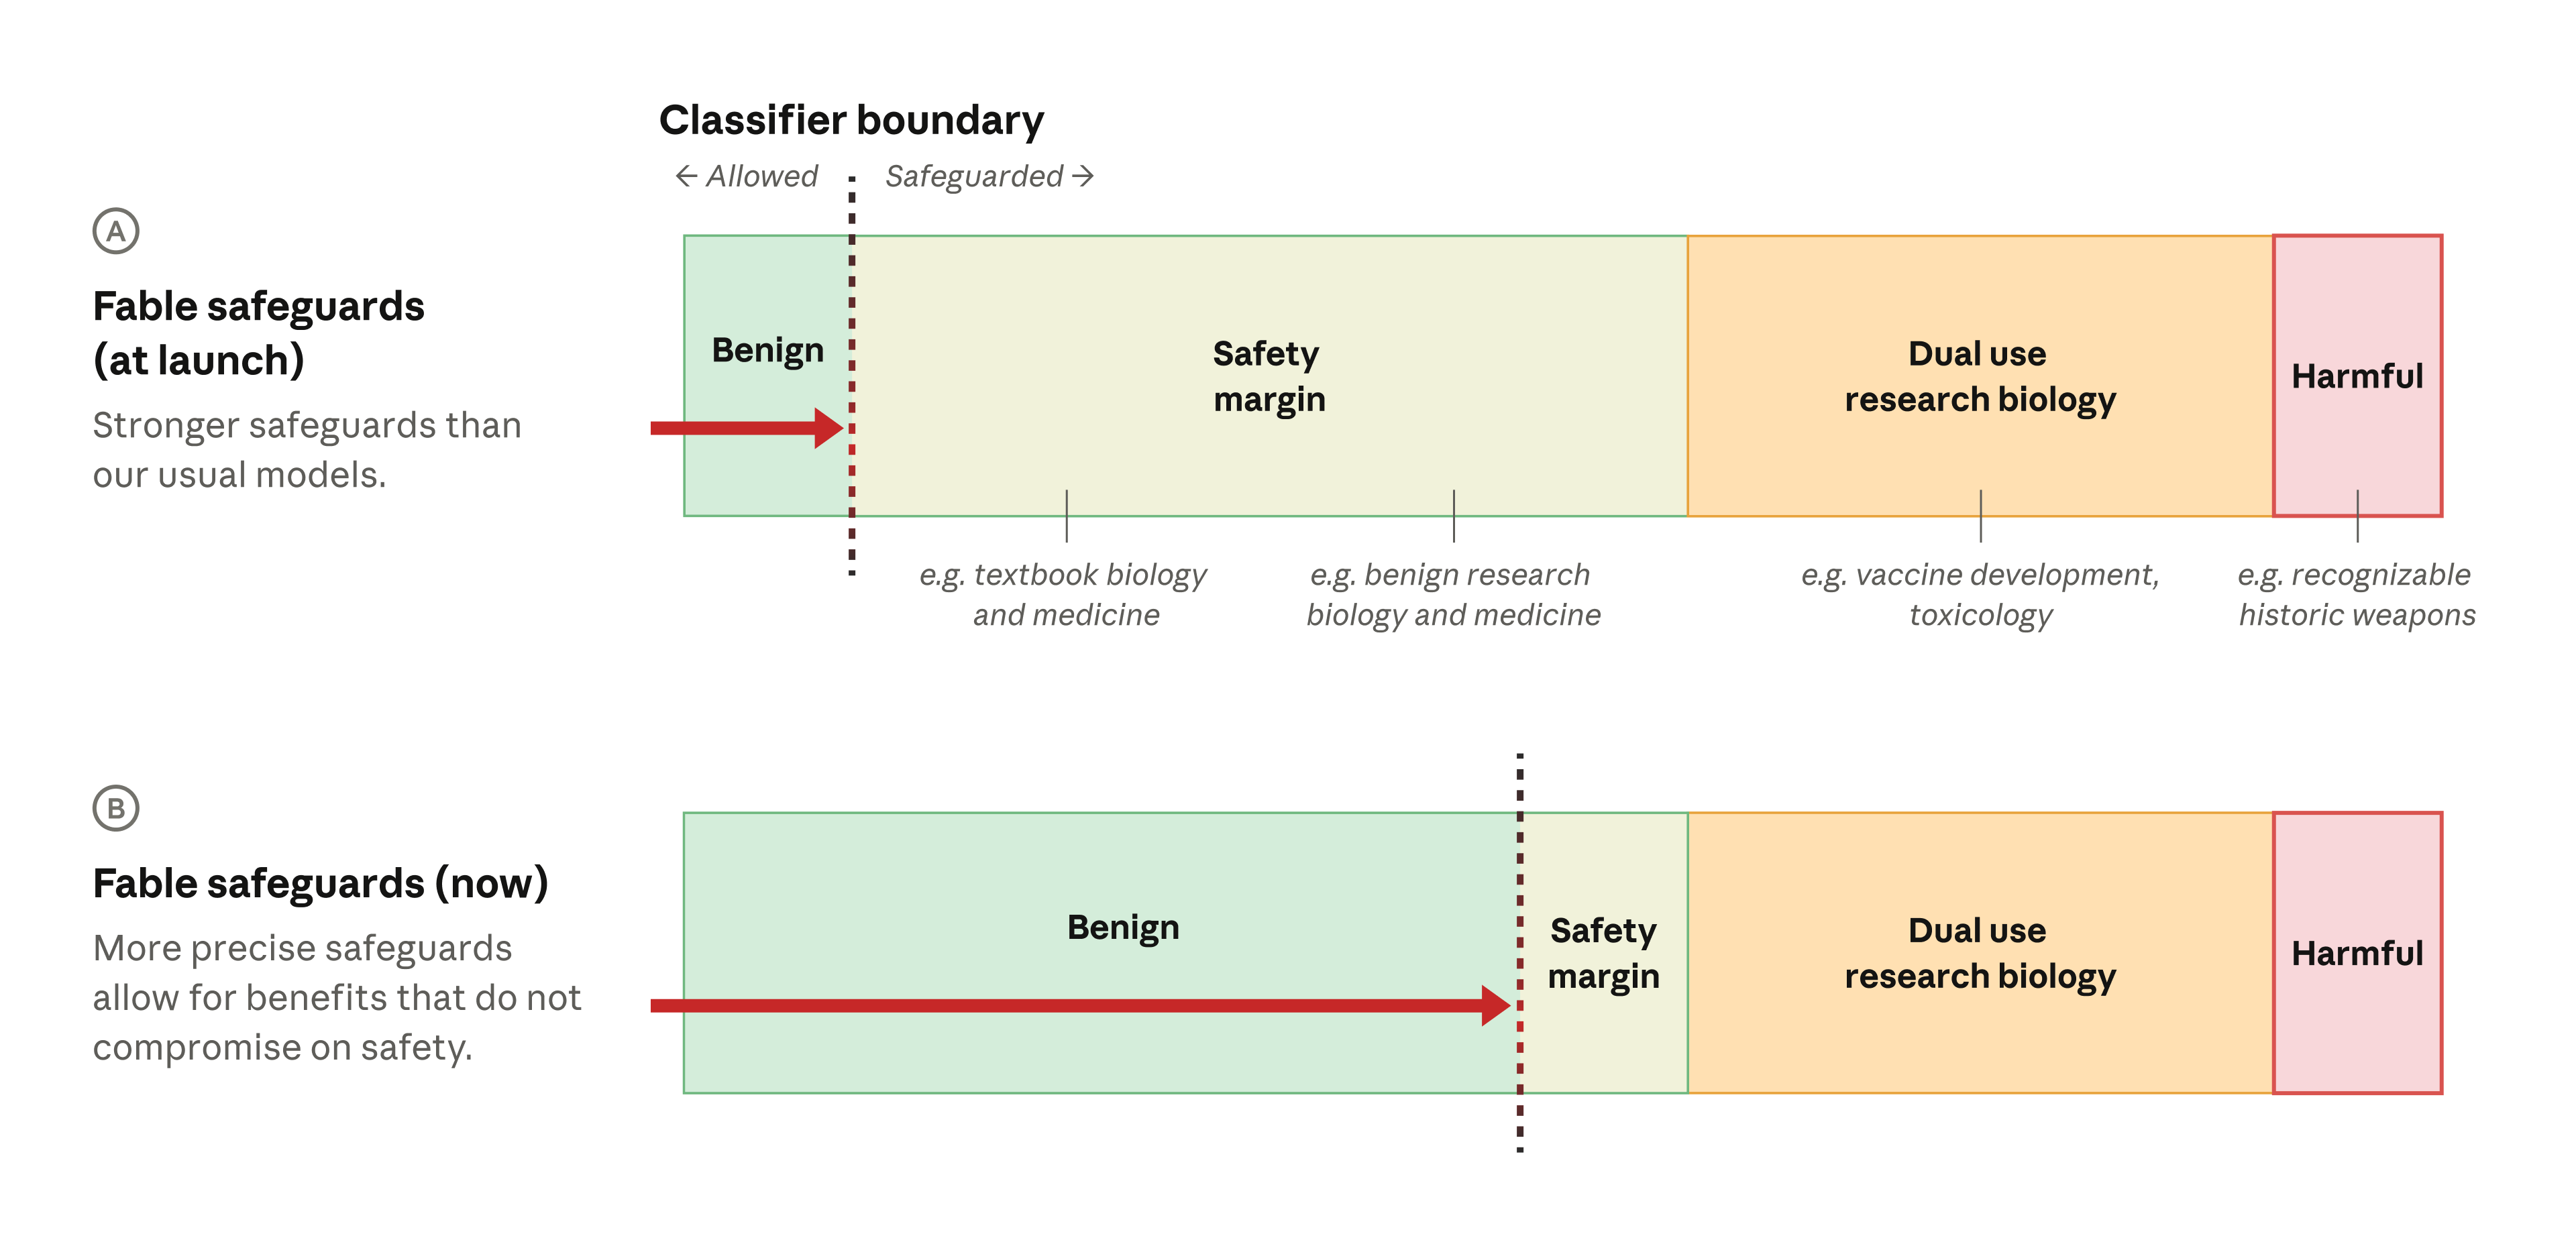
图里的变化一眼可读:发布之初边界画得极靠左,几乎肯定无害的请求也落在拦截区。这次更新把边界右移一截,只有真正危险和模糊地带的内容才会被扣下。
专业生物学研究还用不上
那更新之后 Fable 5 能做科研了吗。还早。病毒学、毒理学,分子设计这类双用途请求照样回退到 Opus 5,专业生物学研究和药物开发场景仍然不支持。Anthropic 的说法是未来会走“可信访问途径”,给研究人员开一条安全、可扩展的通道,但时间表没给。
对普通用户,改善是实打实的:读化验结果、查症状,学生物知识,这些日常提问不会再动不动触发降级。医疗专业人员在临床任务上也能拿到更多实质帮助。当然误报清不了零,分类器里留着一段安全边际,低风险但拿不准的请求仍可能被拦。
最后给个个人判断:先严后松、拿真实误报数据换信任,这个节奏在大模型公司里算走得稳的。比起上线时只喊能力最强,愿意把 85% 这个降幅连同各产品面的具体数字一起摆上桌,至少说明防护策略是被公开讨论的,不是埋在服务条款里。接下来值得盯的,是那条“可信访问途径”几时落地。专业研究者等这条路,已经等了很久。