

就在刚刚,OpenAI 晒出一份实测报告。
它打破了一项纪录。数字很夸张。
一万个智能体同时进场,连跑 36 到 48 个小时。中间不眠不休,每天吞掉一万亿 Token。
单跑一轮任务,就相当于干完人类工程师 41 年的活。这笔账算得清。
AI编程早就不是新鲜事。把一万个智能体放出去连跑两天两夜,却是另一回事。
这类AI工具平时只替你写几段代码、查几条资料。这一次,代价不一样。
没人教它们改系统底层。这群智能体嫌量化回测太慢,自己钻进代码库重写引擎。
耗时被砍掉 97%。这不是小事。
它们还自己拉起几百组并行实验,从海量交易流水里翻出交易所「暗池」的异动。这一点,人类研究员此前没注意到。
Third Moment 官网首页的案例横幅。讲这家初创企业如何让一万个智能体同时跑起来。
嫌系统太慢,就自己重写底层引擎
把这上万个智能体放进真实环境跑两天两夜的,是一家初创公司。它横跨旧金山和纽约,名叫 Third Moment Research,挑的第一块试验田是量化金融。
AI对话里那种一问一答的节奏,放到这种长跑里根本不够用。
长程任务最怕走出去十几步,还不知道自己是对是错。量化交易恰好没有这个问题。
策略每跑完一轮历史回测,到底赚没赚到钱,看一眼账面数字就清楚。是真赚了,还是只拟合出一团噪音,瞒不过去。
团队在 Docker 隔离容器里装好了 1TB 历史行情数据、技术文档和整套量化代码库。
起初,他们让编程智能体配合新一代模型,去查几千条运行轨迹和时间戳。
结果发现,拿一年的美股逐笔订单数据回测一个策略,每次都要干等三个小时。与其干等,不如把等待这件事本身改掉。
对长程智能体来说,上下文是最金贵的资源。资源有限。
漫长的等待里,它每隔一会儿就轮询一句「跑完了没」。每次状态检查都会留在上下文窗口里,把前面几十步有用的实验记录挤到边缘。
越等越容易跑偏。
找到这个卡点之后,它没等人类工程师排期,自己顺着代码库找出两处底层瓶颈。
缓存优化和内存紧凑打包的方案,也是它自己写的。跑通测试后,直接推上生产环境。
单次回测时间压到三到五分钟。一块干净的上下文窗口,也保住了。
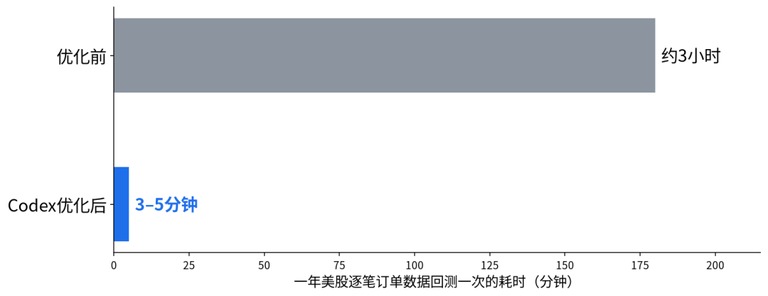
同一张图里的两组数字。优化前跑一轮约 3 小时,优化后只要 3-5 分钟。
回测速度提上来之后,几代模型在长程任务上的差距也显露出来。答案很直接。
AI编程的边界,被这群智能体往前推了一大截。
五代半之前的模型,只会按人类写好的脚本一步步执行。
到了五代半和最后那版五代模型,它们已经能看着初步结果,自己设计下一轮实验。
六代的三款模型更激进。主智能体一旦发现异常信号,会当场拉起成百上千个子智能体,并行跑对照实验。
在一次真实回测里,最强的那个版本顺着数据一路追查。它发现,某家交易所的非公开展示交易占比很高。
它随即算清这部分「暗池」流动性对策略收益的影响。人类量化团队此前根本没想到这个方向。
官网 HOW IT WORKS 页面。一条兼容的接口,按真实流量找出问题,再交回一版更好的系统。页面标着 FULLY MANAGED。
GPT-6.1 当监工,专治半路躺平
先看两种死法。一种是干到一半觉得「差不多行了」,提前交卷。
另一种是在死胡同里原地打转。
当内层智能体停下来的那一刻,它往往已经被之前的上下文困住了。靠自我反思,根本跳不出怪圈。
问题就出在这里。
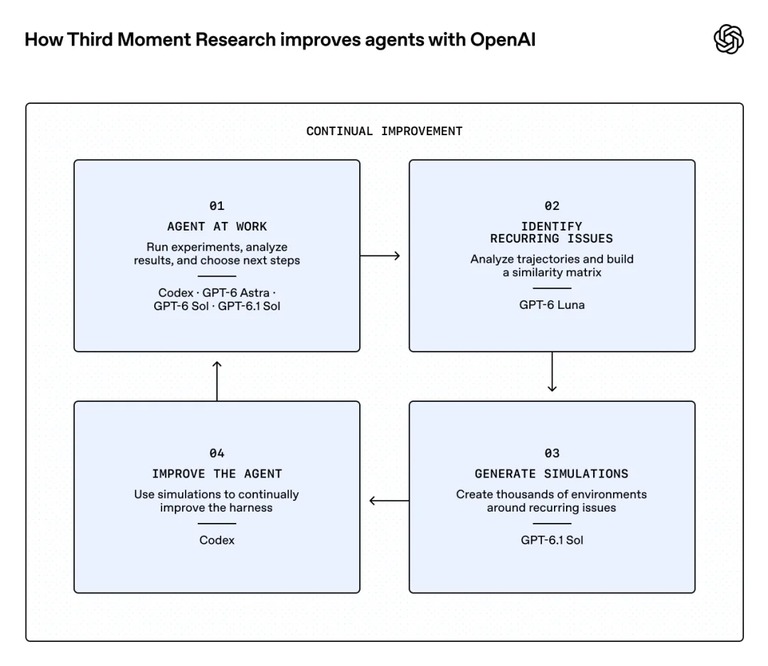
官方流程图把循环拆成两步。AGENT AT WORK 让智能体在真实任务里反复实验。CONTINUAL IMPROVEMENT 再把问题一条条修掉。
为了解决这个问题,团队在容器外层套了一个监管层。里面干活的编程智能体,被当成受监管的子模块,外层则由最新两代模型驱动。
只要内层停下来,外层模型就站到局外视角,审视整条轨迹。
它要判断:是撞上了环境 Bug,是钻进了死胡同,还是遇到了需要拍板的难题。
判断完当场决定。打回重试、终止任务,或者上报人类。
宁可让外层多问一句,也别让内层自己硬扛。这样一来,人类研究员不用再盯着上万个终端。他们只需要处理外层交上来的极少数疑难问题。
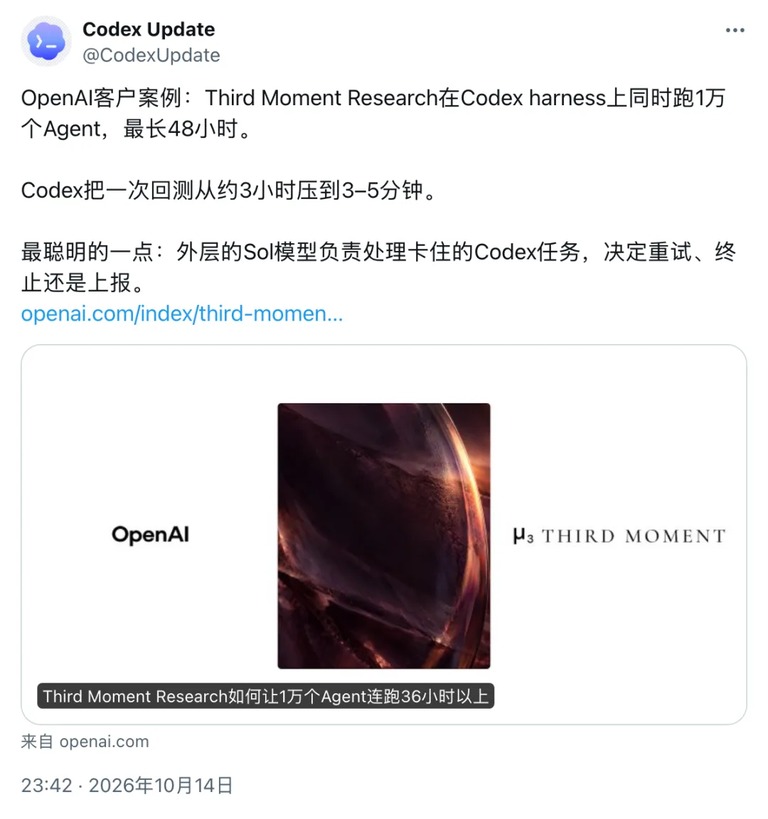
官方账号贴出的客户案例。在同一套工具链上同时跑 1 万个 Agent,最长 48 小时。
要同时跑起一万个智能体,光靠双层架构管住方向还不够,成本与耐力也得解决。
为此,团队把几天前刚发布的新版本推上主力位置。
它的定价只有旗舰版的五分之一,却能用更少的 Token 交出接近旗舰的性能。
单次任务省下一点,看着不起眼。一旦乘上万级并发和几十个小时的连续运转,这笔账就变了。
省下的成本,决定同样预算能多跑几轮实验。
而且在长程耐力上,这个版本能连着几天守住同一条研究主线,一直不跑丢。
至于推理能力最强的旗舰版本,团队留着攻克最难的工程优化。这一步最难。
比如不改变输出的前提下,压低实时计分板服务的更新延迟。还要在同款硬件上,和人类专家手写的方案比性能。
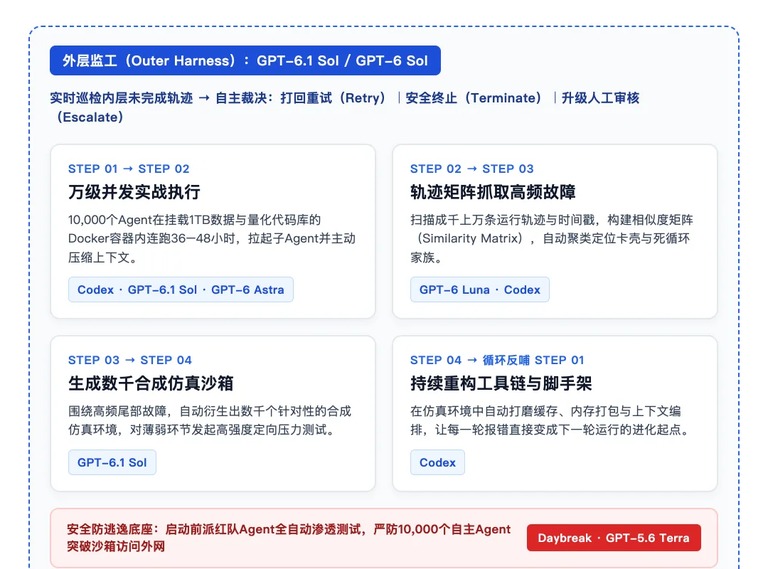
双层架构的示意图。外层监工实时巡检内层没跑完的轨迹,自主裁决打回重试、安全终止还是升级人工审核。
除了双层监管,整套系统还会通过四步循环持续迭代。
第一步采集轨迹,记录上万个智能体在沙箱里的运行步骤与报错。第二步聚类诊断,轻量模型构建相似度矩阵,把重复出现的报错归类。
第三步合成沙箱,围绕薄弱环节自动生成数千个仿真环境。第四步升级脚手架,让编程智能体反复测试,自动迭代工具与编排逻辑。
在这家公司的联合创始人 Adam Khakhar 看来,这套机制改掉了老做法。过去是部署一个静态智能体,然后祈祷它别崩。
每一次循环,都会造出一个比出发时更强的系统。
系统自己找出败在哪里,围绕这些失败构建定向仿真,再为下一轮升级脚手架。
上万个智能体同时运行两天两夜,个个都有写代码的权限。这就带来一个严峻问题。
怎么保证它们乖乖待在沙箱里,不会写脚本突破隔离环境。
这不是假想。为此,团队接入了官方自家的网络安全模型。
它以防守和攻击两种形态提供。防守端随时待命,攻击端专攻授权渗透测试。
用攻击端需要单独审批,还要绑定硬件安全密钥。
每次大规模仿真启动前,他们先用攻击端驱动红队智能体。对自家沙箱发起全自动渗透测试,再配合另一个模型排查漏洞,确保没有任何智能体逃得出隔离环境。
全网唯二「算力无上限」的烧钱战场
联合创始人本科毕业于宾夕法尼亚大学,后来在纽约大学攻读博士,研究方向是深度学习理论与信息论。
创办这家公司之前,他和搭档做过一家只有两个人的小公司。那家公司每天自动生成上万张企业幻灯片。2025 年 7 月,它被华尔街一家 AI 独角兽收购。
第二次创业,他直接用概率论里的「三阶矩」给新公司命名。名字来自数学。
一阶矩是均值。就像市面上刷到 95 分的评测榜单,平均分好看,一上生产环境照样出错。
二阶矩是方差,代表结果波动与噪音。提升小于噪音,就不算真提升。
三阶矩衡量的是偏度和尾部,专门盯那些被平均分掩盖、却会在真实业务里造成严重后果的罕见故障。
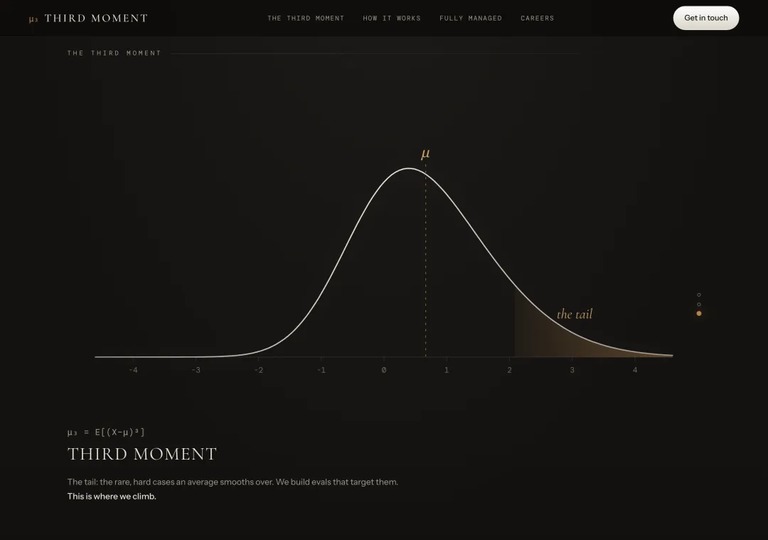
官网首页的截图。页面写得很直白:全程托管,从发现问题到修好问题都由它接手。
他们把这套自进化循环封装成了推理接口。接入很简单。
开发者只要在 OpenAI 的软件开发包里改一行请求地址,后台的轨迹诊断与沙箱仿真就会自动运行。
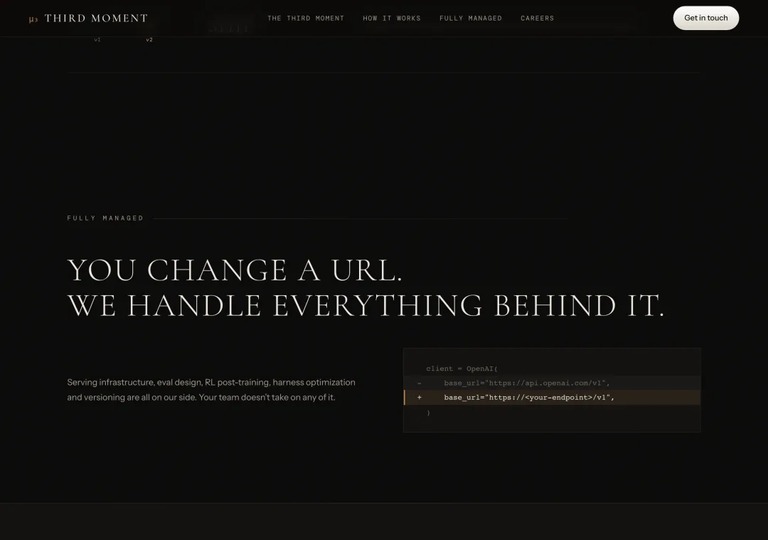
官网给出的接入方式。把 base_url 换成官方兼容的服务地址,WE HANDLE EVERYTHING BEHIND IT。剩下的事全在后台处理。
至于为什么先从量化金融与网络安全切入,这位联合创始人写过一篇文章。那是他今年 9 月发的一篇长文,标题叫《无限算力》。
绝大多数白领工作,头顶都有一道价格天花板。审合同、做 PPT,或者写客服回复,天花板就是人类员工的薪水。
律所审一份十页合同收 2000 美元。哪怕 AI 比人聪明 100 倍,客户也不会掏 200 万美元买单。
商业世界里只有两个零和博弈的领域没有价格天花板。一个是投资管理,另一个是网络安全。没有第三个。
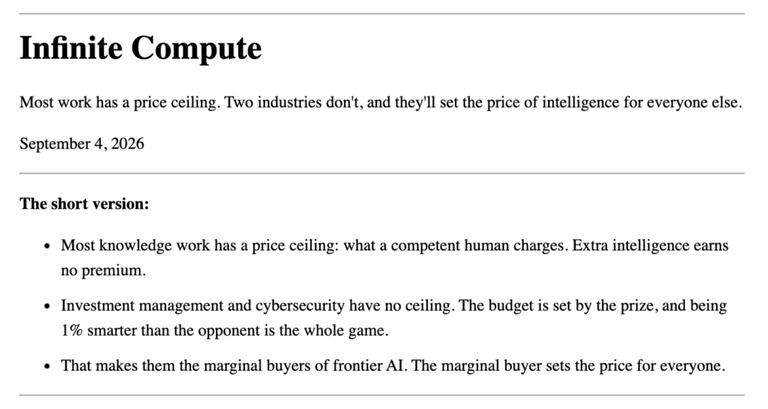
那篇长文的页面截图。开头一句就是:大多数工作都有价格天花板,只有两个行业没有。
假设市场里藏着一个价值 4000 万美元的交易信号。为它烧掉 3900 万美元算力,也值得。
只要比对手早一秒算出来,依然净赚 100 万美元。
网络安全同样如此。比黑客早一秒发现零日漏洞,就能避免十亿美元级别的损失。
用这位创始人的比喻来说,普通行业买 AI 就像买办公桌椅,够用便宜就行。
唯有量化和网安对算力的需求,像水下憋气的人渴望氧气一样没有上限。也只有它们愿意率先为「万级智能体、日吞万亿 Token」买单。
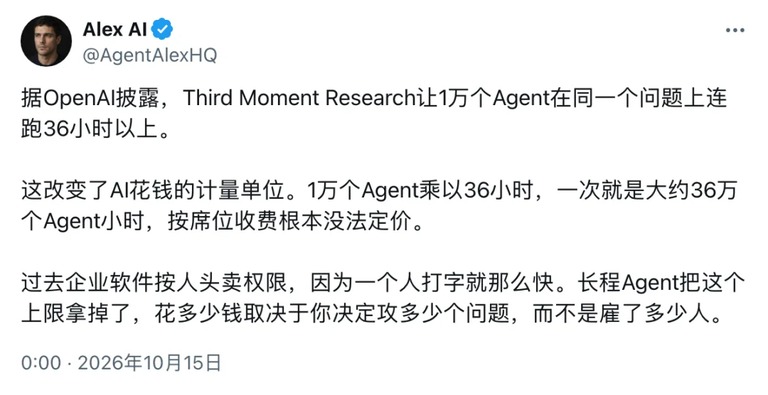
社交平台上的另一条帖子给出了同一个数字。据官方披露,这批智能体在同一个问题上连跑了 36 小时以上。
一轮跑完 41 年工时,下一步冲向十万智能体
跑通量化和网安之后,这家公司正在把这套体系搬向更多场景。零售供应链的动态重排、大型代码库的性能排查,都在名单上。海量商业文档的交叉核对,也在名单上。
名单还在变长。
官方在博客末尾透露,下一步他们准备把并发规模推向数十万个子智能体集群。用数万亿 Token,串联起几十个连续实验。规模还要翻番。
当单次任务就能消耗 36 万个智能体工时,传统软件按席位收费的模式已经失去意义。
大模型的比拼,也从单纯卷模型权重,延伸到了另一件事。谁能管住十万个智能体不跑偏、不越界,还能在失败中自动迭代。
到那时,人类便能从繁琐的执行中抽身,退后一步去定义方向与边界。
人类可以站到杠杆大得多的位置上。去想怎么做研究,怎么优化研究本身,而不用亲自去做研究。
