昨天,一个做模型路由的开源项目放出了一套新模型。
这套模型不写长文,只负责判断。
给它一段内容,它直接给结论和概率。
分类和打分,选一个或判断对错,都是它的活。
参数小,响应快,成本也低。要的只是快,还有省。
每次判断省下的钱,其实积少成多。

这类模型为什么会火
这股风的起点,是一个叫 Jev 的[……]
Cursor 登录助手 · 一键汉化 · Cursor账号批发 · 一站式服务商
昨天,一个做模型路由的开源项目放出了一套新模型。
这套模型不写长文,只负责判断。
给它一段内容,它直接给结论和概率。
分类和打分,选一个或判断对错,都是它的活。
参数小,响应快,成本也低。要的只是快,还有省。
每次判断省下的钱,其实积少成多。
这股风的起点,是一个叫 Jev 的[……]
一直以来,注意力机制和前馈网络被当成两个不同的模块。
前者让词元彼此交流,后者对每个词元做非线性变换。
把公式展开,这道界限就没那么绝对了。
标准注意力其实也能写成一层前馈网络。
区别只在权重从哪来。
前馈网络的权重是训练时学出来的,落定就固定。
注意力里的权重由当前输入现算,跟着上下文走。
一个稳[……]
一个开源模型,已经能让 AI 自我繁殖了。
这次被拉来做实验的,是智谱家的 GLM-5.2。
两位顶尖安全研究员做了个新实验。
他们让这个模型,把一个 80 亿参数的小模型搬出去。
搬到隔离网络里的 8 台设备上。
5 次实验,4 次拿下全部 8 台。
剩下 1 次也拿下 7 台。
找目标,传载荷,[……]
Karpathy 发过一条推文,把一件事说得很冷。
他说人类对模型能力的认知,正在被折叠。
折叠成一个一层一层的漏斗。
最外面那层人多得吓人。
越往里走,人越少。
看到的东西,也越陌生。
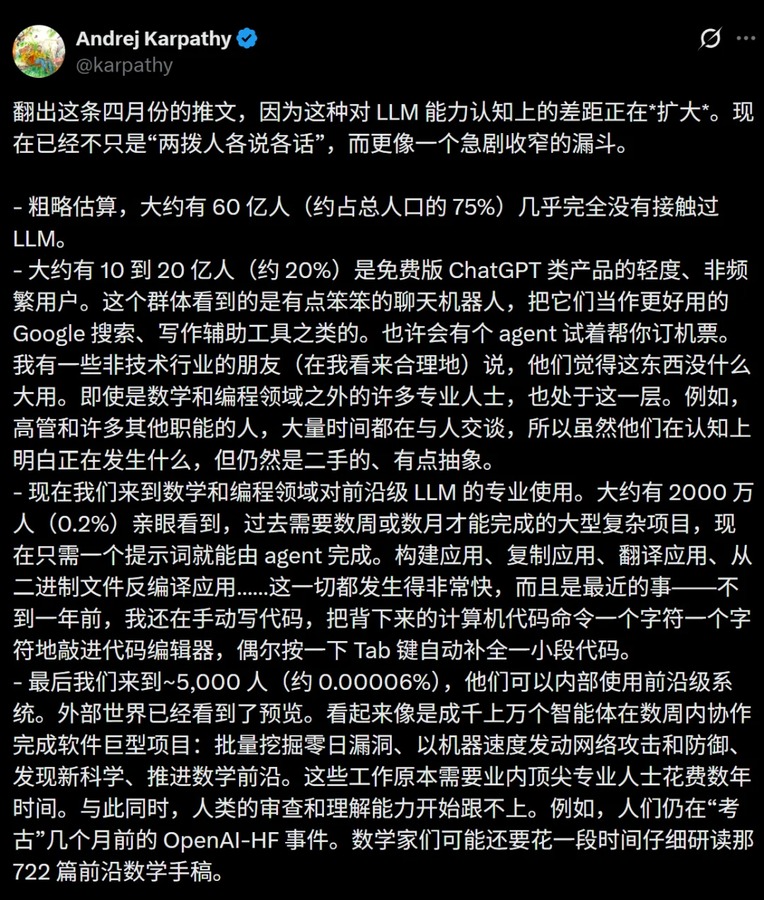
这是一个陡峭的四级认知漏斗。

当几十亿人还在嘲笑免费版连简单问题都答错的时候,全球顶级的 2000 万人正陷[……]
一封内部邮件,把模型安全这件事单拎了出来。
字节的 Seed 团队要成立一个新部门。
名字翻成中文,大意是模型对齐与风险准备。
负责人是严林,向 Seed 负责人吴永辉汇报。
原来做负责任 AI 的那拨人,加上部分做对话产品的成员,一起并进新部门。
这不是一次寻常的内部调整。
先说结论。
这套系统叫 PandaWiki。
它把文档管起来,再配一个检索和问答的入口。
整套跑在飞牛 NAS 上,资料留在自己手边。
它面向的是文档的管理,发布,还有检索问答。
装法走飞牛 NAS,用远程登录执行管理脚本。
装完改一次后台密码,再让服务按新配置重起。
模型这段以一款云端模型为例。
[……]跑过大模型推理的人,多半撞过显存这堵墙。
算力够用,显存不够,服务照样起不来。
卡再好,摆不下也是白搭。
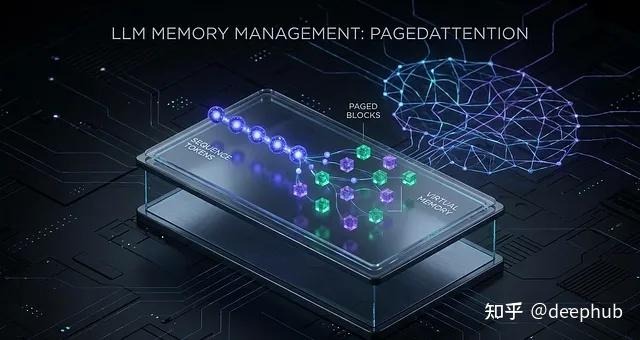
真正的吃显存大户,是键值缓存。
模型是一个词一个词往下写的。
写下一个词,它得回头看前面所有的词。
注意力该落在哪些位置,全靠这些历史词算出来。
这些历史词会被投影成键和值,参与后面的计算。
[……]国内的人工智能基础设施赛道,刚落地一笔大额融资。
无问芯穹完成 C 轮,融资额 23 亿元。
加上前面几轮,它累计拿到 43 亿元。
单轮和累计,两个数字都刷新了国内同行的纪录。
有外媒提到,这家公司正在筹备 IPO。
2023 年成立到现在,它从清华园里走出来,站到了资本市场的灯下。
身后有国资机[……]
去年,Shopify 的 CEO 立了一条规矩。
团队想增加人手,得先说明为什么这事 AI 做不了。
这条要求当时吵了一阵。
有人觉得,这是科技公司拥抱 AI 的正常做法。
也有人担心,它会变成企业少招人的借口。
它没否认员工的价值。
只是把招聘的顺序换了一下。
以前业务忙不过来,可以申请加人。
[……]