

昨天,一个做模型路由的开源项目放出了一套新模型。
这套模型不写长文,只负责判断。
给它一段内容,它直接给结论和概率。
分类和打分,选一个或判断对错,都是它的活。
参数小,响应快,成本也低。要的只是快,还有省。
每次判断省下的钱,其实积少成多。

这类模型为什么会火
这股风的起点,是一个叫 Jev 的模型。
上线三天,词元用量就冲到了一万亿。
上线二十四天,开发商拿到八点七亿美元融资,估值七十五亿美元。
换算成人民币,大约是五十八亿元和五百零二亿元。
领投的是一家老牌风投。
这个用量,比不少通用大模型的调用还猛。投资人看中的是场景,不是跑分。
判断类的活,本来就比生成更日常。
在这之前,这类活多半交给通用大模型去办。
把一段话丢过去,让它回一个词,成本和延迟都不划算。
十月十日,微软也推出了自己的决策模型。
它用千问的一个小版本微调,能对预设选项打分,给出置信度。
工具选择,模型路由,流程控制,都能用上。
这次开源的这套,一共六款。
参数从六亿到二百七十亿,权重都放上了开源社区。
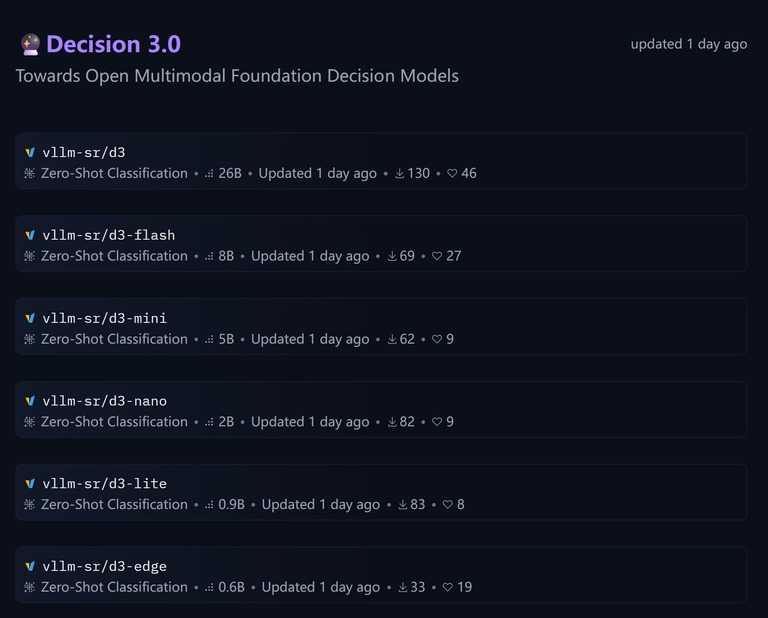
排在头里的旗舰款,是全场参数最大的一个。
它用千问的新版本打造,是个多模态模型。
一次能读多张图片,也能读视频。
另外五款铺开全档位,用的是不同规模的老版本。
和 Jev 不同,它把权重直接公开。
谁都能下载到本地跑,不必把内容传给云端接口。图片和视频也一样在本地处理。
权重公开,意味着模型能离线跑。数据不出门,这在企业里是硬需求。
想省算力就换小档位,想追效果就上大档位。
榜单成绩是最直观的对比。
在决策榜里,旗舰款文本得分六十四点七,公开集六十五点五。两项都排第一,超过了 Jev 的六十点一。
另外三款也压过了微软决策模型的五十三点二。
差距不小。
视觉榜上,旗舰款拿下七十一分六,同样是第一。一个九十亿参数的轻量版,两榜都进了同规模前列。

实测和榜单把差距摆了出来
第三方也没闲着。
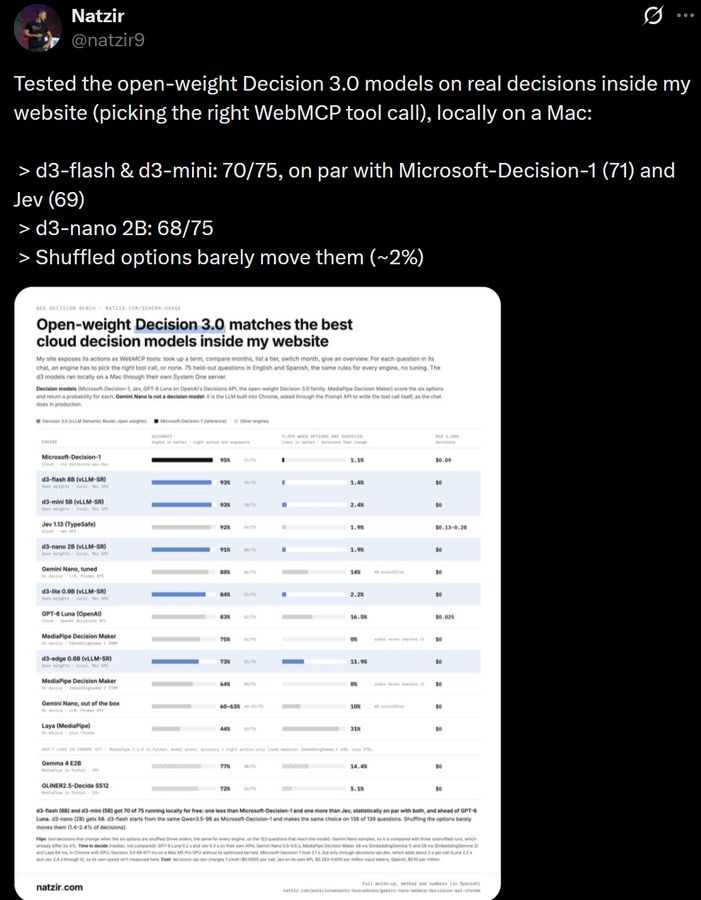
一位开发者在自己网站上出了七十五道工具选择题。
题目是让模型判断,这一步该调用哪个浏览器工具。
在本地苹果电脑上跑,微软那款答对七十一题,排第一。
两个轻量版答对七十题,并列第二。Jev 答对六十九题,更小的一个答对六十八题。
它被设计来干的活很具体。
客服分流和内容审核都用得上,风险识别和模型路由也是。
举个例子更容易懂。
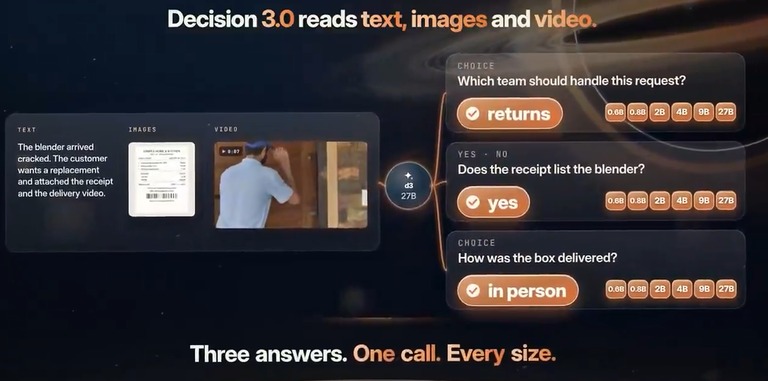
客户说收到的搅拌机破了,想换货,还附了收据照片和配送视频。
模型一次请求就能答三个问题。
该由哪个团队接,收据里有没有这台机器,包裹又是怎么送到的。
它给出的答案,分别指向退换货团队、肯定答复和当面送达。
快,而且能跑在本地
速度是另一个看点。
在单张数据中心显卡上,纯文本请求的延迟中位数是五十五毫秒。带图片的请求两百七十三毫秒,十秒视频五百五十三毫秒。
这已经落进了能实时响应的区间。
够用了。
还有人把它里最小的一档,用端侧框架放进了苹果笔记本。
让模型对着上千条代码合并请求做分组和路由。
整批跑完大约两分钟。单条平均零点一二秒,每秒能处理八点三个。
全程在本机完成,没调一次云端接口。
省下来的都是钱。
结语其实很简单。
用户想干什么,这是什么任务,该走哪条模型,这些判断每天都在发生。
通用大模型去干,贵且慢。把这批专做判断题的小模型放在前面,让它先看意图,再把活转给更合适的模型。
多模型系统就能少花推理钱,也答得更快。
说到底,这类模型最后都会藏进我们天天用的 AI工具 里。
不显眼,却决定了 AI对话 顺不顺。
至于 AI编程,前面多一道判断,后面就少走弯路。
