

智谱又放出一个新模型。
这回不是更大的旗舰。
是跑得更快的那个。
它挂在智谱自家的 AI工具 里,没单独开发布会。
官网首页也找不到它的位置。
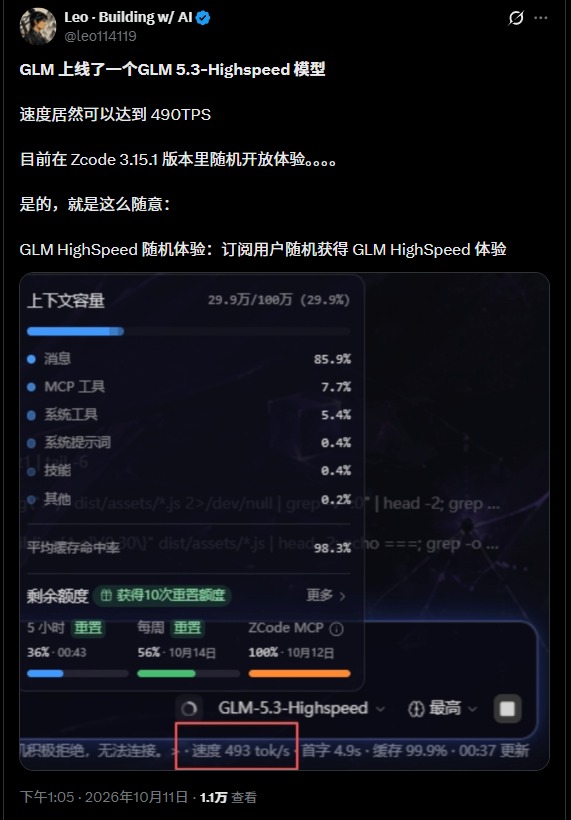
最先发现它的人,是一名编程博主。
这位博主在 X 平台上挺活跃。
他说自己在智谱的 AI编程工具 里,灰度到了这个模型。
实测的输出速度,直接冲过每秒 490 个词。
490 是个什么概念。
得拿别家放一起比才看得清。
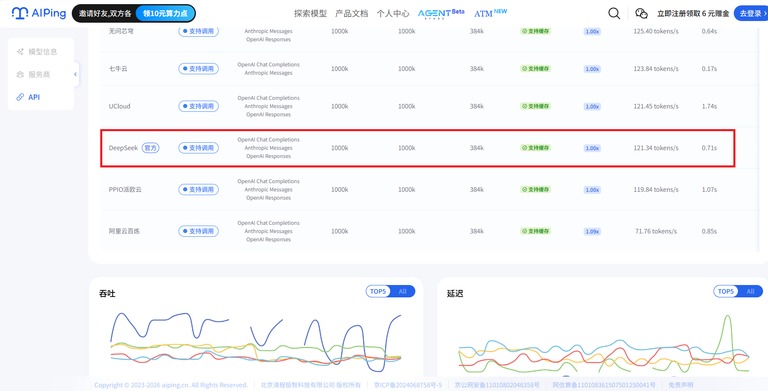
有评测平台记过各家接口的实测速度。
一款国产模型的官方接口,每秒吐 121 个词。
智谱自己那版常规旗舰,每秒 70 个词上下。
这么比下来,高速版是好几倍的快。
同一家的常规版本,被自家新品甩开了四五倍。
只是这个数字出在内测里。
稳不稳还得再看。
这模型眼下只对订阅用户随机开放。
没有申请入口。
也看不到明确的测试名单。
等它正式对外放量那天,才算见真章。
它其实不是第一次这么干。
一个月前,这个名字就出现在一个开源编程智能体项目的官网上。
当时价格一个字都没提。
连一张像样的宣传图都没有。
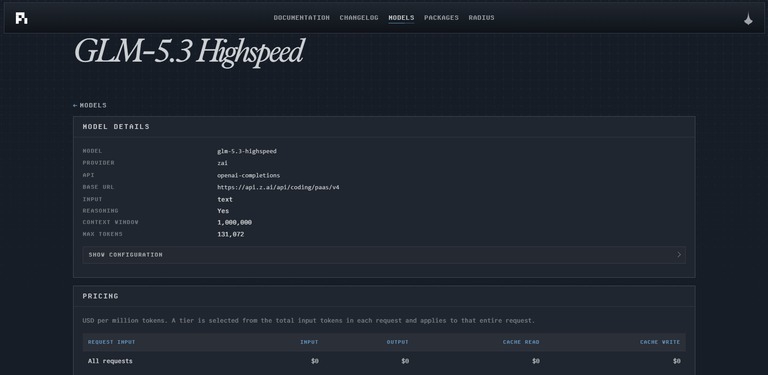
从公开的模型信息看,它的底子和常规旗舰一样。
上下文窗口能装下一百万个词。
一次最多能吐出十三万多个词。
这组参数,和常规版本对得上。
再往前翻,今年五月智谱就试过一回。
那回的型号是 GLM-5.1,也做了高速版。
面向一部分企业客户,速度做到每秒 400 个词。
当时智谱把高速模型的价值讲得很直白。
这种任务跟一次 AI对话 不一样,它要来回调用几十轮。
单轮慢上几秒,整件事的耗时就得多拖十几分钟。
反过来,模型跑得快,写代码就像被按了快进。
用户刚把需求敲进去。
函数,接口,调用链已经一起铺开。
模型一边读工程上下文,一边接着往下写。
它先把改哪儿看明白,再动手。
这种手感,靠的是软硬件底子,不是单点调参。
那版高速接口,是智谱团队和一家做推理加速的团队联手做的。
两边在三个层面动了刀。
最底下是推理引擎,针对模型结构重写了核心路径,让单张卡一次能多干些活。
中间是调度系统,靠动态批处理、请求合并和缓存调度,把高峰期的尾延迟压下去。
最上面是基础设施,围绕集群部署、网络链路和负载均衡做协同。
三层叠起来,速度才稳得住。
那家推理加速团队的路子更狠。
它干脆不要传统运行时的动态调度。
把整张计算图在编译阶段就固定下来。
编成一个常驻显卡的内核。
调度,访存,同步三块开销,一下全压到最低。
少了来回倒腾,显卡的时间就都花在算上。
如今盯着模型速度的厂商,不止智谱一家。
有的专门做一款快模型,只求快。
有的把旗舰的速度再往上抬一个量级。
跑得快这件事,正从附带指标变成主赛道。
谁能先把速度稳住,谁就多一分胜算。
