

大模型最擅长的事,是写字。
它能答,能编,也能总结。
可它自己不会联网,不会查库,也不会跑一段代码。
想让模型动手做事,中间得有人搭一层接口。
这层接口用一个词概括,就是工具。
工具把外部能力包成模型能看懂的函数。
模型负责说要不要用,用哪个,传什么参数。
真正去执行的,还是我们自己写的代码。
搞懂这层接口,等于看懂了智能体干活的全过程。
在 LangChain 里,这层接口就叫 Tool。
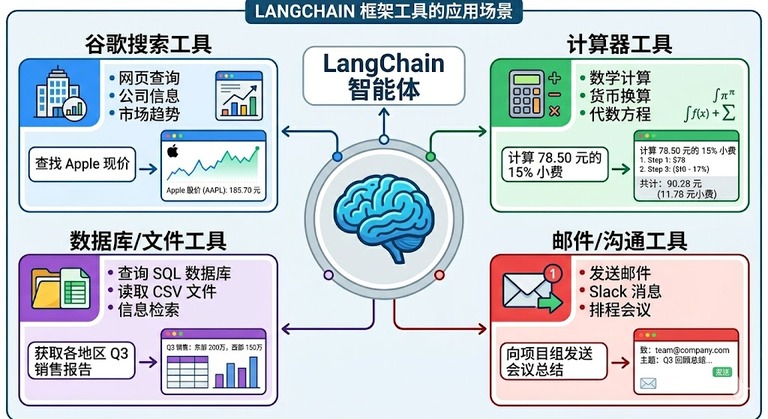
图里把工具的分支摊开了。
有搜索,有计算,有数据库和文件,也有邮件。
工具不是随便一个函数。
它由三块拼起来。
一个是名称,用来唯一标识。一个是描述,模型靠它判断什么时候该调。
还有一个是功能,也就是真正执行的代码逻辑。
三块里最要紧的,是中间那块描述。
几个相关工具打包在一起,就成了工具包。
那工具到底能带来什么。
它给各类 AI工具 把能力边界往外推了一圈。
想知道最新消息,可以让它接搜索工具。要算得准,可以给它计算器。要读私有资料,可以接数据库或者文件工具。
一句话,工具是模型伸出去的那双手。
工具还有几个特点。
它靠描述驱动,模型完全依赖描述决定调不调。它走标准接口,所有工具共用一套方式,方便替换。
它也好扩展,一个装饰器就能把普通函数变成工具。它还能组合,多个工具一起交给智能体,由它按需调度。
用得最多的是这几类。
查实时信息的配搜索,补百科的配维基查询。要算数的配代码执行,要翻库的配数据库工具包。
任务一复杂,就把多个工具一起交出去,让它自己拆。
让模型自己调用,才是主流的用法
在 LangChain 里,工具本质上是输入输出都写清楚的函数。
所以工具调用,也叫函数调用。
调用的路子主要有两条。第一条是直接调,适合自己测试。
先定义一个小函数,用装饰器把它标成工具。
再自己把参数传进去,拿到一句返回。
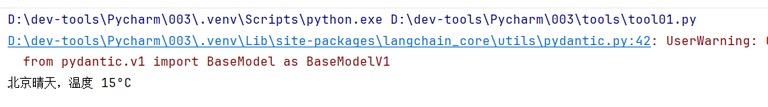
另一条是把工具绑到模型上,让它自己决定。
这是开发里用得最多的一条。
做法是先初始化一个模型,再把工具塞给它。用户问一句天气,模型自己判断要不要动手。想调工具,返回里就会带上一段调用信息。
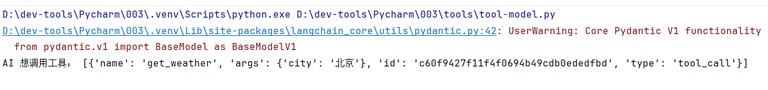
模型能根据上下文,决定何时调工具,以及传哪些参数。
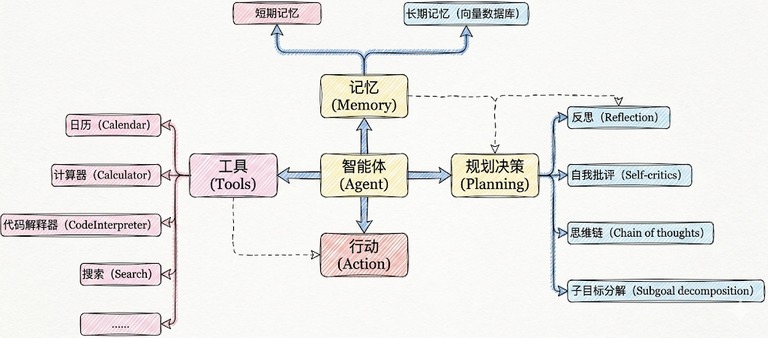
刚写的那段应用,正好对应图里的那个助手。
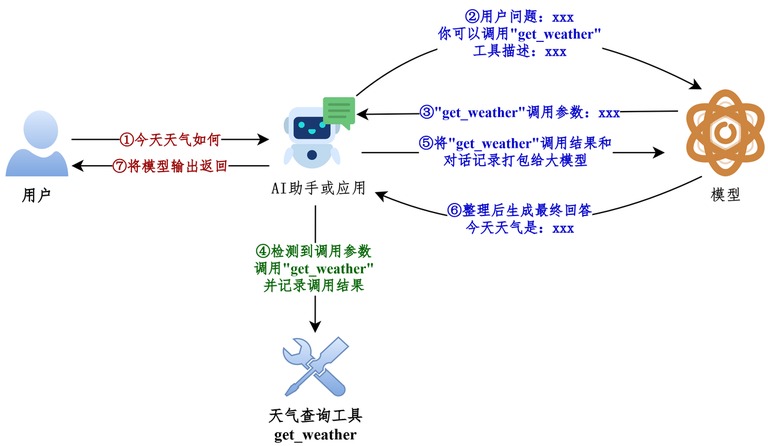
那工具在代码里是怎么走完一轮的。
把消息的流转拆开看,会清楚很多。
先说不加装饰器的写法。
这时工具只是一个普通函数。
用户问一句天气,消息列表里先多一条人类消息。
模型读过之后,返回一条带调用信息的响应。
这条响应本身也是一条消息,需要我们自己接回列表。
于是列表里就有了一问一答两条。
接着还要手动拼一条工具消息,里面装着工具的执行结果。
拼好之后,再把它也塞回列表。
最后把整串消息重新交给模型,让它生成最终答复。
到这一步,模型才真正把工具的结果讲成人话。
整个过程里,执行工具的那个动作,一直捏在开发者手里。
这也是它和装饰器写法最大的区别。
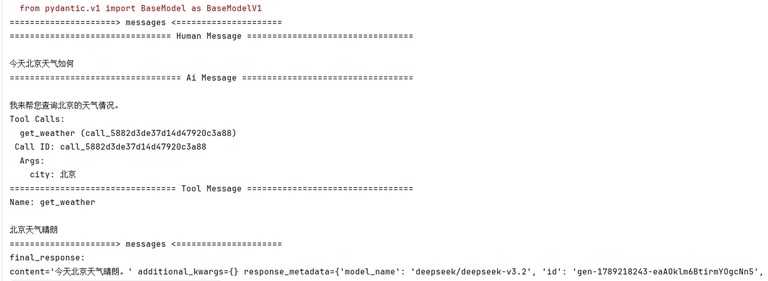
上述代码对应的完整调用流程,就是下面这张图。
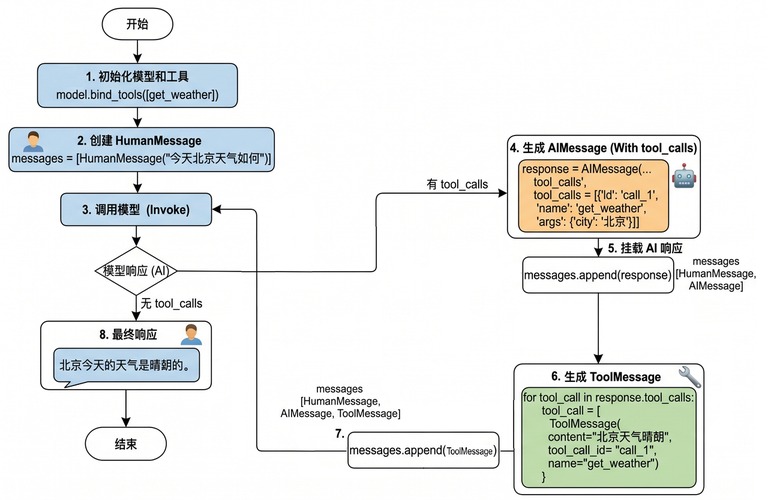
改用装饰器之后,省事不少。
被装饰过的函数,自己能接住模型给的入参。
执行完,它直接返回一条工具消息。
不用我们再手动拼。

完整的一轮,其实分四步。
第一步,把工具绑到模型上。
第二步,模型生成工具调用请求。第三步,由开发者手动执行工具。
第四步,把执行结果送回模型,生成最终答复。要注意,模型调工具只是一次推理。
真正执行工具,管理循环,还在开发者这边。
描述写得清不清,决定模型调得对不对
模型绑工具的时候,底层会做一件事。
它最终会调一个转换函数,把工具翻译成一份描述。
这份描述长什么样,直接打印出来就能看到。

描述由几个字段拼成。
有一种字段管类型,说明这个节点该是什么数据。常见的有字符串,数字,整数,布尔,对象和数组。
另一种字段管属性,说明一个对象里能放哪些键。还有一种叫必填,列出对象里必须出现的属性名。
把这几块看明白,一份工具描述就看懂了大半。
有个地方容易让人犯迷糊。
为什么没加装饰器的函数,也能当工具用。看底层代码就明白,它分了两条路走。
带装饰器的走一条,普通函数走另一条。后者会根据函数定义和文档字符串,自己生成一份参数模式。
转换函数会从文档字符串里取描述。
上面的例子里,文档字符串是空的,描述也就是空的。
把说明用三个引号包起来,再跑一次。
描述字段里就有内容了。
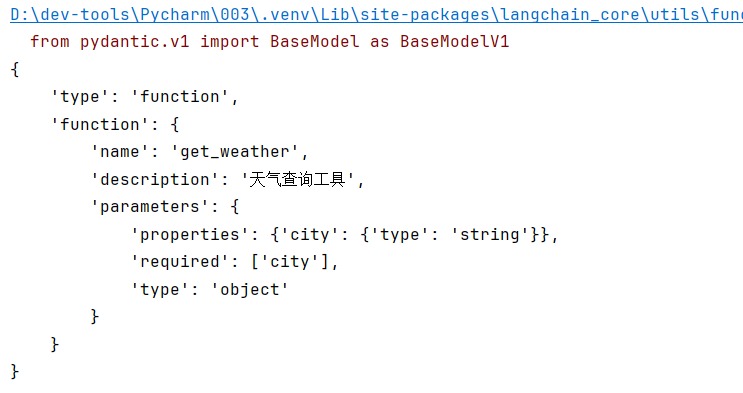
文档字符串还得按谷歌的风格写。基础用法不用去啃规范,照示例仿写就够。
写清楚之后,参数的详细信息会一起被抽出来。
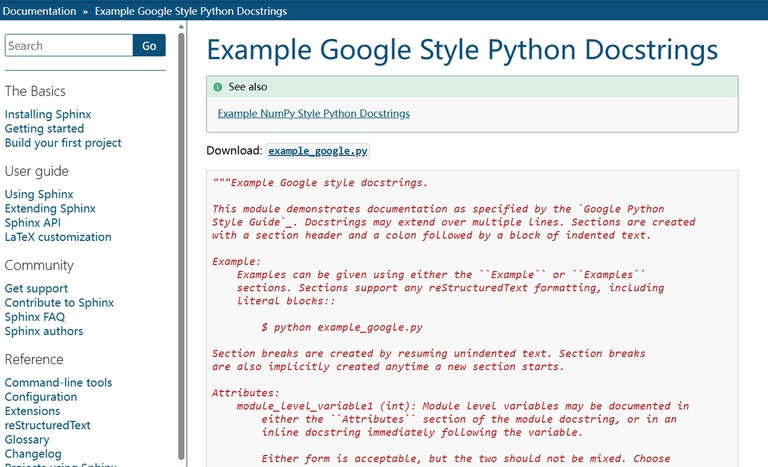
各参数的说明,这时就都出来了。

用参数,返回,报错这几个关键字分段,可读性会好很多。
模型就是靠这些注释,理解工具的用途和调用时机。
所以一份准确清楚的文档字符串,是工具能被调对的前提。
这一点在 AI对话 类应用里尤其明显。
参数的类型,来自函数上的类型注解。
把类型注解删掉,描述里也就没有类型说明。
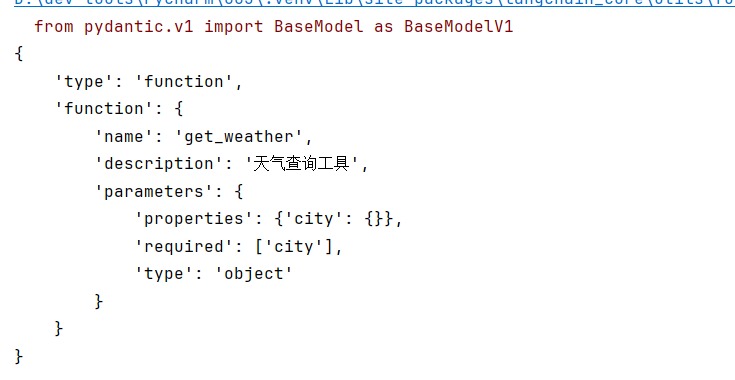
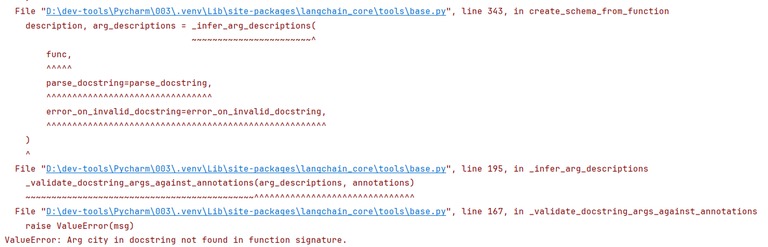
这里还有一个坑。
文档字符串里写了某个参数的说明,那个参数就必须有类型注解。
不然直接报错。
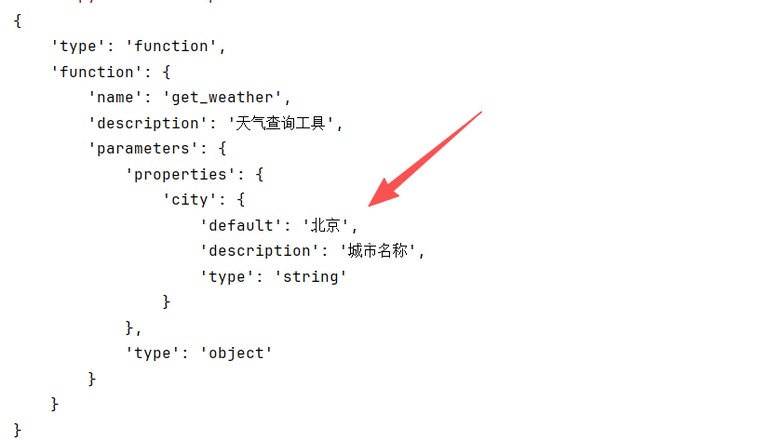
再看默认值。
参数没有默认值,就会进必填列表。给了默认值,描述里会多出一个默认字段,并且不再进必填列表。
在输出的结果里,就能看到这个默认值。
接下来是装饰器。
它最直接,代码量最少,适合快速验证想法。
只是有个硬要求。
函数得有文档字符串,或者显式给一段描述。
缺了,运行直接报错。
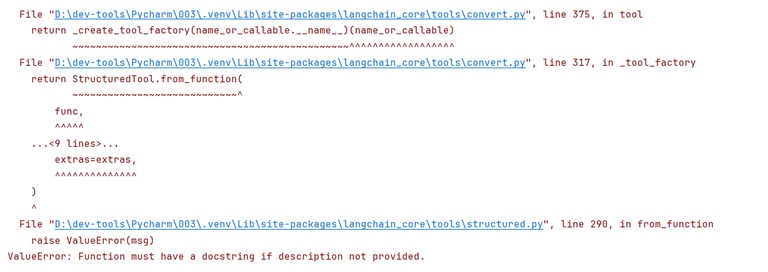
补上一段说明,就正常了。

小结一句。
绑定时,函数会先被包成一个工具对象,再交给转换函数生成描述。
装饰器会从文档字符串里取描述,同样要求按谷歌风格。
没有文档字符串,就会抛错。
装饰器的描述参数,优先级高于文档字符串。
传了它,输出里就会用它。
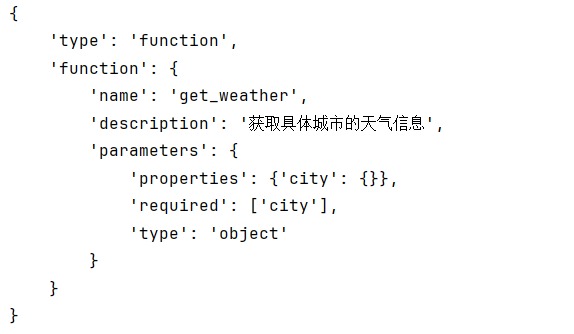
文档字符串还可以被解析。
不给描述时,工具会把整段文档字符串当成描述。
把解析开关打开,它就会被拆开,填进对应字段。
文档字符串不合法时,装饰器会直接抛异常。

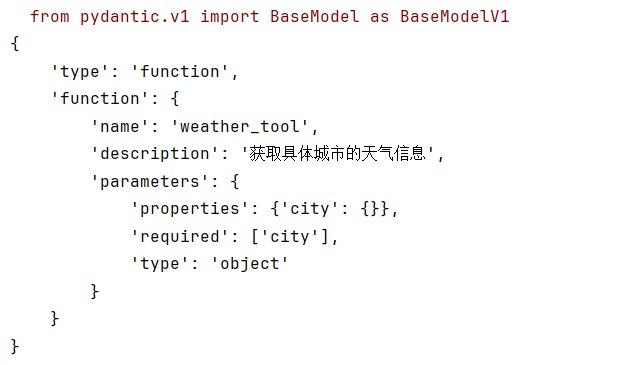
工具名也有讲究。默认用函数名当工具名。也能传参把它改掉。
虽然能改,开发里还是习惯用函数名,不太推荐自定义。
参数怎么定,决定调用能不能做对
参数一复杂,就该上数据模型了。
比如要枚举值,要范围限制,要更细的校验。
用数据模型的好处,是能精确控制参数的格式和校验规则。
让模型更准确地理解怎么调,这在 AI编程 里也更关键。
先定义一个模型类,声明字段和类型。再把它挂给装饰器。
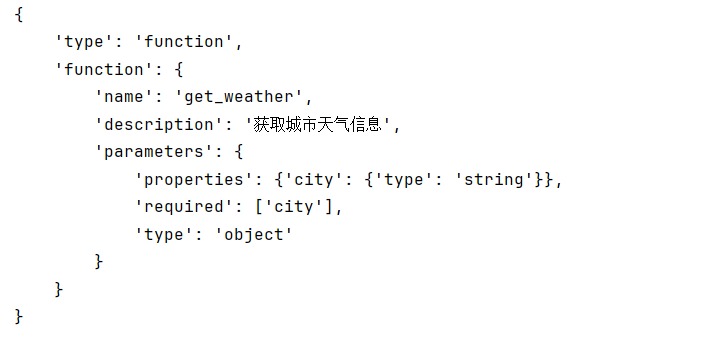
模型里还能补更多信息,比如描述和默认值。
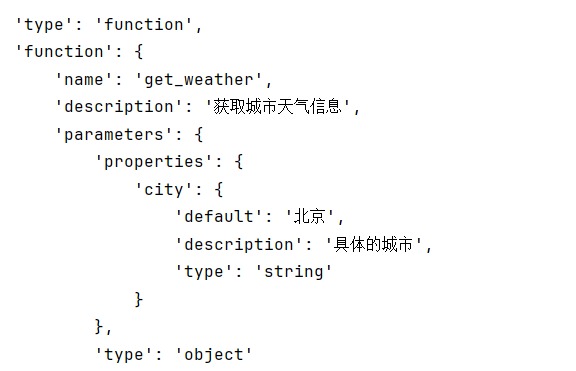
有时候为了安全,会把取值卡死在几个固定选项里。
用一个字面量类型,就能把参数限定成几个值。
比如单位只能是摄氏度,或者华氏度。
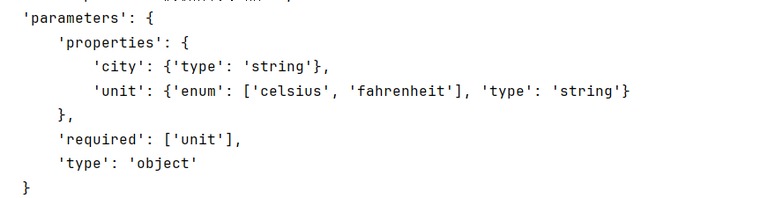
最后还有一种写法。
直接用一份结构化的数据来定义参数。
它的灵活度最大。因为这份结构可以在运行时,按配置或者用户输入动态生成。适合参数结构不固定的场景。
写法跟前面一致,效果也一样。

到这里,这套接口就讲完了。
一句话收个尾。
模型只负责判断,真正动手的始终是那层接口。
把描述写清楚,把参数定明白。
它才不容易调错。
