

好家伙,字节把生成式 AI 玩成了开放世界。
一句提示词丢进去,模型当场搓出一个房间。
镜头压得很低,像小人站在地板上抬头看。
键盘鼠标一顿操作,人就能骑着纸飞机在里头自由飞。
想去哪就去哪。
想要个勺子,随手就能凭空造一个。
造完还能顺着勺柄往上爬。
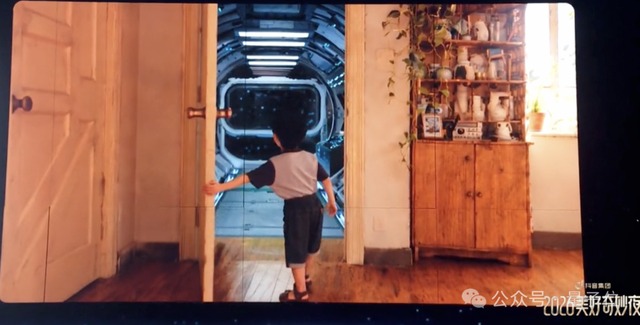
更离谱的是任意门。
屋里推开门,一步跨进外太空。
这一幕不在实验室,在一场科技节目的现场。
演示的人,是影视飓风那位 Tim。
他手里的东西,是字节默默做了很久的世界模型。
模型还没正式发布。
但现场露的这一手,已经把三维场景生成,自由探索,实时交互全摆出来了。
连物体都能随手编辑。
不同空间之间还能互相打通。
这是它第一次公开亮相。
一、从画图到造世界,中间隔着一道坎
先说个感慨。
从李飞飞那家公司,到谷歌 DeepMind 的 Genie,再到英伟达的 Cosmos。
巨头们早就下场了。
它们想让模型看懂空间结构,摸清现实规律。
甚至预判环境会怎么跟着人的动作变。
我猜,最早玩生成式 AI 那批人,压根没想到会有今天。
早几年那些 AI工具,最多帮你修张图,剪段视频。
现在它开始动手造一个空间。
AI 生成的视频,居然能变成一个三维世界。
人走得进去,还能随手改。
我这大半年上手过的世界模型产品,怎么也有六七个了。
震撼程度大概是这样。
前一天还在看《星际穿越》,第二天发现自己能走进银幕。
顺手还能把黑洞搬回客厅。
那问题就来了。
AI 是怎么从画图,剪视频,滑到造世界这一步的。
要回答这个,得先看传统多模态生成的一块短板。
世界模型现在有好几条路线。
抽象状态预测算一条。
物理因果建模算一条。
生成式三维世界又算一条,各有各的侧重。
这篇只聊其中一条,跟多模态生成和空间智能最近的那条。
让模型学会现实世界的空间结构,还有它怎么变。
学会了,它才能生成一个能一直逛的三维世界。
能重建,能模拟,还能实时交互。
这里有两个关键词。
空间结构。
变化规律。
偏偏就是这两样,卡了视觉生成技术好几年。
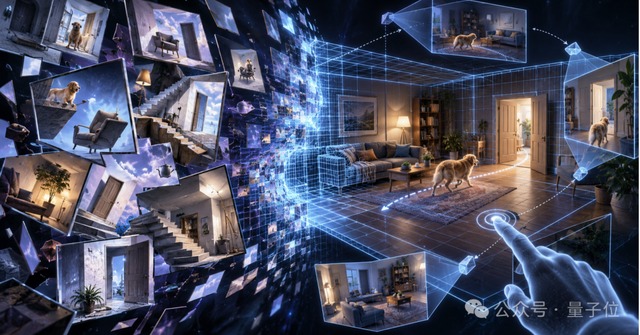
2024 年,Sora 出来的时候,全网都惊了。
比那些刷屏视频更值得细品的,其实是它同期那份技术报告。
标题直译过来,就是作为世界模拟器的视频生成模型。
那时候就有发现。
视频生成模型的规模一大,就开始冒出三维一致性。
物体能保持存在,简单交互也能模拟。
尴尬的是,画面做得再真,最基本的物理关系照样可能处理不好。
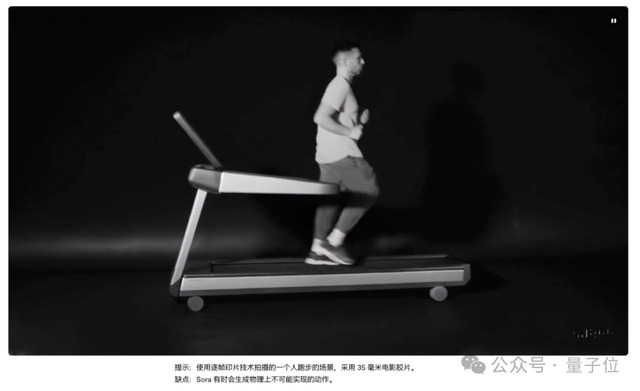
Sora 能生成一个人在跑步机上跑。
人物,光影,镜头,看着都对。
可人跟跑步机之间的运动关系,未必符合现实里的物理逻辑。
这背后是件挺根本的事。
过去这些年,主流做法都是学海量视觉数据里的统计规律。
不管是扩散模型,还是基于 Transformer 的架构。
这套方法很成功,甚至隐式学到了部分三维几何和物体关系。
但视觉上的时空连续,不等于一套稳定、能被外部动作干预的世界状态。
让杯子在视频里保持长相一致,对现在的模型已经不难。
可它被拿起又放下,甚至推到桌边的时候,模型还得持续追踪位置。
物体关系要盯住,碰撞和坠落也要预测。
换句话说,从生成一段符合直觉的视频,到可靠预测动作引发的环境变化,中间隔着一个世界状态建模问题。
而这正好是世界模型擅长的地方。
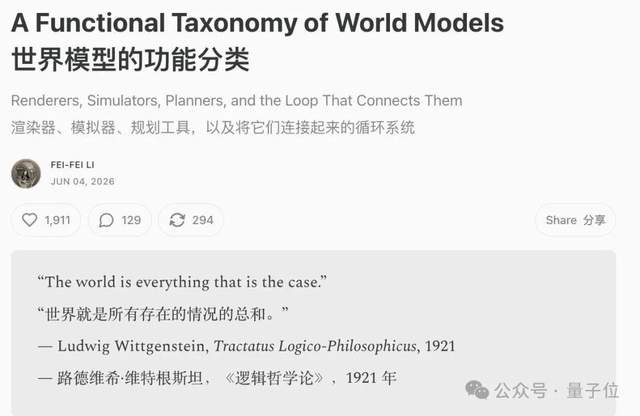
今年 6 月,李飞飞团队发了一篇论文,专门给世界模型做功能分类。
文章从功能上把它们分成三类。
这一分,它们到底有几分真本事,就清楚了。
渲染器,管的是世界看起来什么样。
输出给人看的画面,拼的是真实度和表现力。
模拟器,管的是世界实际上什么样。
维护符合几何和物理因果的场景状态。
规划器,管的是智能体下一步该怎么动。
依据当前世界状态和目标给出动作。
这三类挑开,答案就浮出来了。
为什么 AI 已经能生成以假乱真的视频,我们还要费这么大劲做世界模型。
从逼真画面,到维持物理规律下的环境状态,再到支持自主决策。
中间涉及的空间表征,动态预测,还有行动规划。
这几样恰恰是传统多模态生成没解决的难题。
而论文里那些看着很远的构想,现在已经被一点点搓出来了。
再回到节目现场那番操作。
凭一句话生成画面,今天真不算稀奇。
人真的走进去、自由穿行,才是分水岭。
这时候模型要处理的,已经从眼前一幅画,变成整个场景的空间结构。
不管人往哪走,从哪个角度看,地形、物体和它们的相对位置,都得保持几何一致。
要一把勺子,模型凭空生成。
人还能顺着勺柄往上爬,实时互动。
看着简单,背后是即时生成、环境状态建模和动态预测三件事一起转。
用户一操作,场景里的物体和空间关系就得更新。
还得接着预测下一步环境怎么变,前后不能崩。
这已经不是在跟 AI对话 那种一问一答了。
更狠的是空间本身也能改。
画一扇任意门,现实房间和外太空就接通了。
到这一步,能力又多了一层。
三维场景重建,空间可控编辑,跨场景的连续性建模。
模型能在保留原有空间结构的同时,动态重组不同场景的几何关系。
还能支持跨场景的连续探索和实时交互。
从维持空间结构,到响应实时交互,再到支持场景编辑和跨空间重组。
这三层能力指向同一件事。
跟 AI编程 那种把活干完的路数不一样,它要的是一个待得住的环境。
AI 生成的不再是内容,而是一个数字世界。
它持续存在,持续变化,还能持续交互。
早几年,大模型拓的是处理语言和知识的能力。
多模态模型把生成能力铺到图像、声音和视频。
现在轮到空间结构,环境状态,还有它们的演化规律。
生成式 AI 的比拼,从画面有多逼真,挪到了环境能不能一直存在、能不能响应交互。
二、字节那场演示,其实拆成了三层能力
要是世界模型只能让人在赛博世界里瞎逛,那就太浪费了。
放到产业里看,它还有一层更有想象力的价值。
让机器在虚拟世界里大规模训练、反复试错。
再把学会的本事搬回现实。
机器人和自动驾驶这类物理 AI,一直卡在真实数据上。
采集贵,试错周期长,危险和极端场景还难复现。
世界模型给了一条新路。
把现实环境变成一个虚拟训练场。
能生成,能控制,还能反复验证。
从生成稀缺数据,到模拟复杂环境、验证策略,一部分原本要真车真机去跑的环节,可以搬到虚拟世界里完成。
世界模型也就从内容生成,走到了物理 AI 的训练和验证环节。
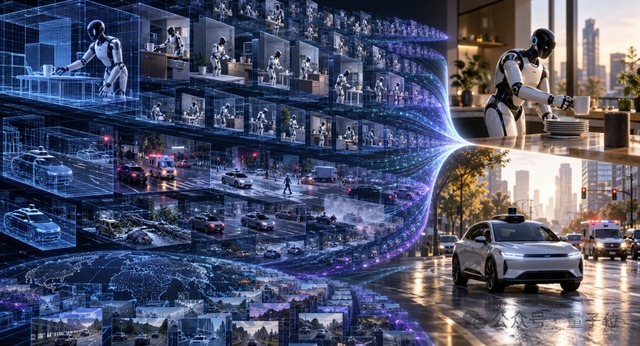
先说训练数据。
自动驾驶最缺的,恰恰是那些关键场景。
突发事故、极端天气这种低频高风险场景,跑再多里程也碰不上几次。
节目现场就演示了一个自动驾驶场景。
救护车突然驶来,行人横穿马路,交警在现场指挥。
这些复杂路况被搬进模型生成的虚拟道路。
车可以在里头模拟行驶、应对突发状况,还能多机位回放分析。
过去要靠大量真实路测攒出来的长尾场景,现在有机会批量生成,拿去反复训练和验证。
另一头是训练和验证的效率。
真机器人每练一次,都得执行动作、等反馈,失败还得人工复位,硬件也可能损坏。
到了三维世界里,这套耗时的试错就变成可重复、可并行的实验。
节目现场的家务机器人演示是这么个思路。
在生成的虚拟家庭里,机器人练抓取,练搬运,练摆放。
还得面对不断变化的物体位置和空间布局,随时调整策略。
失败了就在虚拟环境里快速复现,改策略,接着练。
不用一次次人工复位,还能并行试错。
成本更低,速度更快。
三、世界模型真正的大用场,是当训练场
行业里,巨头们已经在不同方向试探了。
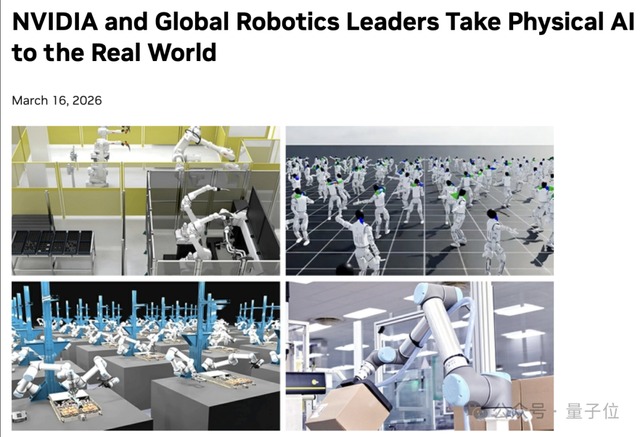
今年 3 月,英伟达把 Cosmos 世界模型和仿真平台拼到一起。
让机器人在虚拟环境里生成数据、反复训练。
这套工业仿真方案,有望把机器人从训练到部署的成本压下来。
更值得注意的是,这股热潮把上游芯片巨头也卷进来了。
9 月,AMD 宣布花 82 亿美元收购李飞飞的公司 World Labs。
意图很直白,提前卡住世界模型的算力需求,为下一代芯片铺路。
从机器人虚拟练功,到工业仿真,再到芯片巨头亲自下场。
世界模型的竞争,正沿着产业链一路往下走。
从模型能力、实际应用,一直扎到底层算力架构。
四、全球都在跑,中国玩家手里有牌
火是真火,但热闹底下有个挺有意思的现象。
海内外厂商都想做出空间稳定、能实时交互的三维世界。
可各自的技术积累不同,研发重心和落地路径也不同。
目标在往一起走,路子却各走各的。
海外这边,谷歌 DeepMind 的 Genie 和李飞飞的公司,探的是通用世界模拟。
重心在空间结构、环境动态和交互式场景生成。
英伟达的 Cosmos 更贴着物理 AI 的真实需求。
跟机器人仿真、合成数据捆在一起,想打通虚拟训练和现实应用。
几家侧重不同,指向却一致。
让生成出来的虚拟环境越来越像能模拟现实世界。
再看国内。
跟海外偏重通用模拟不同,国内厂商这几年在图像和视频生成上攒的技术,给了另一条路。
这条路有竞争力。
今年 7 月,视频生成模型单次时长推到 30 秒。
多模态参考控制、镜头运动和连续叙事也跟着强化。
同期的图片生成模型,把空间位置理解、结构一致性和交互式精准编辑又往前推了一步。
用户在画面上圈一个位置,甚至随手画几笔,模型就针对指定区域改,画哪儿就改哪儿。
从空间结构一致,到长时序连续,再到对操作的精准响应。
这几件事,恰好都是搭一个可交互三维世界绕不开的。
国内厂商在视觉生成和可控编辑上的积累,开始显出往通用世界模型延伸的潜力。
1895 年,卢米埃尔兄弟把一列驶入车站的火车搬上银幕。
那时候的人想不到,这项发明会在之后一百多年里,彻底改掉人类记录和呈现世界的方式。
又过了一个多世纪,计算机图形学和虚拟现实先后出现。
人开始从看屏幕里的世界,转向走进去。
现在轮到世界模型。
机器学着现实世界的空间结构和运行规律。
试着生成能持续探索、实时交互,甚至用来模拟现实的虚拟环境。
一百多年前,人类学会用影像记录世界。
一百多年后,我们开始让影像变成一个能走进去、甚至能改变现实的世界。
这次,我们终于开始走进自己创造的影像。
