

9 月 24 日,清华大学和无问芯穹一起开源了一个平台,名字叫 RLark。它要解决的问题很具体。机器人多起来之后,谁来统一调度。
先看一个熟悉的场景。这事不新鲜。
一架飞机在天上飞,看着只是它自己的事。其实它得不停和机场、跑道还有航线打交道。飞机一多,就需要一座塔台。天上的和地面的资源,都要约到一起。
具身智能眼下遇到的,是同一件事。道理是通的。
一台机器人自己跑,没什么好管的。几十台、上百台一起上,麻烦就来了。
设备要一台台接进来。任务要分别部署。云端和现场的网络要反复配。出了问题,还得挨个查设备和程序。
这和AI对话产品不一样。聊天框里的文字,多开几个窗口就能应付。机器人占的是真实的机器,也是真实的场地。

一、先让设备变成能申请的资源
RLark 的定位是一个云原生纳管平台,服务对象是具身智能。说白了就是管设备。
它不是给个人用户直接用的AI工具,更像机器人团队共用的一块底座。
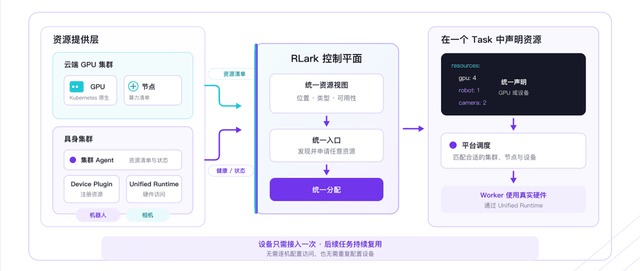
它最核心的一件事,是把机器人和相机这些真实硬件,变成像显卡一样可申请、可调度的资源。机器人也能排队。
负责这件事的,是平台自研的具身设备运行时。设备接进来先注册身份。再由各集群的常驻程序,把容量和状态同步到控制面。
对运维人员来说,接入设备变成一行命令。对研究人员来说,部署变成一份配置。训练、推理和真机交互,各自申请自己要用的东西。
接入要花多久,团队给了实测数字。在测试环境里,过去约一小时,现在大约五分钟。差了一个数量级。
平台之外还有配套。用户能从网页控制台和接口进来。远程终端和可视化看板这类小工具也配齐了,不必逐台登录机器。
目前 RLark 已经统一纳管 3 个集群。云边端节点近百个,覆盖 4 种型号的具身设备。任务提交之后,10 秒内就能启动运行。快是真的快。
代码已经放出来。地址是 github.com/RLinf/RLark。文档在 rlark.readthedocs.io。

二、广东和北京之间,跑了一次真机实测
数字好看,还得看真机器上跑不跑得起来。团队为此做了一次跨地域实验。
一头是广东的云端算力集群。另一头是北京的机器人现场。
现场设备和相机负责交互与采数据。云端算力负责训练。练出来的策略,再送回现场。RLark 居中协调,管设备申请,管跨集群部署,也管运行状态的汇集。
这次实验连续跑了大约 36 分钟,训练推进到 323 个步骤。从资源申请到策略更新,整条链路完整走通了一遍。链路没断。
跨地域训练最怕卡在网络这一段。卡的就是这里。
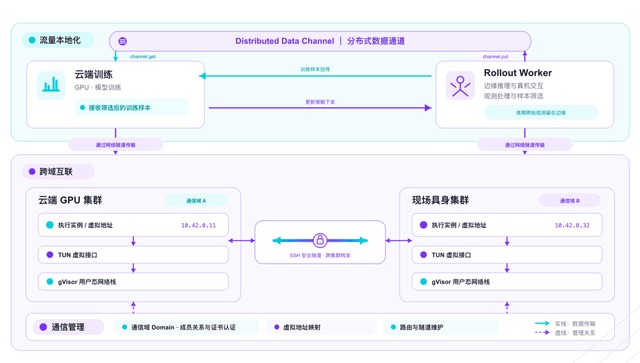
RLark 的做法是把通信地址和实际位置拆开。平台给实例分一个虚拟地址。流量先由用户态网络栈处理,再经加密隧道送到对端。路由和隧道的维护,都收在平台这一侧。
翻译成数字更直观。在受限网络环境下,大包单流吞吐比测试所用的一种组网方案提升约 49%。小包单流吞吐提升约 14%。在带宽充足时,大包单流吞吐接近每秒 2G。
和另一款跨地域组网工具相比,训练过程中的卡顿明显少了。体验差别在细节里。
三、它内部是怎么搭起来的
一项任务真跑起来,光把设备接进来不够。任务怎么部署,集群之间怎么通信,出了问题怎么定位。三件事都要管。
RLark 的架构是控制面和数据面分开。散在云端、边缘和实验现场的资源,收进同一套管理里。
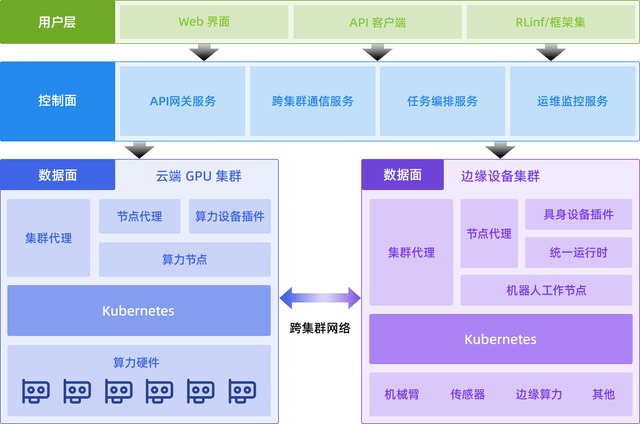
用户可以通过网页界面、接口或者命令行来提交任务。控制面像塔台一样,维护资源信息、任务配置和通信关系。各集群里的常驻程序负责本地部署,把状态回传上来。
塔台由四块能力撑起来。
第一块是设备运行时。设备被注册成系统能识别的资源,和算力一起参与编排。研究人员在同一份配置里声明显卡、机械臂和相机的数量,平台负责分配。
第二块是跨集群通信。平台通过虚拟地址和加密隧道,把同一个任务里分散在不同集群的实例连起来。互联的范围用通信域来圈。成员关系和证书认证控制谁能进来。
在这个基础上,训练框架再对数据流转做一轮优化。观测数据的处理与推理,还有真机交互,都放在边缘侧就近完成。只把训练真正需要的数据传回云端。
第三块是任务编排。一项实验用三层模型来描述。整项任务叫 Job,执行角色叫 Task,真正跑角色的实例叫 Worker。用户写一份配置,声明每个角色要多少实例、放在哪里。
配置可以复用。换设备,改规模,调参数,改一份文件就行。有先后依赖的流程,还能用工作流把多项任务串起来。不必维护一堆启动脚本。

第四块是运行观测。平台以同一项任务为主线,把角色和实例关联起来,再把相关的节点、设备与日志挂上去。入口只有一个。
任务没按预期推进时,排查是逐层走的。先看哪个角色没跑起来。再往下找具体实例,看它的事件和日志。远程终端和训练曲线面板作为补充入口,省掉了登录多台机器的功夫。

四、它为什么选择开源
具身智能的硬件和环境还在快速变化。新的机器人、相机和传感器陆续接进来。不同场地的网络条件,要一个个验。规模变大之后,调度和异常恢复还会冒出新的工程问题。问题只会更多。
所以需要的不是一件“把设备接进来”的工具,而是一套能持续长起来的基础设施。开源是让它长得更快的方式。
按团队的规划,接下来会继续打磨设备与芯片的适配,轻量运行时,跨域通信和异常恢复。
平台也留了口子给外部参与。门槛不算高。做机器人和芯片的厂商可以接设备适配。算法团队可以分享采集、训练和验证的场景。做基础设施的开发者,可以参与任务编排和网络能力建设。
回头看一眼整件事。过去两年,具身智能比的是数据够不够多。谁的示范时长更长,谁的动作库更大。
现在多了一层比拼。比的是组织能力。这些设备、算力和程序,能不能被一条任务串起来,能不能被重复使用。
RLark 这次把力气花在了这一层。它不像一个新的机器人本体那么显眼。但它决定了机器人走出实验室之后,一个人能带多少台。
