

AI 圈子里最懂「怎么让模型开口聊天」的那个人,现在把大模型的语言能力拿走了。
他叫 Diogo Almeida,前 OpenAI 研究员,也是 ChatGPT 的共同发明者。潜行两年之后,他带着新公司 TypeSafe AI 和 4000 万美元融资回到牌桌。他们发布的新模型叫 Jev。它写不了周报。也陪不了人深夜长聊。它连一个标点符号都吐不出来。

TypeSafe 创始人 Diogo Almeida
这是个反常识的时刻。过去三年,全行业都在教大模型学会像人一样「慢思考」。各家实验室拼命拉长推理链条。它们让模型在开口之前,先自言自语几千个词。
它走的是完全相反的路。它不做文本生成。它只输出确定性的结构化决策。
这已经不只是新品发布。它更像一次公然叫板。叫板的对象,是当下大模型的技术范式。
01 给 AI 装一根反射神经
要理解这个模型是什么,先得看懂今天的开发者有多难受。
大部分工程师把大模型接进业务系统时,干的事其实很荒谬。你可能只需要它回答一句话。这封邮件算不算垃圾邮件。或者在五个接口里挑一个。可你不得不请一个上千亿参数的庞然大物出场。让它花上漫长的几秒,一个词一个词地敲出一串结构化文本。
为了保证这串字符符合代码规范,开发者得写满两页提示词。他们在求模型「不要废话,只给纯数据」。图省事的做法是继续加提示词。可堆到最后,格式还是照样崩。它偶尔会在前后加一句话。比如「好的,这是你要的格式」。下游整条流水线当场断掉。
Jev 的解法非常粗暴。它压根不是一个文本自回归模型。
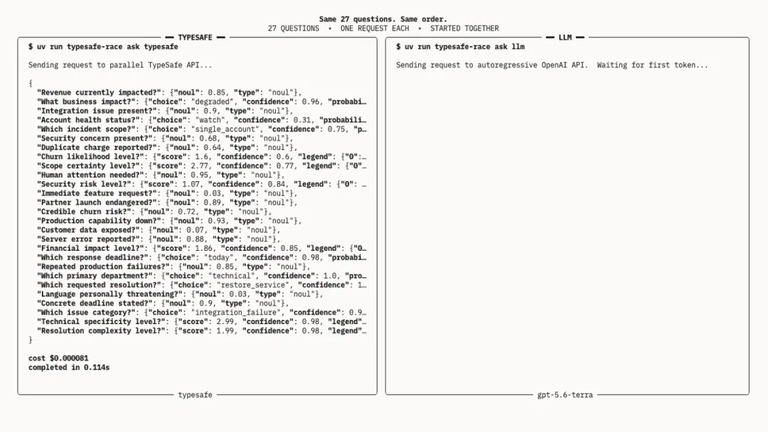
速度对比:3 秒之后,Jev 这边已经吐出成片结果
Kahneman 在《思考,快与慢》里把人脑分成两个系统。系统一是无意识的本能直觉。它很快,而且不费力。系统二很慢。它需要调动精力做逻辑推演。主流大模型这几年都在拼命卷系统二。
它给自己的定位很怪。它是世界上第一个纯粹的系统一模型。
它不逐字生成内容。所有决策在一次单向并行计算里同时产出。这意味着它没有生成式的废话。输出被严格锁死在开发者预先定义好的结构里。
从数学层面看,它直接消灭了格式幻觉。结构化输出不再跑偏。
它不需要推演下一个词是什么。端到端延迟因此被压到 70 到 500 毫秒。相比市面上的前沿模型,这个数字快了 40 到 200 倍。
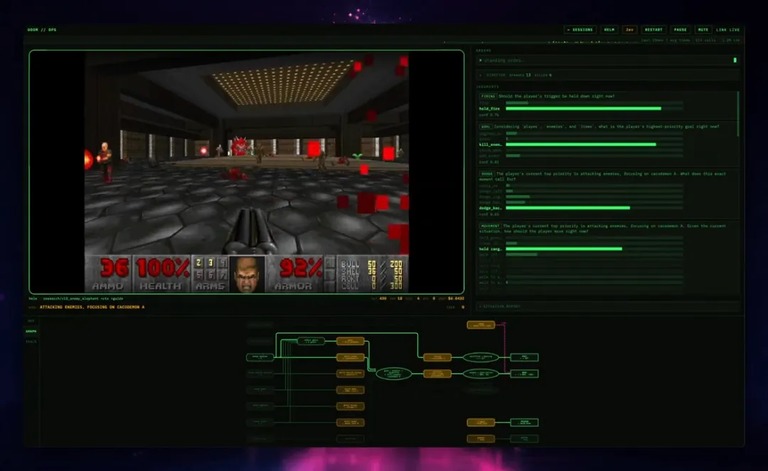
Jev 打 Doom 的测试画面
TypeSafe 甚至让 Jev 去玩射击游戏 Doom。这类场景不需要长线规划。它只要每秒做出十次左右的即时判断。Jev 表现得像一个反应很快的人类玩家。整套推理成本每小时大约 7 美元。
价格更夸张。输入每 100 万个 token 只收 0.042 美元。输出完全免费。平均下来,一次结构化决策的成本大约是 0.0004 美元。同样的活交给 GPT-5.6,费用大概是它的 76 倍。交给另一家的旗舰模型,则是它的数百倍。
输入非结构化数据。瞬间吐出带校准概率的分类、评分或者布尔判断。然后立刻把控制权交回去。这就是它的全部工作。
02 智能体的瓶颈,不是脑子太慢
他们为什么要在这个时间点,做一个完全不吐字的模型。答案藏在正在全面铺开的智能体里。
无论是写代码的编辑器,还是硅谷流行的企业自动化流程,工程师很快撞上一个残酷现实。现在的智能体又卡又贵。问题往往不在核心逻辑不够聪明。它出在中间的「执行摩擦」上。
一个完整的智能体任务,通常包含几十个微小决定。判断当前步骤成没成功。决定调工具甲还是工具乙。从上一段输出里抽出关键字段。判断要不要终止流程。
如果每个小动作都要请一次千亿参数的大模型,延迟会一层层叠到几十秒甚至几分钟。成本也会迅速失控。更麻烦的是,中间任何一步格式解析失败,整个流程就卡死在半路。
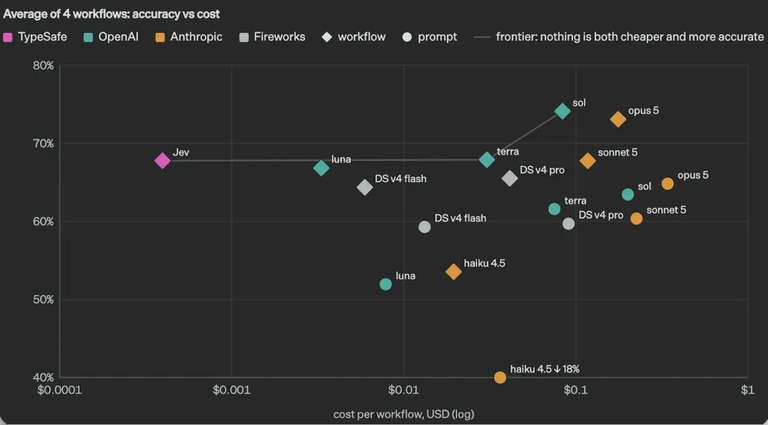
四个典型工作流的准确率与成本对比
行业被自回归文本模型绑得太久了。久到大家默认了一件事。所有 AI 任务都得拿自然语言当中转站。
可现实里的生产系统,绝大多数节点本质上就是传统的代码控制流。代码不需要情绪价值。代码也不需要排比句。它只需要一个决策信号。这个信号要极度便宜。要极其迅速。还要绝对符合类型。
它出现的位置,其实是在大模型的系统架构里插进一层「前置反射弧」。
在理想的协同架构里,昂贵的前沿大模型应该退到幕后。它充当统领全局的系统二,负责宏观规划和高难度思考。第一线那些脏活累活,可以交给这类系统一模型去毫秒级解决。宁可让贵的模型少出手。也别让它去干这些杂活。比如工单分类。比如内容合规初筛。比如大批量数据打标。还有在几十个接口里选定调用哪一个。
团队给出的自测数据很说明问题。在四个典型企业工作流里,它的准确率是 67.8%。这个数字几乎打平 GPT-5.6 的 67.9%。只看判断准不准,它没输给比自己贵几十倍的模型。而执行速度拉开了几十倍。
把大脑皮层的慢思考,和脊髓的条件反射拆开。这也许才是智能体真正跑进大规模工业化落地的正确姿势。
03 零误差背后的黑盒
不过,把它当成一颗完美银弹,显然太早了。这份技术答卷的背面,至少有两块阴影被刻意绕开了。
第一块是可解释性的全面丧失。
思维链模型虽然啰嗦,也容易出错。但它至少会把「为什么这么选」写在草稿纸上。当一个信贷审核智能体拒掉客户申请,或者安全系统拦下一笔交易,合规部门能顺着推理过程去追溯决策逻辑。
它的输出只有干瘪的选项和概率。它没有能力用自然语言讲出理由。模型一旦做出关键误判,没人能从它黑盒般的权重里找出原因。在金融和医疗这样的强监管领域,这种决策机制往往缺乏可审计性。它会直接撞上合规的南墙。
第二块是技术细节与评估基准的封闭。
团队宣称发明了一套名为 RLCD 的训练方法。它要取代传统的 RLHF。可公开信息里,很多关键问题都没答案。奖励函数怎么设计。网络架构基于什么。校准概率的数学方法究竟是什么。官方全都没披露。
更微妙的是那些漂亮分数。目前所有基准测试都来自该公司内部评估。没有第三方独立机构完成过复现。他们拿来当真值标准的参考答案,甚至是用 GPT-6 Astra 和 Claude Fable 5.1 跑出来再取平均值得到的。让竞争对手的下一代模型当裁判。然后宣布自己在性价比上大获全胜。这种自证闭环本身就带着强烈的公关色彩。
数据并不亮眼。商业模式的可持续性同样存疑。每 100 万个 token 只收 4 美分,输出还完全免费。这个价格低到让人怀疑是在烧那 4000 万美元融资打价格战。
它目前还在小范围邀请内测。当大量高并发的真实企业流量涌进来,这套体系能不能既保持超低延迟又维持收支平衡。这还是个未知数。
模型更小,速度更快,结果更确定,这确实打中了当下的行业痛点。但在真正被极端场景拷打之前,断言它已经颠覆范式,为时尚早。
过去几年,所有人都在惊叹 AI 越来越会说漂亮话。现在终于有人意识到一个更朴素的事实。在沉默的机器世界里,行动往往比语言更重要。
这句话不只说给 Jev 听。它也说给每一个正在给自己的 AI工具 加长提示词的人听。
