

十年前,4e:55 这个神经元是全领域的招牌证据。
它看到猫脸会亮。
看到汽车车头也会亮。
两个毫不相干的东西,挤在同一个格子里。
于是大家得出一个结论。
神经网络底层是一团乱麻。
拆不开,也读不懂。
这个结论撑了整整十年。
上周,当年把它写进论文的那个人发了长文。
他说自己错了。
一篇长文,把自己十年的工作推翻。
他先把当年的实验重做一遍。
那台机器,就是当年给神经元画特征图的工具。
工具换过三代,图也跟着换过三代。
结果反过来了。
旧结论不是被驳倒的。
是被更好的工具照出来的。
只讲当年那台看图的机器还不够好。
这句话听着温和,杀伤力却最大。
因为整个领域都站在同一台机器上。
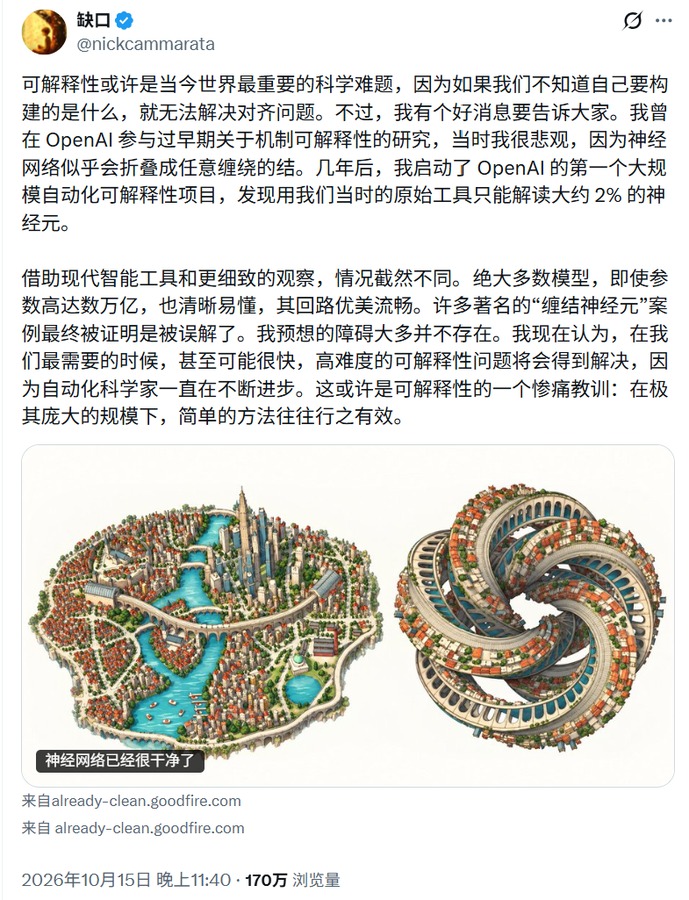
他开篇就说,这或许是当今最重要的科学难题。
原本那个神经元不认识猫。
也不认识车。
它检测的是 V 字形的几何结构。
狐狸的尖脸能点亮它的正极。
喷射的火焰也能。
汽车的尖头,消防船喷出的水柱,同样算数。
它的负极是圆的东西。
圆脸和圆球,还有圆形的车轮。
错的是当年的观测工具。
2023 年,他在 OpenAI 做第一个大规模自动化解释项目。
用当时的工具,只能解释大约 2% 的神经元。
三年后,他带着更好的算法和一队智能体重新跑。
现代视觉模型最后一层,99% 到 100% 都读得出来。
那个被判过死刑的老模型,重测后也大幅上涨。
他把结论写进一篇要读 65 分钟的长文。
神经网络本来就是干净的。
这个干净不是指一个神经元只干一件事。
他指的是内部结构连贯。
精妙,而且人能直接读。
像一张规整的地图。
想看细节,放大就行。
一家同源实验室的核心研究员转发时用了很重的话。
他说这是科学史上的重要时刻。
对齐终于能变成一门常规科学。
如果这话成立,第一批要重算的是过去十年的账。
这几年做 AI工具 的团队,力气几乎都花在拆解上。
稀疏自编码器是一路。
特征字典是另一路。
还有特征解缠。
都是把缠在一起的特征拽出来,再贴上人能读的标签。
现在他说,缠在一起的也许不是网络。
是观测方式在替网络制造乱象。
他不是说这些工具没用。
是说它们瞄准的目标从一开始就偏了。
调过 AI编程 助手的人都遇到过一种情况。
改一处,崩一片。
过去大家把这种脆弱归给黑箱。
现在看,可能是没读对。
一、十年共识是怎么长出来的
2014 年,那个视觉模型被当成生物学里的果蝇。
表层还算清楚。
越往深处越乱。
当时学界的估计是,最后一层只有 5% 能读懂。
最出名的就是那个格子。
它让两个八竿子打不着的东西共用一格。
一个神经元应该对一个概念。
为了解释它,学界提出叠加假说。
意思是神经元不够用时,模型会换一种存法。
把互不相关的概念折叠进同一格。
汽车的特征信号,被藏进一组狗神经元里。
到这里,结论就锁死了。
既然是缠在一起的,就得发明工具拆开。
这条路上最主流的是稀疏自编码器。
训练一个辅助模型。
让它把硬塞进去的多个特征拽出来。
两家顶尖实验室同时押注。
于是它变成了默认选项。
默认选项一旦形成,就很少有人回头问一句。
图是不是本来就这么乱。
在 AI对话 的产品里,答非所问也常被归到同一个黑箱解释里。
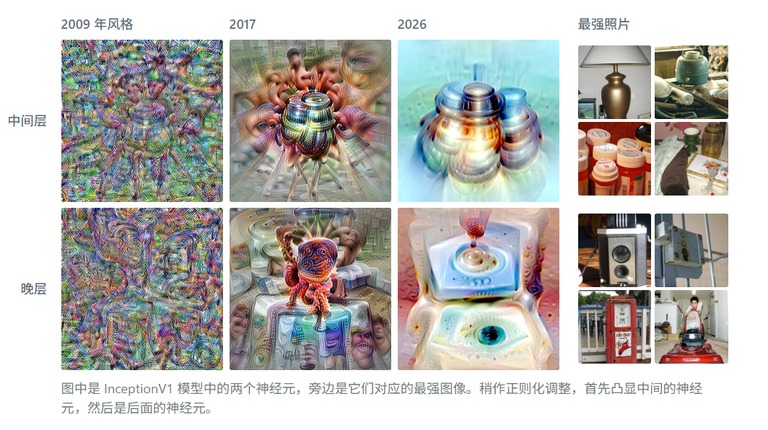
左边是 2009 年的合成风格,右边是 2026 年的最强照片。
原来这十年,大家一直在和工具误差较劲。
不是模型难懂,是镜头脏了。
十年方法,一句话推到台面。
二、两个经典案例被翻案
工具换了,两个最出名的多义性案例同时反转。
核心逻辑只有一句。
用动态机制和几何特征,替掉过去的名词分类法。
先说猫和汽车。
过去的可视化,是让算法合成一张最能激活神经元的图。
算法会抄近路。
它追求最高激活值,顺手带进猫狗的语义残渣。
人顺着残渣读,自然读成动物神经元。
他换了两套更严的做法。
第一套是路径引导。
把正则参数调细,逼算法沿真实图像的天然激活路径合成。
噪音就被剥掉了。
第二套是正负极交叉验证。
不只问什么最能激活它。
也问什么最能压住它。
两头一起锚定,功能就露出来了。
结果,模型是按几何分类的。
那个格子盯的是 V 字。
这个发现本身不新鲜。
新鲜的是它把误读解释通了。
误读的根不在网络,在合成图。
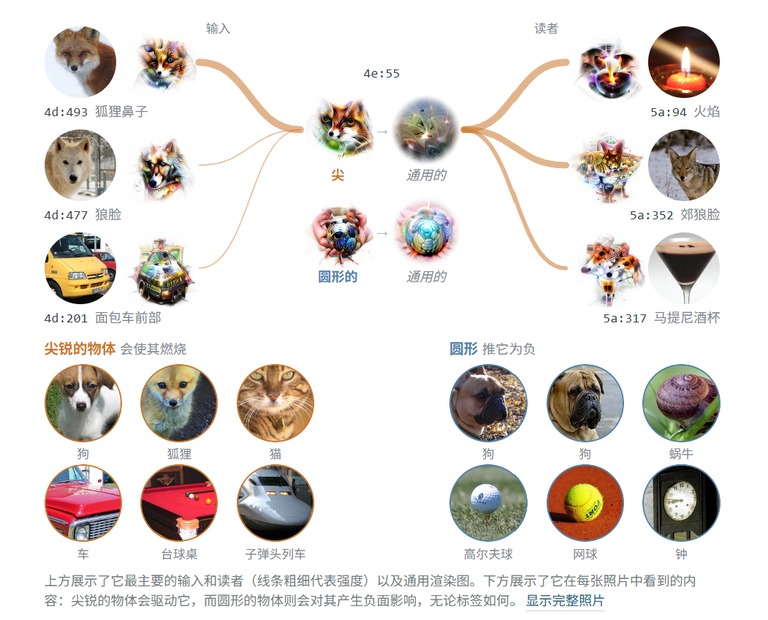
同一格 4e:55,狐狸鼻子和火焰都能点亮它。
另一组案例更直接。
汽车和狗。
训练集里狗的图远多于汽车。
优化一掉进狗的图像盆地,就爬不出来。

模型放到 12 倍规模,汽车和狗才按姿态分开。
这次用智能体做动态梯度追踪。
再做消融,也就是控制变量剪线。
结论是,它不是狗神经元。
它检测的是正脸朝前,两侧对称。
汽车信号在这里被打上正面标签。
最后分流进两条电路。
一条认车,一条认狗。
之前的多义性,很多来自数据集偏差。
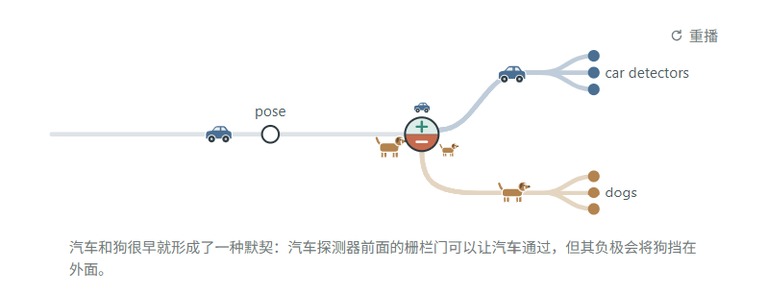
这一层认 pose,往下分成 car detectors 和 dogs。
三、神经元的真相是递归泛化
既然不是乱塞,多义性从哪来。
他给的解释叫递归泛化。
神经元像树枝一样长。
一开始也许只认油菜花。
沿着黄色这条轴,它扩到所有黄色的东西。
沿着圆形这条轴,它又伸到球状物。
再顺着花田里的生物,覆盖到花田里的狗。
最后长到绿色的西兰花。
只看两头,会觉得它胡说。
把整条生长路径摊开,每一步都连贯。
所谓人读不懂的逻辑,其实是高维里的语义延伸。
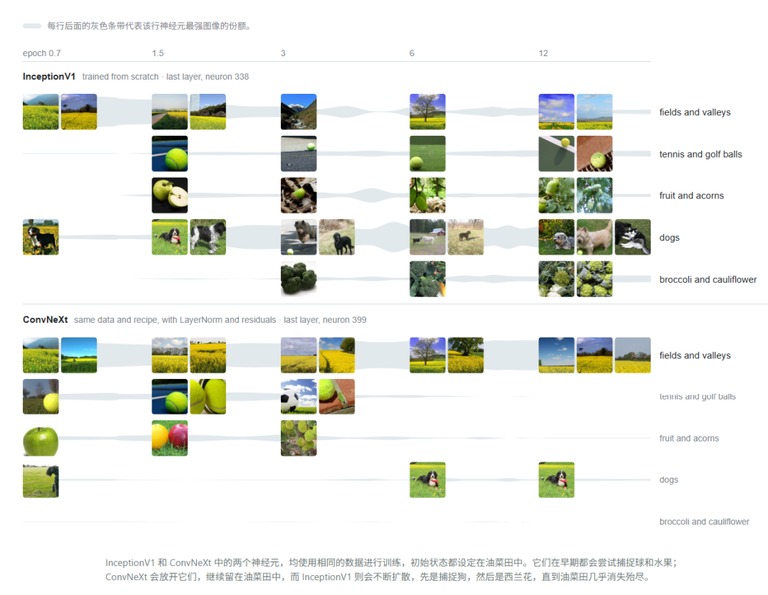
灰色条带是每行最强图像的份额,右边落到 broccoli。
在语言模型里,这个现象更夸张。
一个只认某个音节的神经元,会一路长到短语。
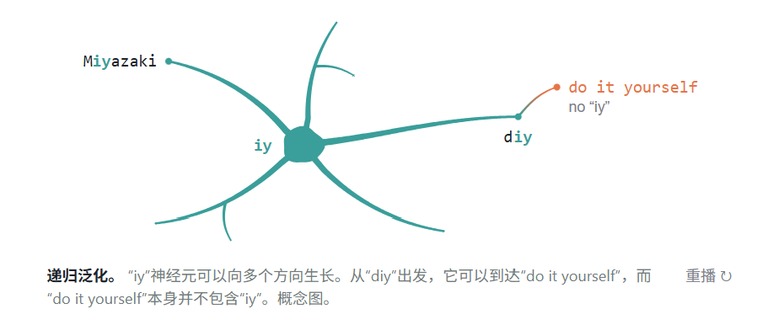
从 diy 长到 do it yourself,这条枝越伸越远。
传统学派会反问一句。
神经元真不够用时,总会切到叠加模式吧。
他为此设计了一个极限压力实验。
挑了一个没有残差流的层。
那层本来有 480 个检测曲线的神经元。
他压到 10 个。
48 倍压缩,然后从零重训。
按叠加假说,这里该挤成一锅粥。
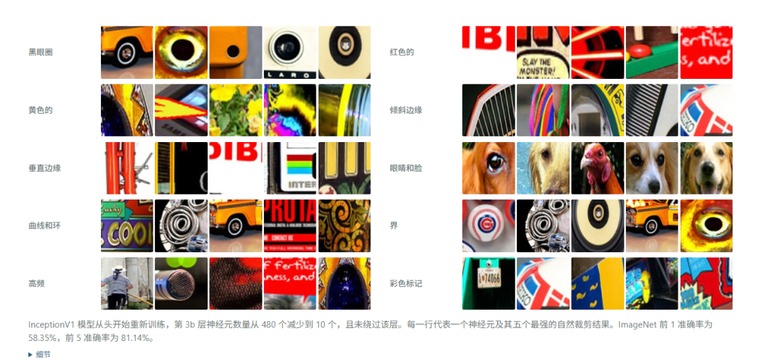
压到 10 个之后,它们改管眼睛和脸这类大块。
结果正好相反。
10 个神经元个个可读。
只是每个管得更宽。
一个曲线与环的神经元,合并了原来 10 个细分检测器。
两个圆形神经元包下所有圆形分类。
他还发现,被拆出来的特征没有变干净。
响应宽度反而比原生神经元粗好几倍。
这意味着那些欢呼过的解缠特征,可能是工具造的假象。
四、反驳来得也快
长文发出去,评论区立刻分成两派。
有人问,换成别的架构还成立吗。
他答得很干脆,还成立。
性能越好的模型,内部反而越好读。
旧卷积,新卷积,现在的架构,三种都对得上。
这句话把适用范围从视觉推到了别处。
这条线从视觉模型一路推到语言模型。
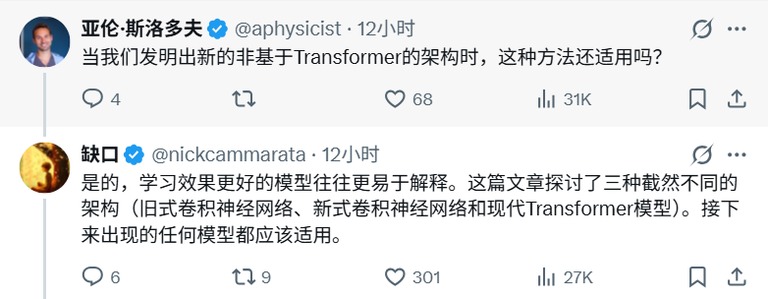
网友追问,换成别的架构还适用吗。
另一家自动化公司的联合创始人追问。
能不能把干净度做成一个行业指标。
他说不难。
控制激活、剪线,还能探测盲区。
这些都能拿来给底层秩序打分。
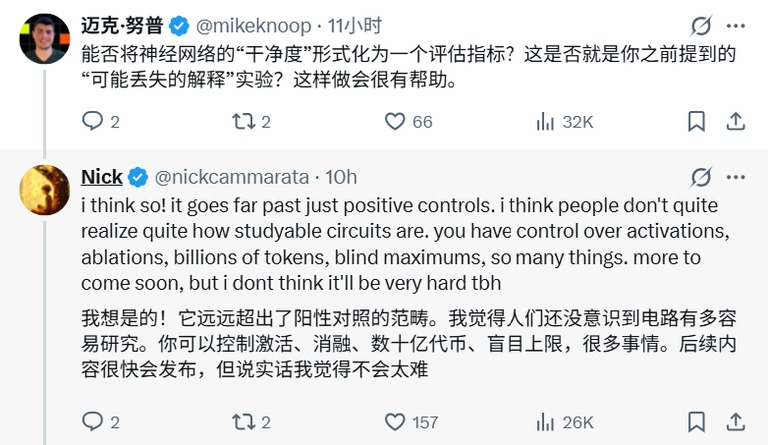
有人问,能不能把干净度做成一个评估指标。
真正扎人的反对,来自一个团队负责人。
他直说,这篇文章有意思,但没有实质突破。
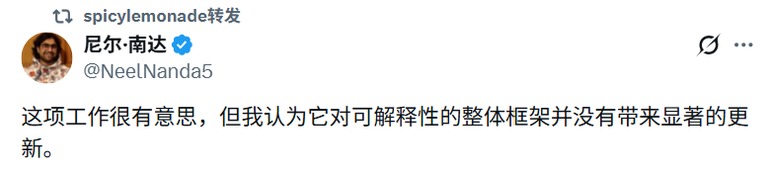
这位回帖说,很有意思,但没带来显著变化。
争的根本不是同一个叠加。
这个词在领域里至少有五六种定义。
一种是任意叠加,随便乱塞。
另一种是表征叠加。
大模型记住的知识远超神经元数量。
靠的是少数神经元做线性组合。
他推翻的是第一种。
要守的是第二种。
靶子不在一处。
这里的分歧不在数据,在词的定义。
同一个词,两拨人各说各的一半。
外行看像吵架,内行知道这是两套问题。
接着是三条技术质疑。
第一,弱激活不是残渣。
弱激活里存着大量事实和记忆。
砍掉就等于砍掉叠加的载体。
第二,证据几乎全来自视觉模型。
语言模型的信息密度高几个量级。
小图像模型记不住东西,推不到大模型身上。
第三,别急着给稀疏自编码器判死刑。
它在残差流上仍然不可替代。
不是谁取代谁,是各有各的场景。
这里有个细节值得说。
视觉模型和语言模型的差别不在难度。
在记忆的量级。
一个几百万参数的视觉模型,本来也记不住多少事实。
用它证明大模型没有叠加,等于用小学考卷证明大学没用。
这话说得挺重。
但也提醒了一件事。
证据的边界,就是结论的边界。
他基本认了。
他说这只是工作假设。
还有几个问题他没解决。
第一条是规模。
巨型模型内部依然干净,但工程挑战没解决。
第二条是模态。
视觉和语言拼在一起时,融合层怎么组织,完全没看过。
第三条是训练过程。
图像模型能看每一步,语言模型只有最终形态。
第四条是工具定位。
压缩层上拆不干净,不等于原层也不行。
正常未压缩的层,两边匹配度能到 0.96 以上。
第五条是方法。
现在的结论靠扰动看效果。
不扰动系统的严格验证,没人做过。
即便如此,它已经改变了四拨人的动作。
做可解释性的,别再执著于解缠手术。
抬头看原生电路就行。
过去十年最贵的那批工具,可能要重新定位。
做安全对齐的,这是好消息。
网络天然可读,理解的门槛就降下来了。
但能读懂不等于能改对,活没少。
做架构设计的,可以理直气壮把可读性写进指标。
残差流和归一化本来是为了好训练。
结果顺手把网络变干净了。
这个副作用以前没人算进去。
做应用的,未来调行为不用重训。
调一个神经元,就能改一类场景下的表现。
在法律和医疗这种地方,这个价值很直接。
当然前提是这套读法真的通用。
一篇长文能逼出这种澄清,本身就有价值。
至少它让所有人把靶子画清楚了。
这也是为什么他愿意认账。
如果只是名词之争,认账的成本并不高。
可他连适用范围都主动缩了。
这一点比结论更像科学。
十年前,大家看的是模糊的神经元图像。
得出的结论是这东西读不懂。
十年后才发现,乱的不是网络。
是先入为主的偏见。
这件事最值得记的一点在于。
他没有换一个更漂亮的论证。
他只是换了一台更好的仪器。
然后就把十年共识推翻了。
