10 月 6 日,谷歌开源了一个新模型。
它要做的事,是让搜索能听懂画面和声音。
一个小到能塞进口袋的模型,装下了找图,找视频,找录音的本事。
文字,代码,图片,视频,音频,一句话就能一起搜。
这在谷歌的开源模型里还是头一回。
起点不低。
体量非常小。
参数只有 7 亿多。
手机能跑,笔记本能跑,浏览器也能跑。
全程不用联网。
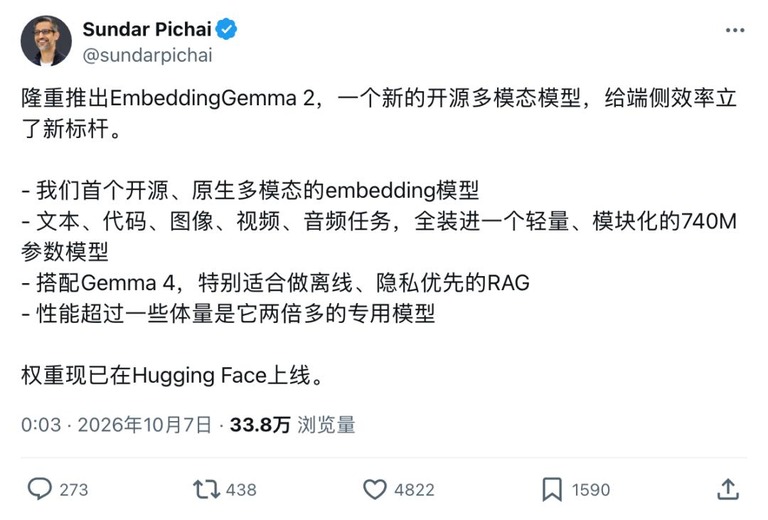
谷歌掌门人亲自下场推荐。
他说,这是谷歌第一个原生多模态的开源嵌入模型。
排面不小。
真正的突破,是让手机自己在本地找图片和录音。
演示里只输一句“鸟在唱歌”。
鸟的照片和鸟叫录音,就一起跳了出来。
效果很直观。
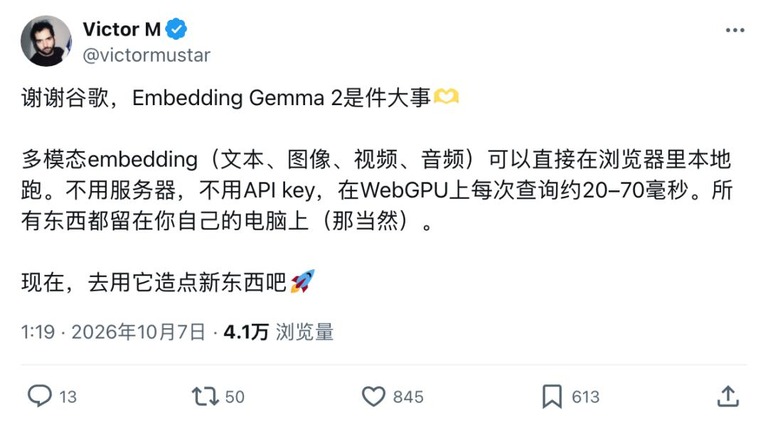
发布一个多小时,就有人把它放进浏览器跑了起来。
他在搜索框敲下“birds singing”。
屏幕上的格子立刻重新排序。
排在最前面的,既有鸟的照片,也有显示着波形的鸟叫录音。
整个过程只用了 22 毫秒。
快到离谱。
不走服务器,也没调任何接口。
全在本地。
应用接入它之后,你就能让 AI 帮忙找手机里的照片和录音。
不必再把文件先传到云端。
这一步不小。
一、文字图片声音能互相搜了
嵌入模型这东西,普通用户平时看不见。
它自己不会答话,也不会画图。
却有很多 AI工具 要先向它请教一句。
搜索框和 AI对话 的问答,背后也都靠它找资料。
它干的活,是把一段内容变成一串数字。
相当于给每段内容在一个巨大空间里安排一个坐标。
意思越接近,坐标就靠得越近。
搜索的时候,系统再去找离问题最近的那些内容。
路线很直白。
上一代只认文字。
要搜图片和声音,往往还得接上别的模型。
或者先把它们转成文字。
这一代把它们放进了同一个 768 维空间。
猫的照片,“cat”这个词和猫叫声,就能按语义关联起来。
一句话就够。
于是一句话能搜图片,也能搜视频。
一段语音,能找到视频里对应的片段。
它还能把文字,图片和视频放在一起。
一次搜到包含这些内容的整条信息。
谷歌在模型卡里举了个例子。
一双跑鞋的商品页,有文字介绍,有两张细节图,还有一段防滑测试视频。
模型能把这组内容转成一个向量,用来匹配“适合越野跑的防水鞋”。
一次能处理的内容也更多了。
8K 的上下文窗口,是上一代的 4 倍。
只输入单一类型的内容时,最多能装下约 5.5 分钟音频。
换成图片能装 29 张,换成视频能装 58 帧。
它还支持 100 多种语言。
谷歌把它和几个同量级的模型放在一起比了一轮。
差距最大的是看图,还有看视频。
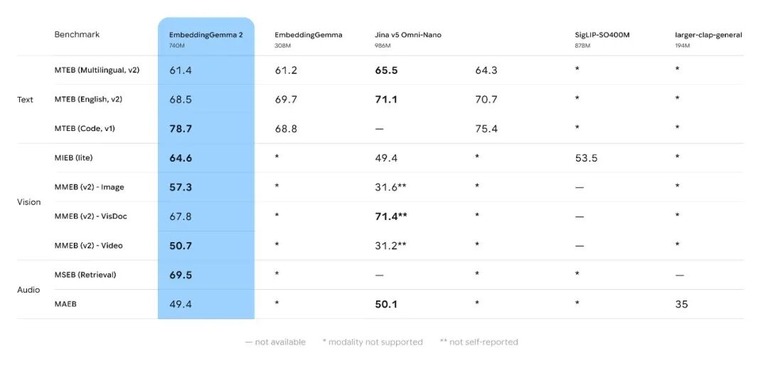
在图像和视频检索上,它明显领先。
那个对手的参数量,比它还大三成。
谷歌公布的测试里,它的图像检索得分是 57.3。
对手只有 31.6。
视频检索也拉开了差距,50.7 分对 31.2 分。
接近 20 分。
在多语言文本测试上,它和上一代基本持平。
守住了长板。
二、567MB 让手机自己当搜索引擎
这么多本事,全装在 7 亿多参数里。
文本部分占 2.7 亿,视觉编码器 1.7 亿,音频编码器 3 亿。
三块可以按需加载。
只搜文字,就加载最小的那块。
要搜图片,再加上视觉部分。
想省内存就这么调。
在谷歌的手机测试里,量化后的纯文本模型,内存占用最低约 191MB。
完整的多模态模型约 567MB。
就这么大。
它还支持给搜索索引瘦身。
用更少的数字记录每段内容的含义,占用的存储就能减少三分之二。
在多语言文本检索测试里,得分只下降了不到 1 分。
代价很轻。
谷歌自己做了几个应用打样。
相册里能按意思搜照片,说一句话就能定位视频里的片段。
还有一个应用把它和自家的小模型搭起来,在苹果电脑上离线检索文件和会议记录。
开发者这边,主流的推理框架已经提供支持,也有人放出了量化版。
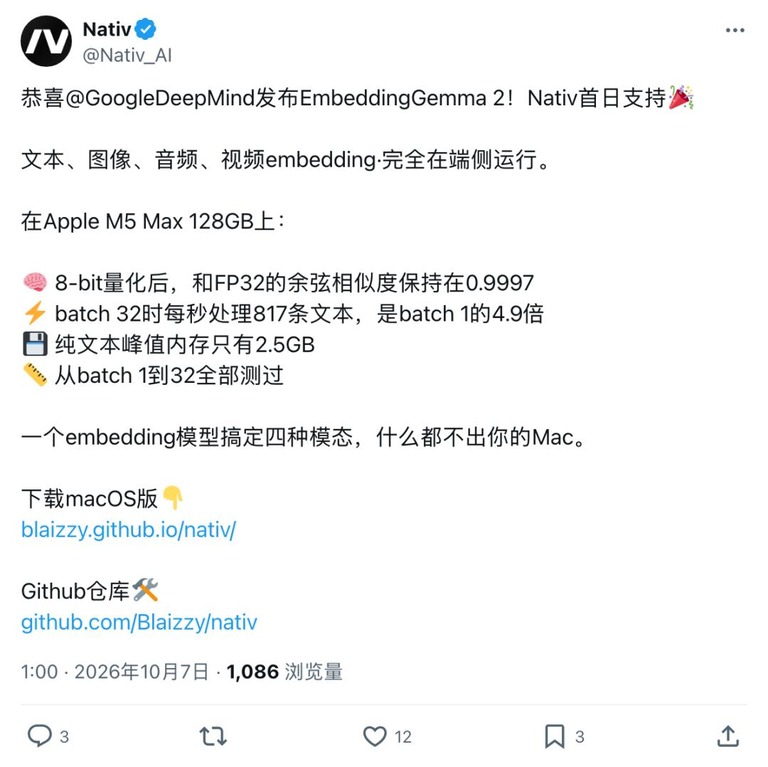
有人测过,在一台苹果笔记本上,量化版生成的向量和原版的相似度达到 0.9997。
文本嵌入速度达到每秒 817 条。
速度不慢。
土耳其一位开发者的测试更贴近日常。
他的笔记大多用英文写,提问却习惯用土耳其语。
以前靠关键词匹配,两边的词对不上,有些笔记就可能搜不到。
他请一个 AI 助手花一个小时搭了个测试台,挑出 40 条笔记。
再换个说法,用土耳其语提问,看正确的笔记能不能进前 18 个候选。
结果关键词匹配只命中 15%。
换上这个小模型,命中率升到 97%。
他又拿 30 条带错别字的真实消息测了一轮。
被找到的笔记数量,是关键词匹配的两倍。
差距明摆着。
还有人玩得更野。
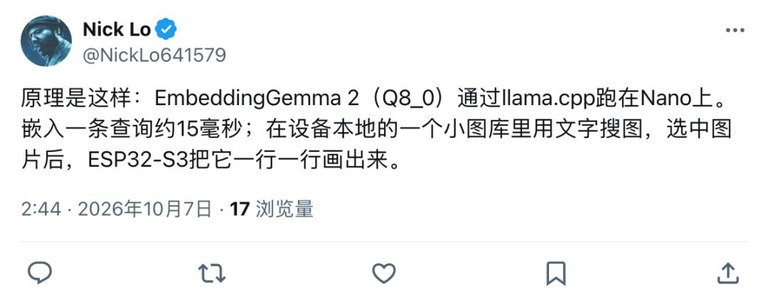
一位开发者把它装进一块拇指大的开发板。
输入一句话,模型约 15 毫秒就能把它转成一串数字。
找到对应图片后,再交给一块很小的单片机,把图像逐行画出来。
三、写代码的助手也能在本地找代码
除了多模态,代码检索也有明显提升。
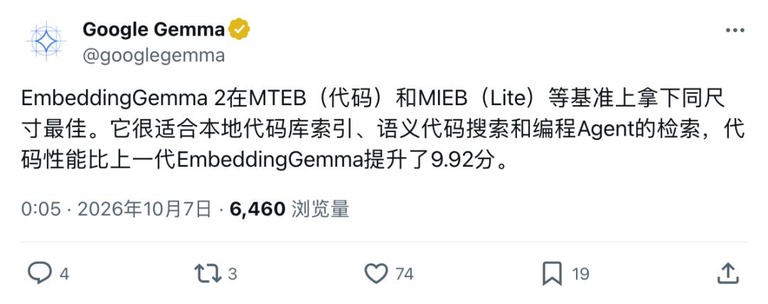
在代码检索基准上,它从上一代的 68.76 分涨到 78.68 分。
一口气涨了近 10 分。
谷歌说,这个成绩在同尺寸模型里领先。
这对写代码的 AI编程 助手很实用。
这类助手干活之前,都要先在整个代码库里找到相关的那几段。
有了纯文本那一版,开发者就能在本地给代码库建索引。
再用大白话查找相关代码。
建索引和检索这两步,都能留在本地。
不用联网。
四、搜索能力搬进了你的手机
今年 3 月,谷歌在云端发过一版 Gemini 系的多模态嵌入模型。
那时候它只能通过接口调用,按用量付费。
半年多后,谷歌又把多模态检索带进一个能在手机上运行的开源小模型。
照片,录音和视频,也有了留在本地检索的选项。
谷歌给出的一个用法,是把它和自家小模型搭配,做离线、隐私优先的问答。
一个负责找资料,一个负责根据资料回答。
检索和问答都能在设备上完成。
全程离线。
过去,要用 AI 搜索照片,视频和录音,得把内容交给云端。
现在,这种能力只要几百 MB,就有机会装进每个人的口袋。
门槛一下就低了。
Gemini会员中转站 微信:douhanq