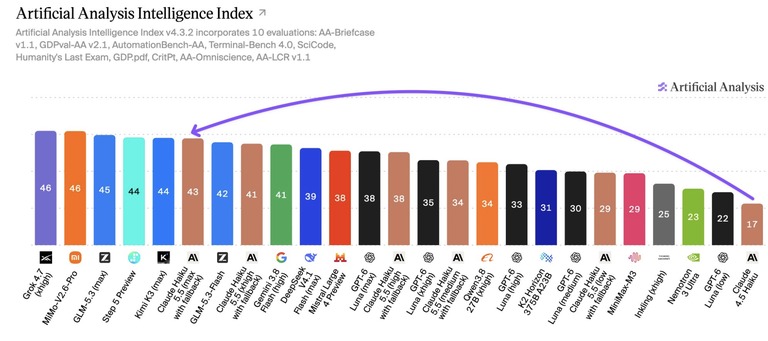
Claude 家最小的那款模型换代了。
版本号停在 5.5。
个头依旧最小。
动静却不小。
跑分榜上,它把两家国产轻量款一起挤到了身后。
小模型守门员的位置就此换人。
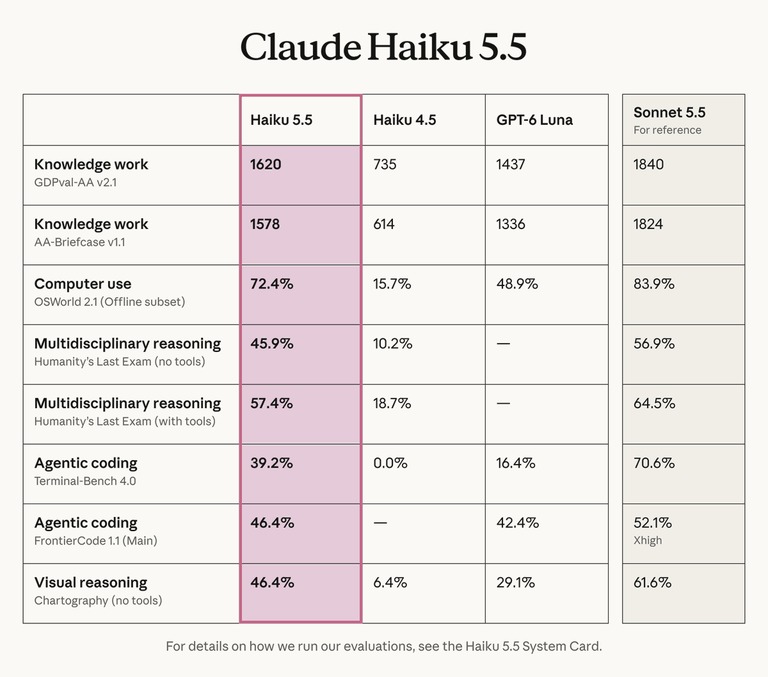
这家放出一张逐项列开的成绩单。
看下来意思很直白。
靶子是隔壁那款主推的小旗舰。
十项评测里,它赢下十项。
一项都没给对方留。
对做 AI工具 的人来说,这一栏比任何宣传都实在。
鹈鹕骑车的测试已经画不出高下。
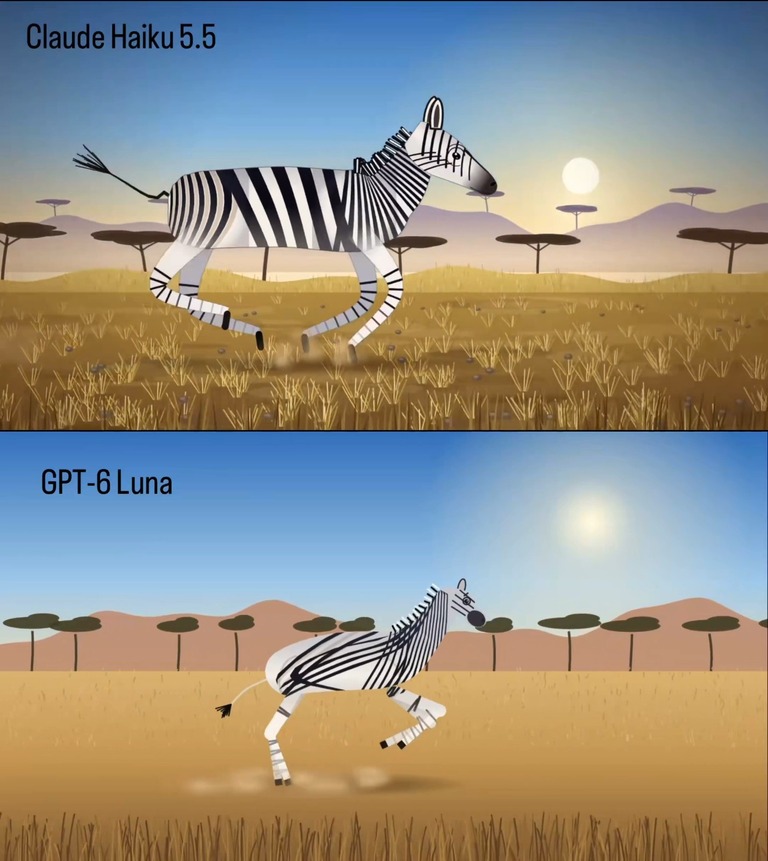
新的题目换成了奔跑的斑马。
同一句提示词,两家各出一版。
左边那版更整齐。
斑马的花纹和背景都更耐看。
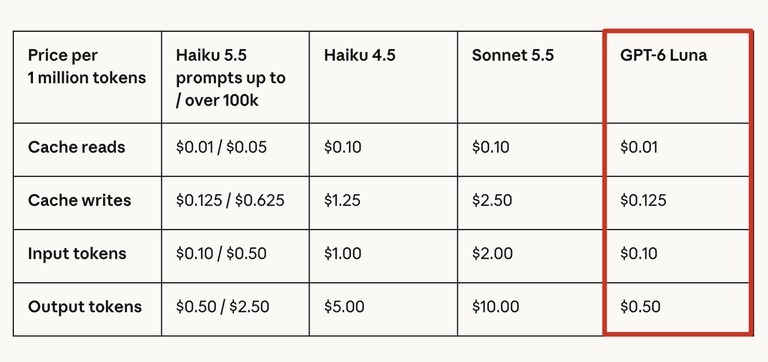
价格这一栏同样照着对手写。
上一代相隔整整一年。
那一代的价格是这一代的十倍。
便宜是有条件的。
提示词在十万词元以内,输入输出都砍掉九成。
超出十万词元的部分只砍一半。
而这一档请求,占了上一代九成的量。
把缓存命中的那一项除外,价签已经压过国产那款 V4.1 轻量版。
对做 AI对话 产品的人来说,价签直接决定每轮对话的成本。
到这里,这家的三档模型算是排齐了。
大杯管复杂推理,中杯管通用执行,小杯管跑量和速度。
只差那管还没挤出来的大牙膏。
隔壁要是不加把劲,这管牙膏大概还会继续捏着。
眼下的局面,像极了当年两家芯片厂比频率的日子。
省词元这件事,没省那么多
新版本是这一系里第一个能调投入档位的。
五档配置,从最低一路排到最高。
上一代在电脑操作和编码上几乎是白卷。
这一代直接翻身。
对做 AI编程 助手的人来说,这版的定位在执行层。
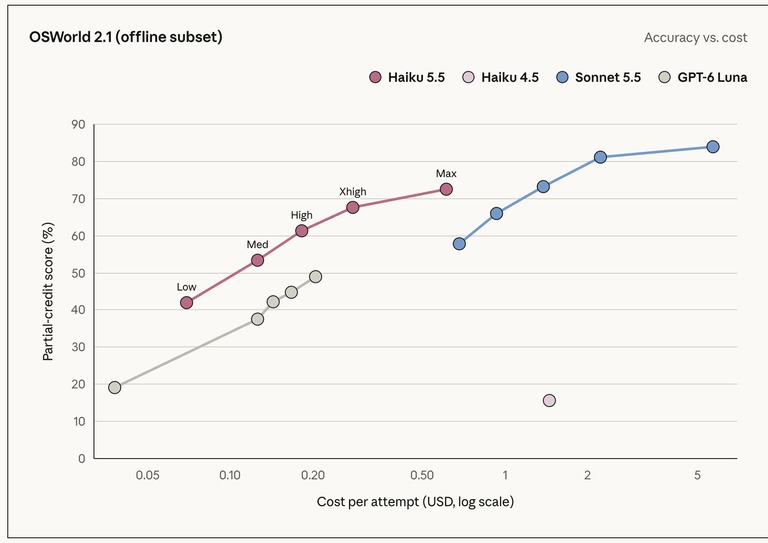
电脑操作评测里,最低档准确率四成二,单次成本七分钱。
最高档到七成二,单次六毛一。
上一代的最高档只有一成半,还要一块四毛五。
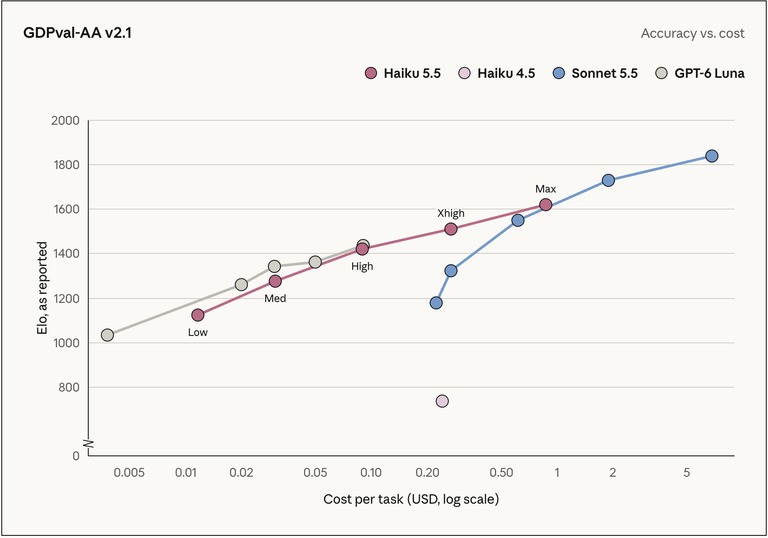
职业任务评测也是相似的曲线。
最低档的分数一千一百多,成本一分钱。
最高档一千六百多,成本八毛七。
上一代最高档只有七百多。
问题出在换过的分词方式上。
它和中杯大杯用的是同一套分词。
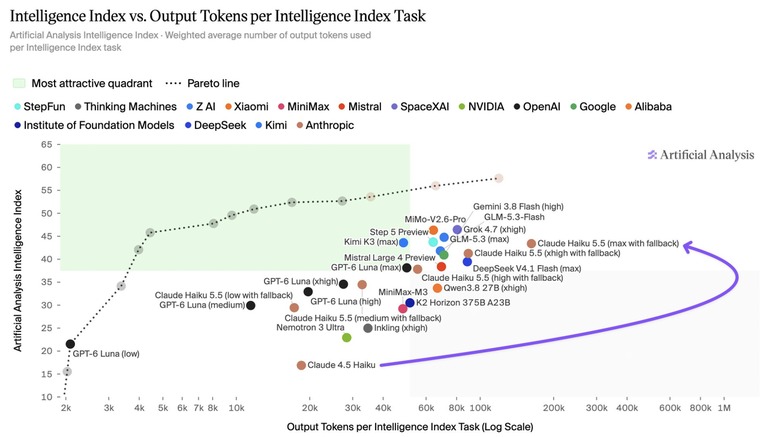
同样的任务,这一代会多花词元。
省下的钱因此比标价上的折扣少一截。
代码,表格,还有非英语内容,膨胀得更厉害。
在第三方测评里,它的接口价格是便宜了。
但完成一次任务的平均成本,没有落到理想的区间。
它替代不了中杯
不少人期待它能顶替中杯,把成本再往下压。
这次没有出现这种奇迹。
小杯终究还是小杯。
终端编程评测上,它拿三十九点二,中杯拿七十点六。
多步编码,跨文件重构,长程自主规划,差距摆在那里。
这家自己也把话说明白了。
复杂的编程代理,优先用中杯或者大杯。
任务已经拆好,验收标准清楚,还能并行跑。
这样的活才轮到小杯。
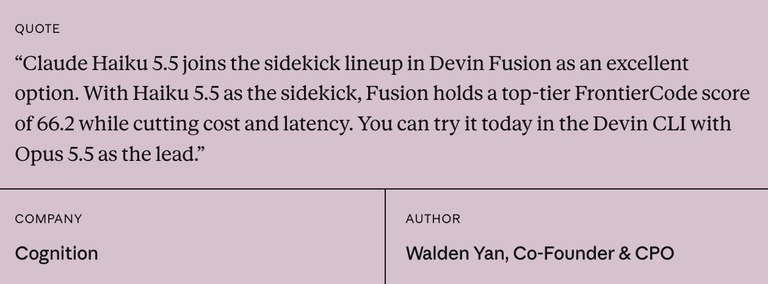
一家做编程代理的公司就是这么用的。
大杯当主模型,小杯当子代理。
组合起来在自家榜单上跑到六十六点二,比两个模型单跑都高。
手上的业务要还在用上一代,这次不是改个名字就能上线。
手动思考的配置直接报错,得换成自适应思考,再加一个档位参数。
采样参数全部锁死默认值,靠它们做创意控制的应用要改逻辑。
助手消息的预填充被取消了,以前那套强制返回格式的写法得换成工具调用。
电脑操作的工具版本也换了,接口格式和返回结构都可能不同。
自适应思考默认开启,响应的第一块内容可能是思考块。
五处变动,每一处都可能让请求报错,或者返回意料之外的结构。
这家给了一份迁移说明,动手前值得对着过一遍。
顺带的两条福利
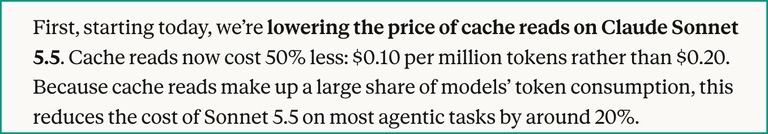
中杯的缓存读取价格降了一半。
从每百万词元两毛,降到一毛。
这家称多数代理任务的成本,因此少了大约两成。
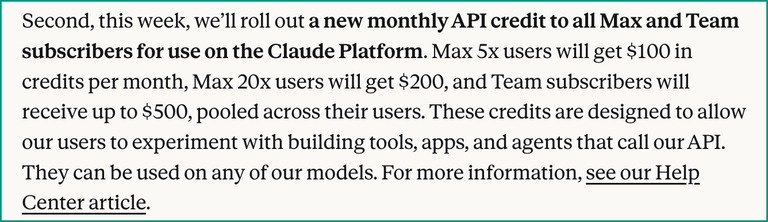
最高两档订阅和团队版,这周起能领每月的接口额度。
最高档每月一百美元,加强档两百美元,团队版最多五百美元,在成员之间共享。
这些额度可以拿来试接口,搭工具,做代理。
所有模型通用。
有人已经在算,这等于把包月编码套餐的钱还回来,再去接口上用一次。
那么隔壁在做什么。
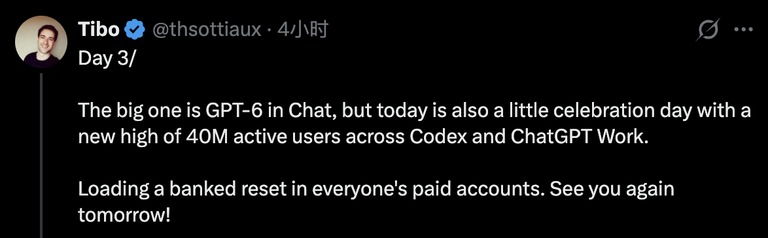
它又发了一张重置卡。
顺带把聊天框里的新版本,和四千万活跃用户一起晒了出来。
要把线上换到新版,宁可先挑一条边角任务试水,也别整条链一起切。
图省事只改一个模型名,多半会在第一次请求上撞墙。
Claude Code会员中转站 微信:douhanq