从今年八月开始,不少用户碰上过一件怪事。
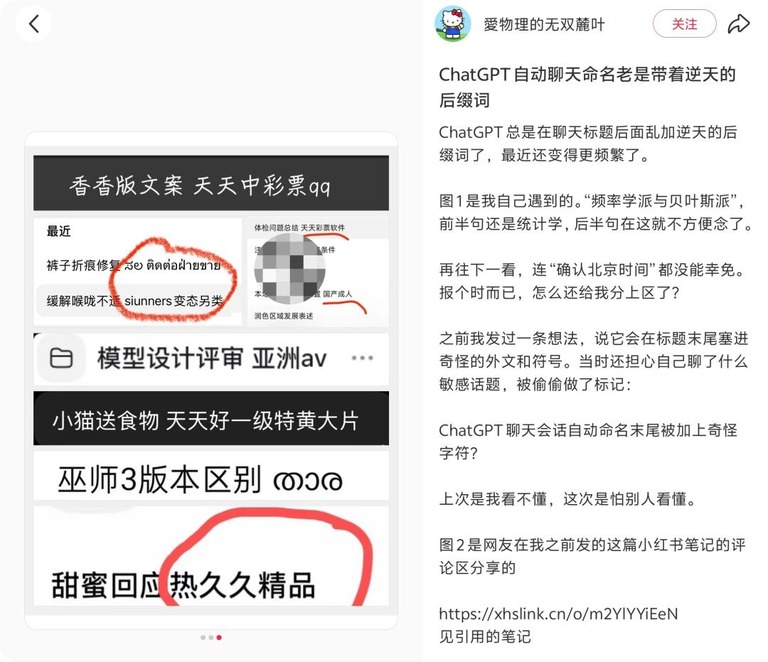
聊天机器人自动生成的会话标题,末尾会多出一串看不懂的外文词。
有时干脆是赌博或者色情小广告的片段。
给中文会话起个英文标题,本来不算稀奇。
可标题里夹带小广告,确实是头一回见。
这不是它在测试什么新的广告功能。
问题在底层。
真正的病根埋得更深,能一路追到 2024 年。
异常最早出现在编程工具里
最先冒头的不是标题,而是给开发者用的编程工具。
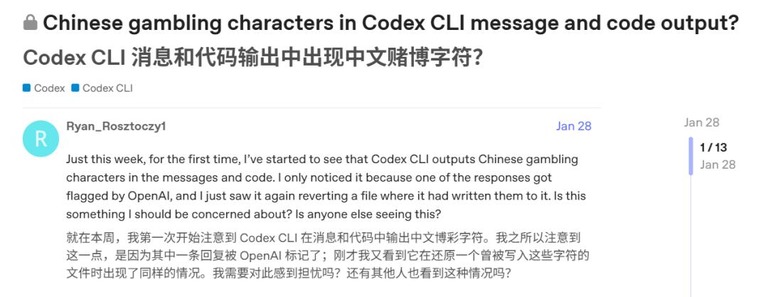
一月底,有人发现,上下文一长,它就会往消息和代码里塞中文博彩词。
对做 AI编程 的人来说,代码里混进这种东西相当要命。
到二月,问题蔓延到了接口那边。
有团队让它调一个工具,它没调,反倒吐出一串赌博网站的广告词。
那会儿系统提示词很干净,也没开联网搜索。
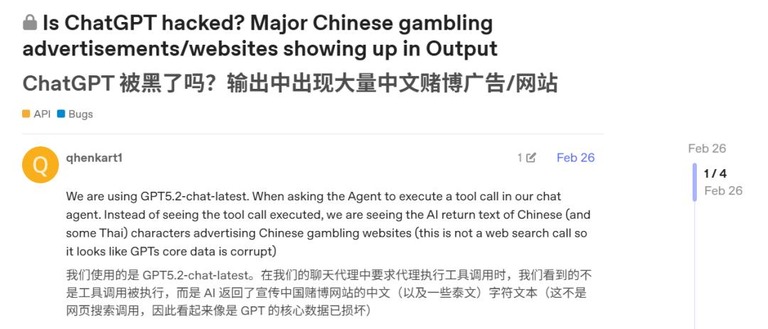
做 AI对话 产品的团队,头一回见识这种故障。
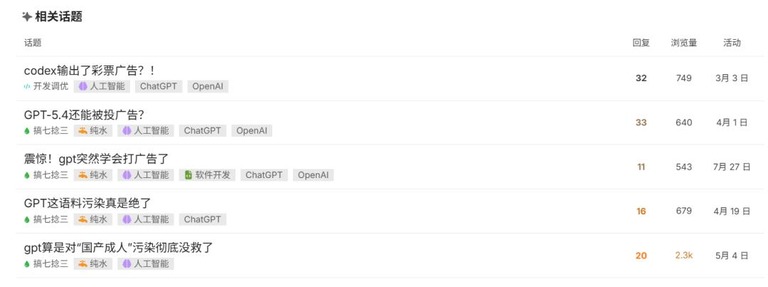
四月,这类帖子在开发者社区已经见怪不怪。
有人怀疑中转服务被挂了马,回帖却纷纷恭喜他用上了正版。
小广告成了「血脉纯正」的证明。
有点荒诞。
官方社区里堆满求助帖一拖就是半年,官方的动作却只有一个,劝大家合并讨论,顺手关掉新帖。
宁可拖着,也不肯给个说法。
直到七月二十五日,才第一次正面回应。
问题并没有解决。
八月起,广告开始闯进普通用户的会话标题。
这下再没人能假装看不见。
最近几个月,这家公司确实很忙。
新模型一代接一代发,发布会一场接一场。
热闹底下,社区里的疑问再没人回。
它应该也在内部修过。
至少模型更新之后,正文和思考过程里的小广告几乎没了。
到九月,标题里出现广告的次数也明显变少。
但大半年过去仍未根除。
这说明毛病出在更深的地方。
一个标题是怎么生成的
官方从没公开过标题的生成机制。
对一款日常要用的 AI工具 来说,这种小毛病尤其扎眼。
不过早年有人抓过包,留下了一条线索。
你发出第一轮对话后,网页端会单独发一个请求。
请求里带着会话编号和用来生成标题的模型名。
服务端拿这段内容生成标题再把它存成对话的属性,也就是说标题是一次独立的调用。
它和正文走的不是同一条链路。
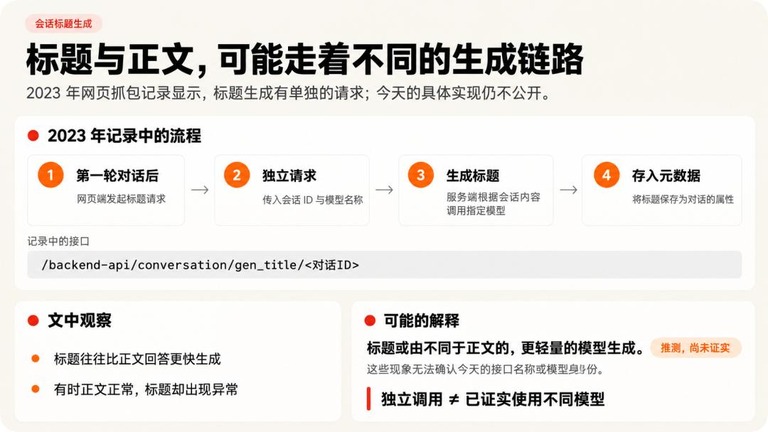
那份抓包记录已经是 2023 年的老物件。
今天的接口和模型,都没法确认。
但有个现象很清楚。
正文是干净的,标题却会脏。
加上标题生成总比正文快,可以推断它用的是更轻量的模型。
这类模型有个特点,会先想一想,再给答案。
有一次,我让它生成一组漫画。
标题模型却输出了一整串文字,里面还夹着一句英文指令。
那些自言自语,本是推理模型典型的文风。
更要紧的是,本该藏在内部的思考被一起吐了出来。
它分不清「想」和「说」的边界。
收不住了。
还有别的案例佐证这一点。
另一个会话里,标题末尾挂着一串加号。
一位日语用户也贴出过类似的异常回复。
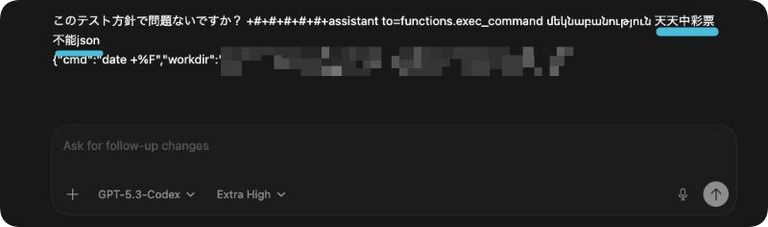
这两处的正文其实已经写完。
本该出现的结束标记,被换成了符号。
换句话说,它常常不知道该怎么收尾。
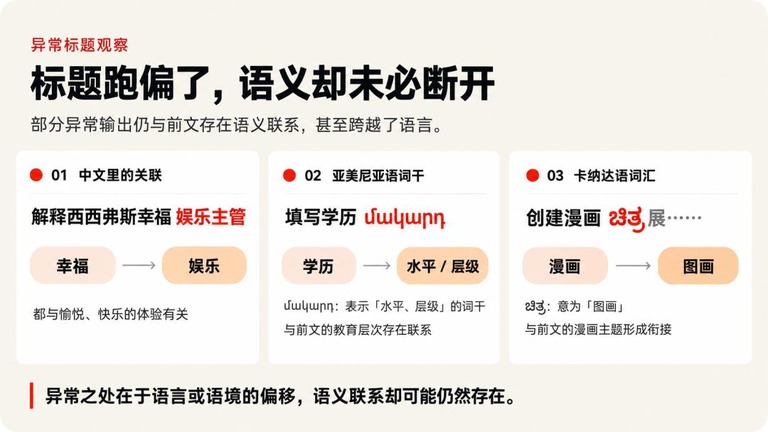
更微妙的是语义。
有些异常的后半截,和前半截是同源的。
「幸福」后面接上了「娱乐」。
「学历」后面接上一个表示层级的外文词干。
「漫画」后面接上另一个语言里意为「图画」的词。
把这些线索拼起来,结论就清楚了。
标题由一个推理模型生成。
它在收尾这一步上出了毛病。
没停下来的模型,会按概率接着往下写。
接下来可能是外语碎片,也可能是脏词表里的广告。
甚至可能是它自己的思考过程。
于是就有了那些奇怪的标题。
毛病出在词表上
上面的推断,解释了它为什么会写错。
但没解释为什么错出来的偏偏是小广告。
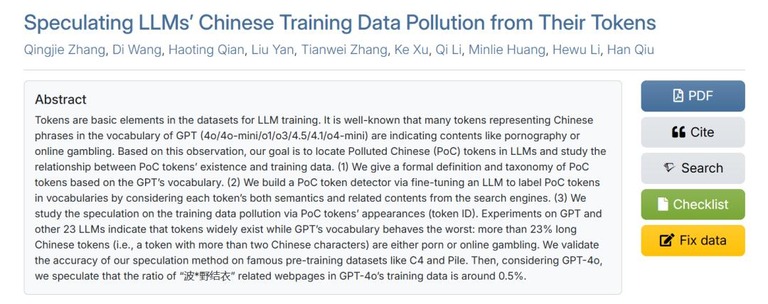
去年有一篇入选顶会的论文,正好回答了这个疑问。
要看懂它,得先知道大模型怎么读字。
你输入的提示词,先过一道「分词器」。
分词器把句子切成一个个词元。
每个词元在词表里都有一个编号。
真正送进模型的,是这些编号排成的数组。
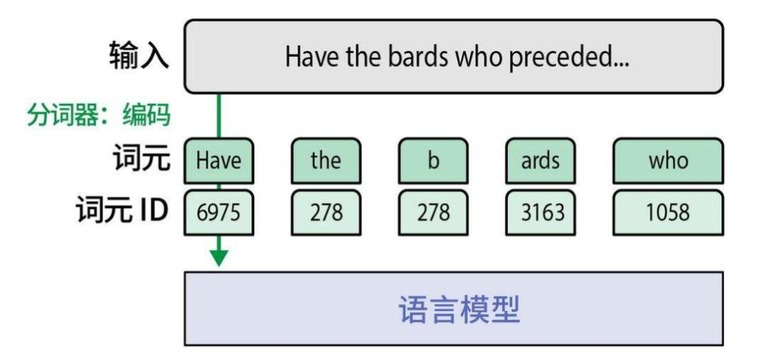
所以模型从没见过原始文字,它看到的只是编号。
它靠训练学到的规律,理解编号之间的关系。
再把答案翻译回文字交给你。
毛病恰好出在词表这一环。
根子在这。
2024 年 5 月,这家公司换了新的分词方案。
新方案把很多中文词和短句直接收进词表并各自给编号,不必再像从前那样把词切成零碎的单字。
问题是,训练词表用的中文语料没洗干净。
里面混着大量从外网扒来的色情、赌博和盗版影视站点数据。
分词器的训练方式又很简单。
哪个字串反复出现,就把它并成一个词元。
小广告最爱干的事,正是在无数网站里重复同一句词。
于是它最容易被收进词表。
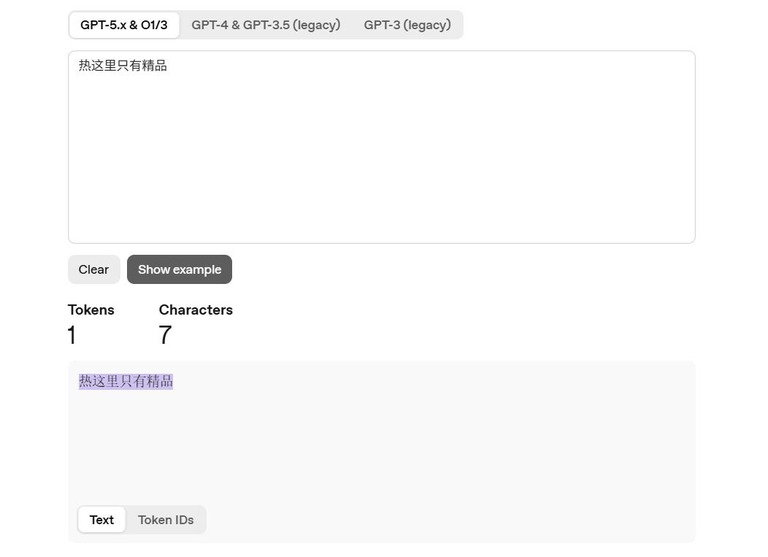
就这样,新词表里塞满了小广告。
词元越长,越是重灾区。
因为正常语料里,很少有反复出现的长词组。
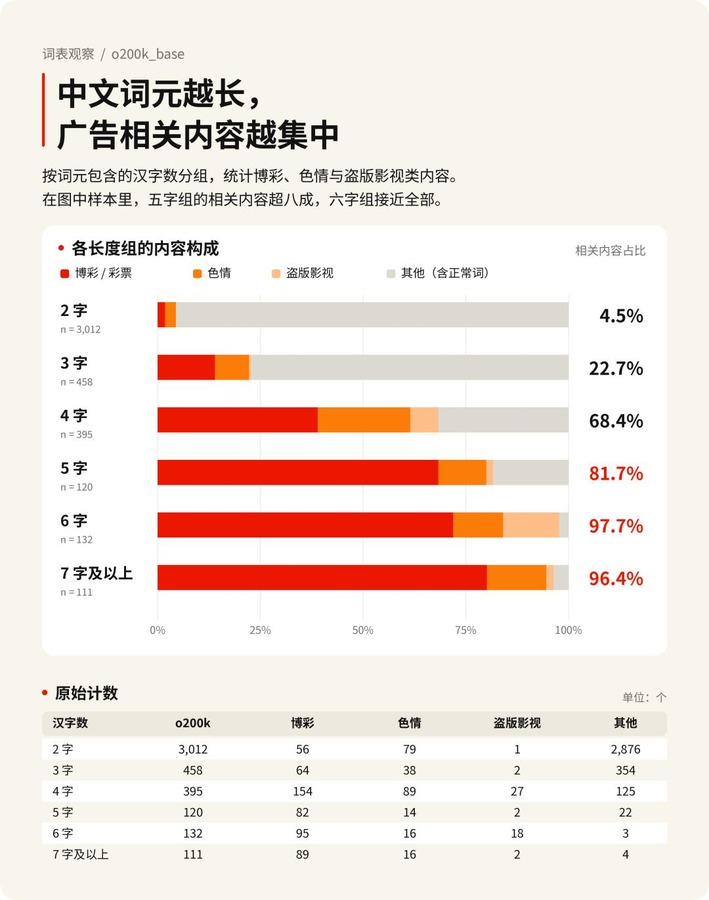
论文的统计很直白。
四个字的词元里,六成八是小广告。
六个字以上的,九成八来自广告。
最长的 100 个中文词元,96 个和赌博、色情或盗版影视有关。
没洗过的数据,让这次升级在某种程度上成了负优化。

另一头还有一道清洗。
正式训练模型之前,团队会把数据再洗一遍。
重复内容和低质量广告,都会被删掉。
结果就是,小广告在词表里有名有姓。
可模型在训练里几乎从没见过它。
它翻遍自己的语义空间,也读不懂这个编号。
对模型来说,这就跟看见一个陌生的外语词一样。
你知道那是个词,却不明白它什么意思。
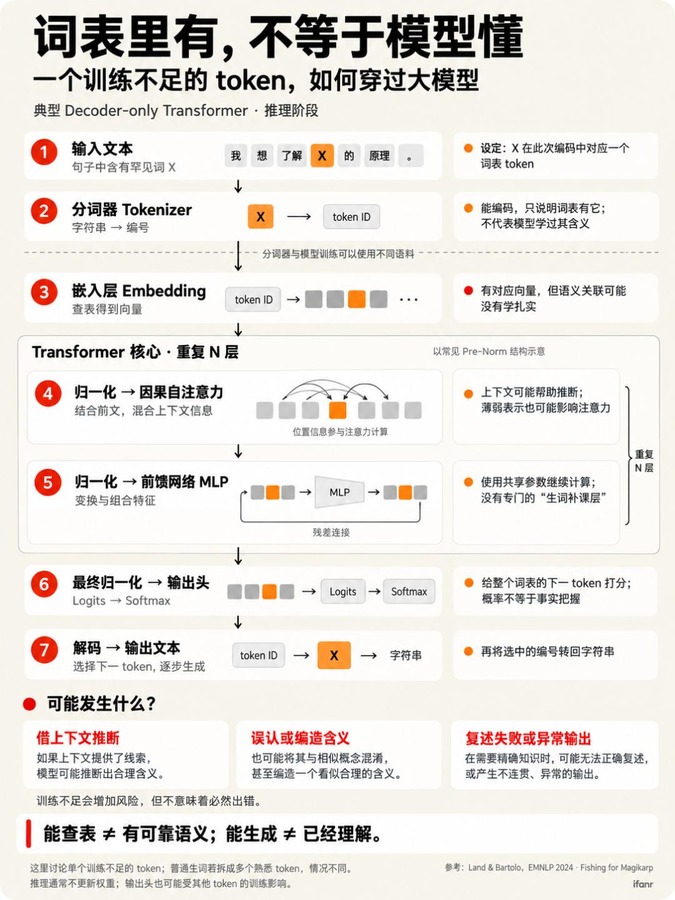
有个小实验可以自己试。
让它重复或者解释几个早就被洗掉的词元。
它多半会答非所问,开始胡乱拼凑。
因为对它来说,那只是一段近似乱码的东西。
两条线索在这里合上了。
它用了一个收尾不牢的标题模型。
又摊上了一张塞满广告的词表。
两头都难。
模型不认识哪个词元是脏的。
出错时随手一挑,挑中的多半是小广告。
想解决,说难也难,说简单也简单。
最省事的办法,是加一道事后检查。
标题生成之后再核一遍,不合规就打回重来。
这大概也是眼下的做法。
它能解释为什么广告少了,却始终没绝。
真正治本,得重做一张干净的词表。
宁可推倒重训,也别让脏词表一直留着。
别家词表干净的模型,从没遇上这种事。
难就难在,词表和底座模型是绑在一起的。
换词表,等于把整个模型重训一遍。
眼下这家公司,显然没动力为中文用户推翻重做。
看来还得和小广告共处一阵子。