

不聊别的,先看一份文件。
一场版权官司,把 Anthropic 一份内部路线图抖了出来。它写于 2021 年 7 月,文件封面上标着最高机密。
不长,正文也就两三页。
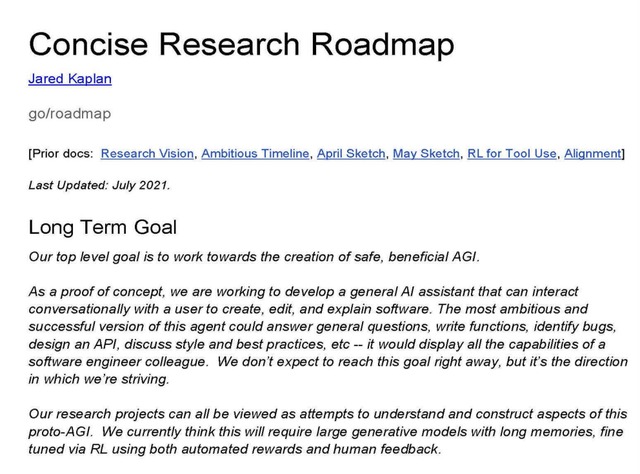
但从头读到尾,人会有点发懵。
今天 Claude Code 在做的事,工具调用,模型自我评判,测试时计算。还有上万亿参数和超长上下文。
这些词今天听着都不新鲜。可在五年前,这家公司刚从老东家独立出来几个月,全公司也就十几个人。
这些字已经白纸黑字写好了。
一份内部文档能把路线画到五年后,这在AI工具圈子里并不多见。
一、五年前的路线图
很多人以为,大模型从聊天机器人变成能写代码的助手。这是这两年技术成熟以后顺水推舟的结果。
不是这样。
2021 年那份文件一开头,就给终极目标定了个很清楚的原型。做一个能用自然语言跟人交流,去创建、编辑和解释软件的通用助手。
什么叫通用助手。
能回答普通问题,能写函数,能找小毛病,能设计接口,还能聊代码风格。
最狠的是后面那句,它要展现出一个软件工程师同事的全部能力。
这不就是今天常见的AI对话场景吗。今天它叫 Claude Code。
那时候上一代模型刚火起来,大家还在惊叹它能写藏头诗。这家公司直接跳过了代码补全,瞄准了完整的软件工程代理。
在AI编程这件事上,他们提前五年画好了图。
实现路径上,内部还吵过一场。
一位研究员抛出核心分歧。先做真正好用的编程助手,还是先去证明工具调用可行。
团队面前摆着两条路。
一条实用。做代码仓库检索,让模型去翻项目的类型定义。论文的一作也参与了讨论,建议从浏览仓库入手。
一条研究。做打印调试和编辑器操作,先证明模型能调工具。
最后是当时的掌门人拍板。短期先验证工具调用,长期再演进成超级好用的编程助手。
回头看这几年的走法,几乎就是照着他当年那句话一步步挪过来的。
二、自我评判,万亿参数与超长记忆
除了编程代理,文件里还有对底层技术的预判。
预训练那一节写着,要训练一万亿参数以上的超大模型。还要探索超长上下文,或者其他能装下海量记忆和经验的机制。
在那个千亿参数还算庞然大物的年代,他们把这些当成了标配基建。
更值得说的是人类反馈与对齐那一节。
文档里赫然写着,让模型自我评判。
2021 年,他们就在研究怎么让模型评估自己的行为和输出质量。怎么把它自己的判断当成反馈信号。
这正是今天自我纠错那一套的核心思想。
还有个词也出现了,测试时计算。
当时这项研究被放在对齐和判别器的语境里,离后来的推理计算扩展还有相当距离。但至少说明,早在 2021 年,这家公司的视野就覆盖了训练之外的计算投入。
所以说,这家实验室手里确实有东西。
不知道今天的前沿实验室,每天又在经历些什么。
三、内部冷汗时刻
既然是讲安全起家的公司,免不了要谈安全。
我看下来发现,这帮人是真爱聊这个,花了好长的篇幅。
2021 年,他们就预见到了今天智能体满地跑时会遇到的噩梦。
一位联合创始人在批注里提了个问题。怎么安全地部署没有沙箱隔离的工具。
掌门人紧跟着补了一句。具体来说,就是在部署时执行代码的那类工具。
原文那里真的带了一个感叹号,能看出他当时挺激动。

这就有点神了。
当模型真的能直接在宿主环境里跑代码,调命令行,改文件。一旦失控或者被提示词注入,后果不敢想。
今天全网在讨论的智能体提权与环境逃逸,还有数据污染,人家五年前就在聊沙箱边界。
可能确实因为他们一开始就打算走这条路。
对了,内部一位做哲学研究的同事也在这份报告里出现过。
她非常严肃地指出,如果对齐研究只做自然语言,能力却主要靠代码推进。这两种研究必须时刻保持紧密联系。
她还提议确立一条原则。各个领域的能力研究和对齐研究,应该成比例同步推进。除非能给出充分理由说明为什么要分开。
四、还有一件事
这家公司这五年咬定青山不放松,死磕高质量代码信号和强化学习。
另一家则一路多线作战,做文生图,做视频,做语音助手,做搜索,多少分散了战力。
不过,就在大家还在复盘两家路线差异的时候,那边突然曝出一个比电影还离谱的瓜。
那边出了内鬼。
根据联邦检察官公布的起诉书,一名 35 岁的前产品团队工程师已被解雇。他还面临刑事指控。
他干了什么。
在旧金山总部高管专用的会议室里,他把一个带加密和数据传输功能的窃听设备用卫生纸包好。悄悄插在了电视机背后的接口上。
那间会议室是几位高管开闭门会的地方,聊的全是未公开的产品规划和政府合作。
结果就这么容易被人插了设备。
世界果然是个草台班子。
Claude Code会员中转站 微信:douhanq
