

AI工具 正一批批往垂类里扎。
先是 AI对话。
再是 AI编程。
这一回,轮到了剧组。
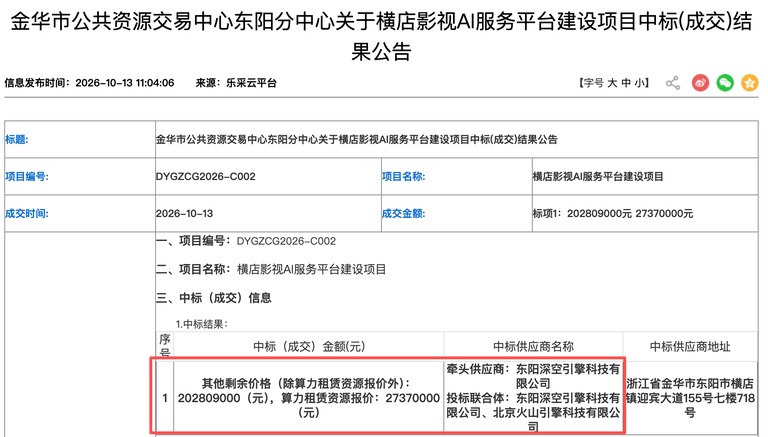
10 月 13 日,浙江金华市公共资源交易中心东阳分中心挂出一份中标公告。
项目叫横店影视 AI 服务平台建设。
中标的是一家联合体。成员是东阳深空引擎和火山引擎。
合计中标金额 2.3 亿元。
这笔钱怎么分,公告里也写得很清楚。算力租赁资源报价 0.27 亿元,剩下的 2.03 亿元算别的部分。
东阳深空引擎这个名字有点陌生。可它的背景不简单。企查查的信息显示,它由抖音有限公司间接全资持股。
项目不是临时起意。今年 9 月 14 日,它就发过招标公告,当时给出的总预算是 2.35 亿元。
按合同,自中标人和采购人签约那天算起,项目分 3 年、分阶段交付验收。
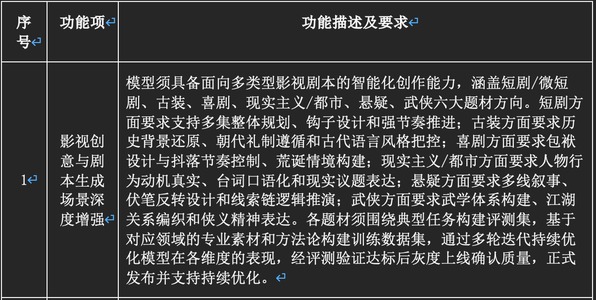
公告把整套项目的核心写在最前面,就是横店影视大模型。
围着它,横店要搭一套把数据、模型和应用串起来的技术体系。
这笔钱要买一整套影视大模型
最重的一块,是横店影视大模型服务系统。
它得在通用大模型的基础上做垂类精调。再长出一个影视专属的模型。
要突破的能力也不轻。镜头语言怎么理解,角色情绪怎么建模,多模态怎么协同生成,都在任务清单上。
覆盖的场景铺得很开。剧本创作,分镜生成,数字角色,声音生成。服化道设计,场景选景,特效后期。基本把一条影视制作的流水线走了一遍。
官方给的指标,是 7 个覆盖全流程的垂类模型,外加 20 个专项场景模型。
除它之外,项目还要补上资产运营、创作赋能这些系统,外加安全底座和算力租赁。
数据是更卡脖子的一环
模型之外,数据的胃口也不小。
项目要求围绕横店的核心场景,搭一套高质量数据集。
方向列了九个。影视基地实景,数字群演,自有版权的数字艺人,服化道供应链。古装各朝代的服装发型妆容,历代农耕器具,还有场景评测。
数量上给了硬指标,建成不少于 9 个行业高质量数据集。
预训练数据不少于 500 亿 Token。指令微调数据不少于 100 万条。强化学习偏好数据不少于 3 万组。基准测试数据不少于 1 万条。
近三年的数据占比不能低于 40%。模态要覆盖文本、图像,以及视频和音频。
还有一块叫影视可信数据空间。
说白了,就是让影视数据在授权、确权和流通过程里可管可控。平台要提供注册登录,开放门户,供需对接,开发运营这些服务。盯住的是版权保护和合规使用这两件事。
连性能指标都写死了
公告连硬指标都一条条列了出来。
推理服务要支持弹性扩缩容,峰值负载下系统可用性不低于 99.5%。
数据处理平台要扛住 TB 级的数据量,单任务标注的吞吐不低于 500 条每小时。
标注系统要支持 100 人同时在线,文本和图像类数据的加载响应不超过 3 秒。
它还得通过连续 24 小时的满负载测试。跑测试时不能崩,不能丢数据。
处理器利用率不超过 80%,内存利用率不超过 75%。
这也不是火山引擎第一次接这类活。
今年 9 月,它还拿下北京广播电视台的一个项目。内容是 Seedance 系列的调用词元采购,中标金额 300 万元。
放眼看,字节在多模态这条路上已经是核心玩家。
它的产品迭代,正踩中影视工业化从概念预演到成片落地的需求。
视频创作模型 Seedance 系列,图像创作模型 Seedream 系列。它把图像生成、视频生成,连同后期剪辑和分发串成一条链路。
